

Django集成Scrapy爬虫实现数据自动入库教程

本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
Django与Scrapy项目结构初始化
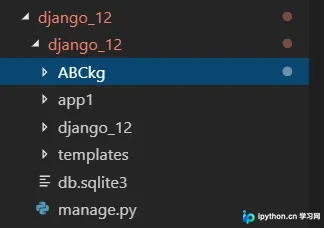
首先在Django项目的根目录下创建Scrapy爬虫项目。假设Django项目名称为django_12,创建的Scrapy爬虫项目名为ABCkg,而Django中用于处理数据的子应用名为app1。
Scrapy与Django环境配置
接下来,需要在Scrapy项目的settings.py文件中进行配置,以允许Scrapy与Django环境交互。具体代码如下:
import os
import sys
sys.path.append(os.path.dirname(os.path.abspath('.')))
os.environ['DJANGO_SETTINGS_MODULE'] = 'django_12.settings'  # 项目名.settings
import django
django.setup()
编写Scrapy爬虫逻辑
随后编写具体的爬虫逻辑,以项目ABCkg为例,创建文件abckg.py。该文件定义了爬虫的名称、允许爬取的域名范围以及起始URL,并实现了解析函数来提取标题和链接,进而请求详情页获取内容。
# -*- coding: utf-8 -*-
import scrapy
from ABCkg.items import AbckgItem

class AbckgSpider(scrapy.Spider):
  name = 'abckg'  #爬虫名称
  allowed_domains = ['www.abckg.com'] # 允许爬取的范围
  start_urls = ['http://www.abckg.com/'] # 第一次请求的地址
  def parse(self, response):
    print('返回内容:{}'.format(response))
    """
    解析函数
    :param response: 响应内容
    :return:
    """
    listtile = response.xpath('//*[@id="container"]/div/div/h2/a/text()').extract()
    listurl = response.xpath('//*[@id="container"]/div/div/h2/a/@href').extract()

    for index in range(len(listtile)):
      item = AbckgItem()
      item['title'] = listtile[index]
      item['url'] = listurl[index]
      yield scrapy.Request(url=listurl[index],callback=self.parse_content,method='GET',dont_filter=True,meta={'item':item})
    # 获取下一页
    nextpage = response.xpath('//*[@id="container"]/div[1]/div[10]/a[last()]/@href').extract_first()
    print('即将请求:{}'.format(nextpage))
    yield scrapy.Request(url=nextpage,callback=self.parse,method='GET',dont_filter=True)
    # 获取详情页
  def parse_content(self,response):
    item = response.meta['item']
    item['content'] = response.xpath('//*[@id="post-1192"]/dd/p').extract()
    print('内容为:{}'.format(item))
    yield item
集成Django模型到Scrapy Item
为了让Scrapy能够直接使用Django的数据模型,需要在Scrapy的item.py中引入Django模型类。这通常需要通过pip安装scrapy-djangoitem库。
pip install scrapy-djangoitem
from app1 import models
from scrapy_djangoitem import DjangoItem

class AbckgItem(DjangoItem):
  # define the fields for your item here like:
  # name = scrapy.Field()      # 普通scrapy爬虫写法
  # title = scrapy.Field()
  # url = scrapy.Field()
  # content = scrapy.Field()
  django_model = models.ABCkg   # 注入django项目的固定写法,必须起名为django_model =django中models.ABCkg表
数据入库管道实现
在Scrapy的pipelines.py中,我们需要调用Django模型实例的save()方法,从而将抓取到的数据保存到数据库中。
import json
from pymongo import MongoClient
# 用于接收parse函数发过来的item
class AbckgPipeline(object):
  # i = 0
  def open_spider(self,spider):
    # print('打开文件')
    if spider.name == 'abckg':
      self.f = open('abckg.json',mode='w')
  def process_item(self, item, spider):
    # # print('ABC管道接收:{}'.format(item))
    # if spider.name == 'abckg':
    #   self.f.write(json.dumps(dict(item),ensure_ascii=False))
    # # elif spider.name == 'cctv':
    # #   img = requests.get(item['img'])
    # #   if img != '':
    # #     with open('图片\%d.png'%self.i,mode='wb')as f:
    # #       f.write(img.content)
    # #   self.i += 1
    item.save()
    return item  # 将item传给下一个管道执行
  def close_spider(self,spider):
    # print('关闭文件')
    self.f.close()
定义Django数据模型
在Django项目的models.py中定义一个模型类,其字段需对应爬取到的数据(如标题、网址、内容),并根据实际需求选择合适的字段类型和最大长度。
class ABCkg(models.Model):
  title = models.CharField(max_length=30,verbose_name='标题')
  url = models.CharField(max_length=100,verbose_name='网址')
  content = models.CharField(max_length=200,verbose_name='内容')
  class Meta:
    verbose_name_plural = '爬虫ABCkg'
  def __str__(self):
    return self.title
启动爬虫与验证结果
配置完成后,通过命令行启动爬虫,命令格式为:scrapy crawl 爬虫名称。
爬虫运行成功并将数据存入数据库后,登录Django的admin管理后台,即可看到爬取并保存的数据。
至此,Django结合Scrapy爬取数据并入库的示例介绍完毕。如需了解更多相关技术内容,可查阅本站过往文章或关注后续更新。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









