

Python爬虫中urllib与urllib3的区别详解

本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
urllib库
urllib是Python内置的标准网络请求库,主要包含四个核心模块。
- urllib.request:负责发起网络请求。
- urllib.parse:用于解析和处理URL。
- urllib.error:处理由request模块引发的异常。
- urllib.robotparser:用于解析网站的robots.txt文件。
urllib.request模块
request模块主要用于构造和发送网络请求,支持添加Headers、Proxy等参数,可模拟浏览器的请求行为。
- 发起网络请求
- 操作Cookie
- 添加Headers
- 使用代理
关于urllib.request.urlopen参数的介绍
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
urlopen是一个发送网络请求的简单方法,接收字符串格式的URL并返回响应结果。
先写一个简单的例子:
from urllib import request
response = request.urlopen(url='http://www.httpbin.org/get')
print(response.read().decode())
urlopen默认发送GET请求,当传入data参数时,则发起POST请求。data参数可以是字节类型、类文件对象或可迭代对象。
from urllib import request
response = request.urlopen(url='http://www.httpbin.org/post',
                           data=b'username=q123&password=123')
print(response.read().decode())
还可以设置超时时间,若请求超过设定时间则抛出异常。未指定timeout时使用系统默认值,该参数仅对http、https和ftp连接有效,单位为秒,例如设置timeout=0.1表示超时时间为0.1秒。
from urllib import request
response = request.urlopen(url='https://www.baidu.com/',timeout=0.1)
Request对象
虽然urlopen能发起基本请求,但其参数有限。如需构建更完整的请求,可使用功能更强大的Request对象。
1. 请求头添加
通过urllib发送的请求默认包含Headers: “User-Agent”:“Python-urllib/3.6”,表明请求由urllib发出。对于验证User-Agent的网站,需自定义Headers以伪装身份。
from urllib import request
headers ={
    'Referer': 'https://www.baidu.com/s?ie=utf-8&f=3&rsv_bp=1&tn=baidu&wd=python%20urllib%E5%BA%93&oq=python%2520urllib%25E5%25BA%2593&rsv_pq=947af0af001c94d0&rsv_t=66135egC273yN5Uj589q%2FvA844PvH9087sbPe9ZJsjA8JA10Z2b3%2BtWMpwo&rqlang=cn&rsv_enter=0&prefixsug=python%2520urllib%25E5%25BA%2593&rsp=0',
     'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36'
}
response = request.Request(url='https://www.baidu.com/',headers=headers)
response = request.urlopen(response)
print(response.read().decode())
2. 操作cookie
在爬虫开发中,Cookie处理至关重要。urllib处理Cookie的示例如下:
from urllib import request
from http import cookiejar
# 创建一个cookie对象
cookie = cookiejar.CookieJar()

# 创一个cookie处理器
cookies = request.HTTPCookieProcessor(cookie)

# 以它为参数,创建opener对象
opener = request.build_opener(cookies)
# 使用这个opener 来发请求
res =opener.open('https://www.baidu.com/')

print(cookies.cookiejar)
3. 设置代理
爬虫运行中常遇IP被封情况,此时需使用IP代理。urllib设置IP代理的示例如下:
from urllib import request
url ='http://httpbin.org/ip'

#代理地址
proxy ={'http':'172.0.0.1:3128'}

# 代理处理器
proxies =request.ProxyBasicAuthHandler(proxy)

# 创建opener对象
opener = request.build_opener(proxies)

res =opener.open(url)
print(res.read().decode())
urlib库中的类或方法在发送网络请求后,均返回urllib.response对象,包含请求数据及相关属性和方法,用于处理返回结果。
- read():获取响应数据,仅能调用一次。
- readline():读取一行数据。
- info():获取响应头信息。
- geturl():获取访问的URL。
- getcode():返回状态码。
urllib.parse模块
parse.urlencode():发送请求时常需传递多个参数,使用字符串拼接较麻烦,parse.urlencode()用于拼接URL参数。
from urllib import parse
params = {'wd':'测试', 'code':1, 'height':188}
res = parse.urlencode(params)
print(res)
打印结果为wd=%E6%B5%8B%E8%AF%95&code=1&height=188
也可通过parse.parse_qs()方法将其转换回字典。
print(parse.parse_qs('wd=%E6%B5%8B%E8%AF%95&code=1&height=188'))
urllib.error模块
error模块负责处理异常,若请求出错,可通过该模块处理,主要包含URLError和HTTPError。
URLError:是error异常模块的基类,request模块产生的异常均可由此类处理。
HTTPError:是URLError的子类,主要包含三个属性。
- Code:请求的状态码。
- reason:错误的原因。
- headers:响应的报头。
from urllib import request,error
try:
    response = request.urlopen("http://pythonsite.com/1111.html")
except error.HTTPError as e:
    print(e.reason)
    print(e.code)
    print(e.headers)
except error.URLError as e:
    print(e.reason)

else:
    print("reqeust successfully")
urllib.robotparse模块
robotparse模块负责处理爬虫协议文件,解析robots.txt。
Robots协议(也称爬虫协议、机器人协议)全称“网络爬虫排除标准”(Robots Exclusion Protocol),网站通过该协议告知搜索引擎哪些页面可抓取,哪些不可抓取。
网络库urllib3
urllib3比urllib库更强大,目前许多原生系统已开始使用urllib3。
urllib3具有如下优点:
- 支持HTTP和SOCKS代理。
- 支持压缩编码。
- 100%测试覆盖率。
- 具有连接池。
- 线程安全。
- 客户端SSL/TLS验证。
- 协助处理重复请求和HTTP重定位。
- 使用multipart编码上传文件。
因urllib3非Python标准库,使用前需下载安装,具体命令如下:
pip install urllib3
#或
conda install urllib3
下面,我们来讲解urllib3库的使用方式。
网络请求
GET请求
首先,在使用urllib3库进行网络请求时,需创建PoolManager类的实例,该类用于管理连接池。
下面,我们来通过urllib访问百度,并返回查询的结果,示例如下:
import urllib3

http = urllib3.PoolManager()
url = 'http://www.baidu.com/s'
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'
}
response = http.request('GET', url, fields={'wd': '机器学习'}, headers=headers)
result = response.data.decode('UTF-8')
print(result)
运行之后,效果如下:
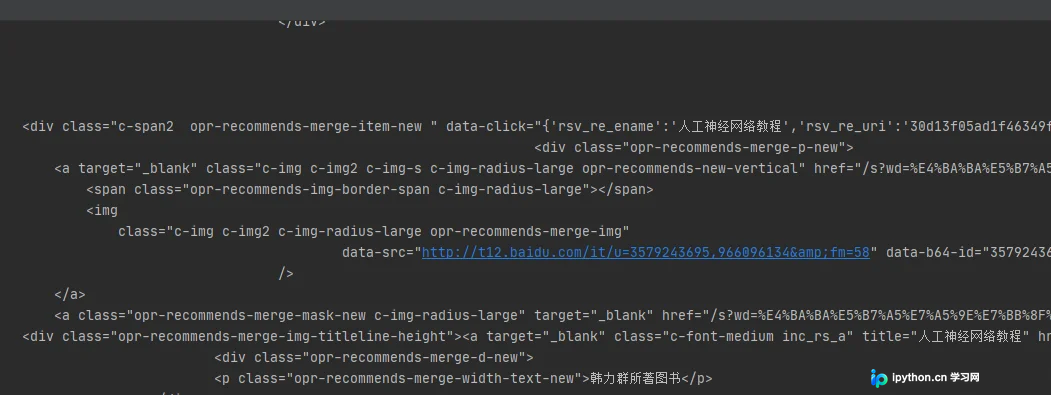
这里,我们通过fields参数指定GET的请求字段。不过,这里先一步讲解了请求头,其实是百度有安全机制,读者可以去掉headers参数试试。会返回百度的安全验证页面。
POST请求
如果需要向服务器提交表单或者比较复杂的数据,就需要使用到POST请求。POST请求比较简单,仅仅只是将请求的第一个参数改为“POST”即可。
示例如下:
import urllib3

http = urllib3.PoolManager()
url = 'http://httpbin.org/post'
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'
}
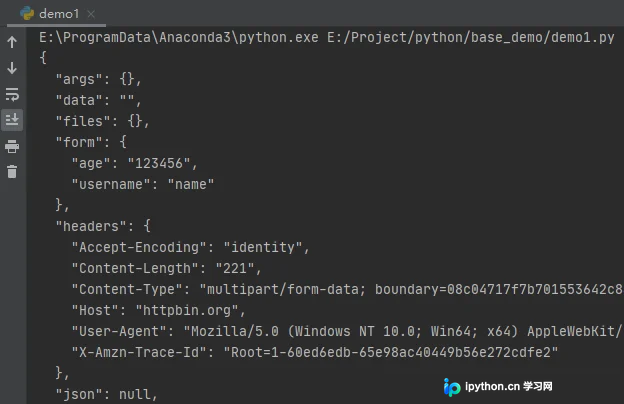
response = http.request('POST', url, fields={'username': 'name', 'age': '123456'}, headers=headers)
result = response.data.decode('UTF-8')
print(result)
运行之后,返回如下数据:
HTTP响应头
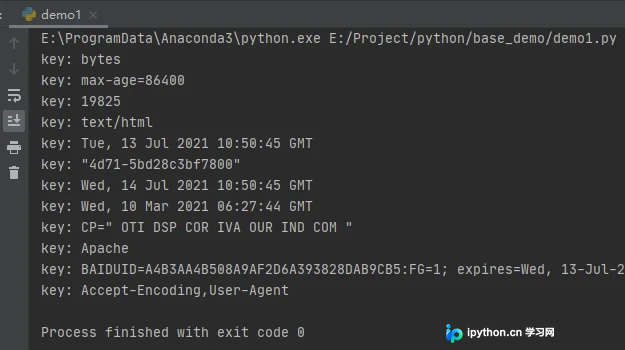
使用urllib3库进行网络访问时,其返回的HTTPResponse。默认有一些携带的参数,其中就包括info方法。它能返回响应头数据,示例如下:
import urllib3

http = urllib3.PoolManager()
url = 'http://www.baidu.com/s'
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'
}
response = http.request('POST', url, fields={'wd': '机器学习'}, headers=headers)
for key in response.info().keys():
    print('key:',response.info()[key])
运行之后,返回的响应数据如下:
上传文件
首先,我们需要简单的实现一个文件上传的服务器代码,这里我们使用Flask搭建一个简单的服务器Python程序,代码如下:
import flask
import os

UPLOAD_FILE = 'uploads'
app = flask.Flask(__name__)
@app.route('/', methods=['POST'])
def upload_file():
    file = flask.request.files['file']
    if file:
        file.save(os.path.join(UPLOAD_FILE, os.path.basename(file.filename)))
        return '文件上传成功'
    else:
        return '文件上传失败'

if __name__ == '__main__':
    app.run()
运行之后,它会一直等待客户端上传文件。
这个时候,我们再来实现urllib3是如何上传文件的,示例如下:
import urllib3

http = urllib3.PoolManager()
with open('1.jpg', 'rb') as f:
    fileData = f.read()
url = 'http://127.0.0.1:5000'
response = http.request('POST', url, fields={'file': ('1.jpg', fileData, 'image/jpeg')})
print(response.data.decode('UTF-8'))
默认flask搭建的服务器,其接口为5000,也就是通过127.0.0.1:5000进行访问。运行之后,就会在uploads文件夹下创建一个1.jpg的图片。
同时,控制台会输出文件上传成功,而服务器会返回状态码200。
这里,上传文件就1一个键值对,其中file代表服务器上传文件的字段。值的元组里,fileData为文件的二进制形式,'image/jpeg'代表上传文件的格式(可以省略)。
超时处理
urllib3库其HTTP的底层都是基于Socket实现的,而Socket超时又分为连接超时与读超时。
其中,连接超时表示在连接的过程中,由于服务器的问题或域名弄错了,而导致的无法连接的情况抛出的异常。
读超时表示从服务器读取数据时由于服务器的问题,导致长时间无法正常读取数据而导致的异常。
通常,我们超时的设置有2种,一种是通过http.request(timeout)进行设置,一种是通过PoolManager()连接池进行设置。示例如下:
from urllib3 import *

http = PoolManager(timeout=Timeout(connect=2.0, read=2.0))
with open('1.jpg', 'rb') as f:
    fileData = f.read()
url = 'http://127.0.0.1:5000'
try:
    response = http.request('POST', url, timeout=Timeout(connect=2.0, read=4.0))
    print(response.data.decode('UTF-8'))
except Exception as e:
    print(e)
需要注意的是,通过连接池PoolManager进行设置的超时,是全局超时时间,哪怕你后边的请求不设置,也是默认使用的这个超时。如果同时设置了request的超时,那么以request为准。
到此这篇关于Python爬虫中urllib3与urllib的区别是什么的文章就介绍到这了,更多相关Python urllib3 urllib内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









