

Scrapy 中间件详解:下载器与 Spider 中间件的配置与实现

本文深入解析 Scrapy 框架中的两类核心中间件:下载器中间件(Downloader Middleware)与 Spider 中间件。详细说明了中间件的注册顺序、执行流程及关键方法(process_request、process_response、process_exception)的行为差异。提供了自定义 User-Agent 轮换、代理 IP 切换及基于状态码的重试中间件代码示例,并介绍了 Spider 中间件对 Item 和 Request 的处理逻辑,帮助开发者构建更稳健的爬虫系统。
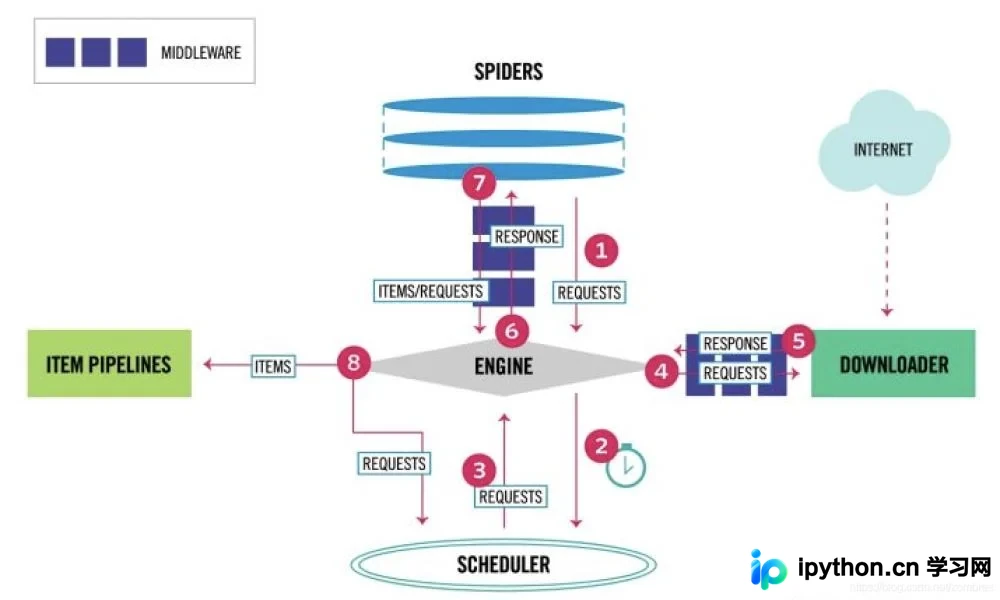
Scrapy 架构概览
一、下载器中间件(Downloader Middleware)
如前文图示编号 4、5 所示,下载器中间件构成了处理 Scrapy 请求(Request)和响应(Response)的钩子框架。它允许开发者在请求发出前设置代理 IP、自定义 Header 等,或在接收响应时检测 HTTP 状态码等。
Scrapy 框架默认内置了一系列下载器中间件。
{
    'scrapy.downloadermiddlewares.robotstxt.RobotsTxtMiddleware': 100,
    'scrapy.downloadermiddlewares.httpauth.HttpAuthMiddleware': 300,
    'scrapy.downloadermiddlewares.downloadtimeout.DownloadTimeoutMiddleware': 350,
    'scrapy.downloadermiddlewares.defaultheaders.DefaultHeadersMiddleware': 400,
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': 500,
    'scrapy.downloadermiddlewares.retry.RetryMiddleware': 550,
    'scrapy.downloadermiddlewares.ajaxcrawl.AjaxCrawlMiddleware': 560,
    'scrapy.downloadermiddlewares.redirect.MetaRefreshMiddleware': 580,
    'scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware': 590,
    'scrapy.downloadermiddlewares.redirect.RedirectMiddleware': 600,
    'scrapy.downloadermiddlewares.cookies.CookiesMiddleware': 700,
    'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 750,
    'scrapy.downloadermiddlewares.stats.DownloaderStats': 850,
    'scrapy.downloadermiddlewares.httpcache.HttpCacheMiddleware': 900,
}
上述列表即为默认启用的下载器中间件,各中间件的具体功能可参考官方文档:Scrapy download-middleware。
自定义下载器中间件
在实际开发中,我们常需编写自定义下载器中间件,例如接入代理池或随机更换 User-Agent。要启用自定义中间件,需在 settings 配置文件中注册实现类,配置方式如下:
DOWNLOADERMIDDLEWARES = {
    'myproject.middlewares.Custom_A_DownloaderMiddleware': 543,
    'myproject.middlewares.Custom_B_DownloaderMiddleware': 643,
    'myproject.middlewares.Custom_B_DownloaderMiddleware': None,
}
配置值是一个字典(DICT),Key 为自定义类的路径,Value 为执行优先级数字。数字越小,中间件越靠近引擎,process_request() 方法优先执行;数字越大,越靠近下载器,process_response() 方法优先执行。若需禁用某个中间件,将其值设为 None 即可。(注:若多个下载器之间无强制先后依赖关系,数字大小对执行顺序影响不大)。
实现下载器中间件需重写以下核心方法:
- 针对请求处理,实现 process_request(request, spider);
- 针对响应处理,实现 process_response(request, response, spider);
- 以及异常处理,实现 process_exception(request, exception, spider)。
process_request(request, spider)
process_request 方法可以返回 None、Response 对象、Request 对象或抛出 IgnoreRequest 异常,具体行为如下:
- 若返回 None,Scrapy 将继续处理该 Request,执行其他已安装中间件的响应方法,直到调用合适的下载器处理函数(downloader handler)。此时 Request 被执行,Response 被下载。
- 若返回 Response 对象,Scrapy 将不再调用其他 process_request() 或 process_exception() 方法,也不再调用下载函数,而是直接返回该 Response。此时,所有已安装中间件的 process_response() 方法将在每个 Response 返回时被调用。
- 若返回 Request 对象,Scrapy 停止调用当前的 process_request 方法,并重新调度返回的 Request。当新 Request 被执行后,相应的中间件链将根据下载的 Response 被调用。
- 若抛出 IgnoreRequest 异常,将触发已安装下载中间件的 process_exception() 方法。如果没有任何方法处理该异常,则调用 Request.errback 方法。若无代码处理抛出的异常,则该异常被忽略且不记录(这与其他异常的处理方式不同)。
通常情况下,返回 None 最为常见,这表示继续执行后续的爬虫逻辑。
process_response(request, response, spider)
当下载器完成 HTTP 请求并将响应传递给引擎时调用此方法。该方法返回 Response、Request 或 IgnoreRequest 中的一种。
- 若返回 Response 对象,它将被下一个中间件的 process_response() 处理。
- 若返回 Request 对象,中间链停止,随后返回的 Request 会被重新调度下载。
- 若抛出 IgnoreRequest,将调用回调函数 Request.errback 进行处理;若未被处理,则该异常被忽略。
process_exception(request, exception, spider)
当下载处理器(download handler)或 process_request() 抛出异常(包括 IgnoreRequest 异常)时,Scrapy 调用 process_exception()。通常返回 None,表示继续处理异常链。
from_crawler(cls, crawler)
该类方法通常是访问 settings 配置和 signals 信号的入口函数。
以下两个示例展示了如何编写更换 User-Agent 和代理 IP 的下载器中间件:
# setting中设置
USER_AGENT_LIST = [ \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/22.0.1207.1 Safari/537.1", \
    "Mozilla/5.0 (X11; CrOS i686 2268.111.0) AppleWebKit/536.11 (KHTML, like Gecko) Chrome/20.0.1132.57 Safari/536.11", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1092.0 Safari/536.6", \
    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1090.0 Safari/536.6", \
    "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/19.77.34.5 Safari/537.1", \
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.9 Safari/536.5", \
    "Mozilla/5.0 (Windows NT 6.0) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.36 Safari/536.5", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_8_0) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \
    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.0 Safari/536.3", \
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24", \
    "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/43.0.2357.132 Safari/537.36", \
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:41.0) Gecko/20100101 Firefox/41.0"
]

PROXIES = [
    '1.85.220.195:8118',
    '60.255.186.169:8888',
    '118.187.58.34:53281',
    '116.224.191.141:8118',
    '120.27.5.62:9090',
    '119.132.250.156:53281',
    '139.129.166.68:3128'
]
代理 IP 中间件实现
import random

class Proxy_Middleware():

    def __init__(self, crawler):
        self.proxy_list = crawler.settings.PROXY_LIST
        self.ua_list = crawler.settings.USER_AGENT_LIST

	@classmethod
	def from_crawler(cls, crawler):
	    return cls(crawler)

    def process_request(self, request, spider):
        try:
			ua = random.choice(self.ua_list)
        	request.headers.setdefault('User-Agent', ua)

            proxy_ip_port = random.choice(self.proxy_list)
            request.meta['proxy'] = 'http://' + proxy_ip_port
        except request.exceptions.RequestException:
            spider.logger.error('some error happended!')
重试中间件实现
在使用代理时,有时会因远程拒绝或超时等错误导致请求失败。此时我们需要更换代理 IP 并重试,可通过重写 scrapy.downloadermiddlewares.retry.RetryMiddleware 来实现。
from scrapy.downloadermiddlewares.retry import RetryMiddleware
from scrapy.utils.response import response_status_message

class My_RetryMiddleware(RetryMiddleware):
	def __init__(self, crawler):
        self.proxy_list = crawler.settings.PROXY_LIST
        self.ua_list = crawler.settings.USER_AGENT_LIST

	@classmethod
	def from_crawler(cls, crawler):
	    return cls(crawler)

    def process_response(self, request, response, spider):
        if request.meta.get('dont_retry', False):
            return response

        if response.status in self.retry_http_codes:
            reason = response_status_message(response.status)
            try:
                ua = random.choice(self.ua_list)
	        	request.headers.setdefault('User-Agent', ua)

	            proxy_ip_port = random.choice(self.proxy_list)
	            request.meta['proxy'] = 'http://' + proxy_ip_port
            except request.exceptions.RequestException:
                spider.logger.error('获取讯代理ip失败!')

            return self._retry(request, reason, spider) or response
        return response
# scrapy中对接selenium

from scrapy.http import HtmlResponse
from selenium import webdriver
from selenium.common.exceptions import TimeoutException
from gp.configs import *


class ChromeDownloaderMiddleware(object):

    def __init__(self):
        options = webdriver.ChromeOptions()
        options.add_argument('--headless')  # 设置无界面
        if CHROME_PATH:
            options.binary_location = CHROME_PATH
        if CHROME_DRIVER_PATH:  # 初始化Chrome驱动
            self.driver = webdriver.Chrome(chrome_options=options, executable_path=CHROME_DRIVER_PATH)
        else:
            self.driver = webdriver.Chrome(chrome_options=options)  # 初始化Chrome驱动

    def __del__(self):
        self.driver.close()

    def process_request(self, request, spider):
        try:
            print('Chrome driver begin...')
            self.driver.get(request.url)  # 获取网页链接内容
            return HtmlResponse(url=request.url, body=self.driver.page_source, request=request, encoding='utf-8',
                                status=200)  # 返回HTML数据
        except TimeoutException:
            return HtmlResponse(url=request.url, request=request, encoding='utf-8', status=500)
        finally:
            print('Chrome driver end...')
二、Spider 中间件(Spider Middleware)
如文章首图所示,Spider 中间件用于处理 Response 以及 Spider 生成的 Item 和 Request。
启动自定义 Spider 中间件前,必须先开启 settings 中的相关配置。
SPIDER_MIDDLEWARES = {
    'myproject.middlewares.CustomSpiderMiddleware': 543,
    'scrapy.spidermiddlewares.offsite.OffsiteMiddleware': None,
}
同样地,数字越小越靠近引擎,process_spider_input() 优先处理;数字越大越靠近 Spider,process_spider_output() 优先处理。关闭中间件使用 None。
编写自定义 Spider 中间件
process_spider_input(response, spider)
当 Response 通过 Spider 中间件时调用此方法,通常返回 None。
process_spider_output(response, result, spider)
当 Spider 处理 Response 后返回 result 时调用此方法。必须返回 Request 或 Item 对象的可迭代对象,通常直接返回 result。
process_spider_exception(response, exception, spider)
当 Spider 中间件抛出异常时调用此方法,返回 None 或包含 Request、dict、Item 的可迭代对象。
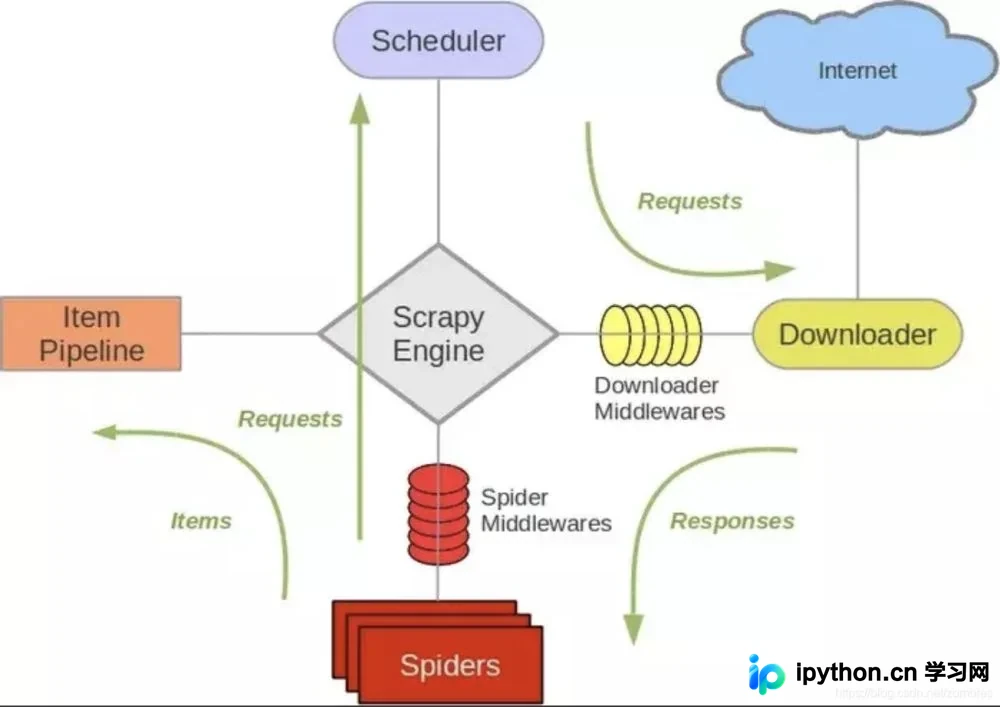
补充一张示意图:
参考文档:
https://docs.scrapy.org/en/latest/topics/spider-middleware.html
https://docs.scrapy.org/en/latest/topics/downloader-middleware.html
至此,关于 Scrapy 中间件(Middleware)的介绍已完成。如需了解更多 Scrapy 中间件相关内容,请搜索本站历史文章或继续浏览相关文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









