编写Python爬虫抓取豆瓣电影TOP100及图片资源的方法
本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。
2026-10-12
4

本文演示如何使用现代Python工具编写网页爬虫,以豆瓣电影Top100为例,讲解构建URL地址池、伪造请求头、利用BeautifulSoup稳定解析HTML结构,并将提取到的电影名称与相关图片安全保存至本地。全文已修复原代码的版本缺陷,提供更可靠的执行逻辑与反爬规避建议。
本文介绍如何在 Scrapy-Redis 框架下实现 POST 请求的数据采集。通过重写 make_request_from_data 方法,将默认的 GET 请求转换为 POST 请求,并配置 Redis 调度器与去重过滤器。文章提供了 settings.py 配置、Spider 代码及 Redis 数据写入示例,帮助开发者解决分布式爬虫中 POST 请求的处理问题。
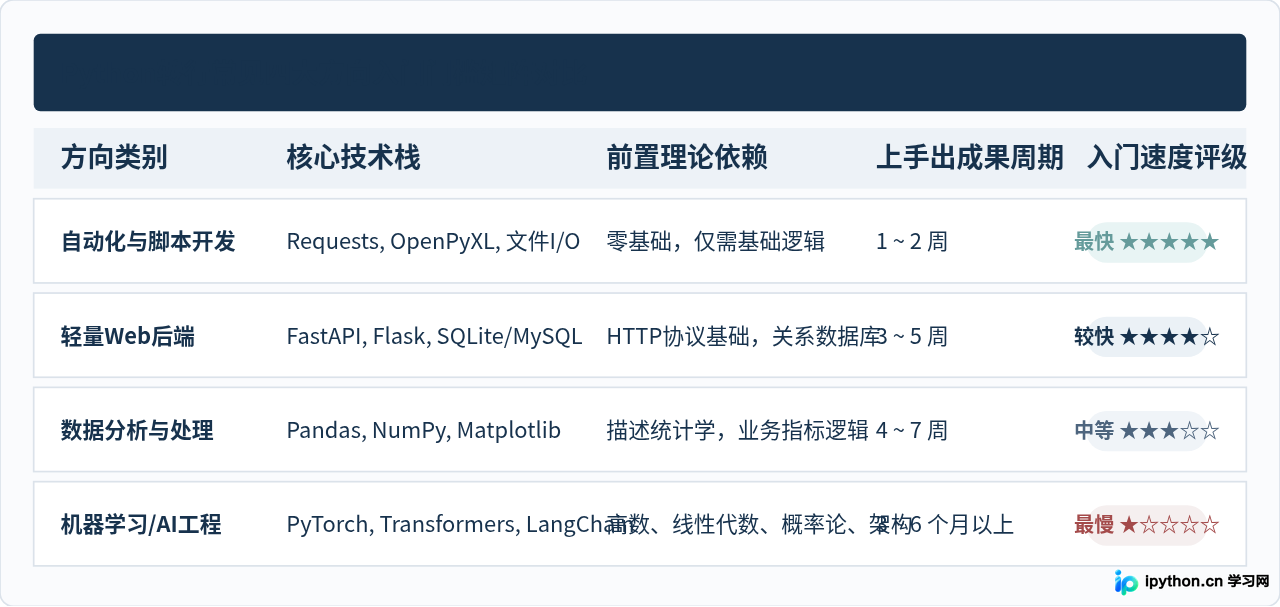
针对零基础转行Python开发群体,客观对比自动化办公、网络爬虫、Web后端与数据分析等主流方向的入门门槛、学习周期与上手路径,给出切实可行的转型建议。