

Python读取配置文件-ConfigParser的二次封装方法

发布时间:2026-10-16| 4人浏览过
本文介绍如何利用Python内置的ConfigParser模块读取ini格式配置文件,并通过二次封装实现灵活配置管理。通过对比绝对路径与相对路径读取方式,演示了如何将数据库连接信息、爬虫参数等配置抽离至独立文件。文章提供了完整的类封装代码,涵盖读取配置、连接MySQL及执行SQL操作,帮助开发者提升项目配置的灵活性与可维护性。
Python读取配置文件-ConfigParser二次封装方法
直接上代码
test.conf
[database]
connect = mysql
sleep = no
test = yes
config.py
# -*- coding:utf-8 -*-
__author__ = 'guoqianqian'
import os
import ConfigParser
import os
current_dir = os.path.abspath(os.path.dirname(__file__))
class OperationalError(Exception):
    """operation error."""
class Dictionary(dict):
    """ custom dict."""
    def __getattr__(self, key):
        return self.get(key, None)
    __setattr__ = dict.__setitem__
    __delattr__ = dict.__delitem__
class Config:
    def __init__(self, file_name="test", cfg=None):
        """
        @param file_name: file name without extension.
        @param cfg: configuration file path.
        """
        env = {}
        for key, value in os.environ.items():
            if key.startswith("TEST_"):
                env[key] = value
        config = ConfigParser.ConfigParser(env)
        if cfg:
            config.read(cfg)
        else:
            config.read(os.path.join(current_dir, "conf", "%s.conf" % file_name))
        for section in config.sections():
            setattr(self, section, Dictionary())
            for name, raw_value in config.items(section):
                try:
                    # Ugly fix to avoid '0' and '1' to be parsed as a
                    # boolean value.
                    # We raise an exception to goto fail^w parse it
                    # as integer.
                    if config.get(section, name) in ["0", "1"]:
                        raise ValueError
                    value = config.getboolean(section, name)
                except ValueError:
                    try:
                        value = config.getint(section, name)
                    except ValueError:
                        value = config.get(section, name)
                setattr(getattr(self, section), name, value)
    def get(self, section):
        """Get option.
        @param section: section to fetch.
        @return: option value.
        """
        try:
            return getattr(self, section)
        except AttributeError as e:
            raise OperationalError("Option %s is not found in "
                                         "configuration, error: %s" %
                                         (section, e))
if __name__ == "__main__":
    conf = Config()
    print conf.get("database").connect
    print conf.get("database").sleep
    print conf.get("database").test
执行结果
mysql False True
目录结构
demo
    conf
        test.conf
    config.py
读取配置文件与简单封装实现
此前曾进行过将爬虫数据写入数据库的练习,本次尝试将数据库连接信息提取至ini格式的配置文件。这样做的好处是可以在配置文件中定义多个数据库实例,便于灵活切换(此外,配置文件也可用于存储邮箱、URL等其他信息)。
1. configparser模块简介
Python标准库中自带的configparser模块用于读取配置文件,其文件格式类似于Windows系统中的ini文件。
使用前需确保已安装该模块,通常通过pip安装即可。
2. configparser读取文件的基本方法
(1) 新建一个config.ini文件,内容如下
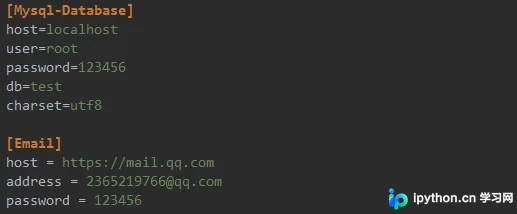
(2) 新建一个readconfig.py文件,用于读取配置文件中的信息
import configparser
cf = configparser.ConfigParser()
cf.read("E:\Crawler\config.ini")  # 读取配置文件,如果写文件的绝对路径,就可以不用os模块
secs = cf.sections()  # 获取文件中所有的section(一个配置文件中可以有多个配置,如数据库相关的配置,邮箱相关的配置,                        每个section由[]包裹,即[section]),并以列表的形式返回
print(secs)
options = cf.options("Mysql-Database")  # 获取某个section名为Mysql-Database所对应的键
print(options)
items = cf.items("Mysql-Database")  # 获取section名为Mysql-Database所对应的全部键值对
print(items)
host = cf.get("Mysql-Database", "host")  # 获取[Mysql-Database]中host对应的值
print(host)
上述代码运行结果如下,可与config.ini文件内容进行对比验证

3. 引入os模块,使用相对目录读取配置文件
工程目录结构如下:
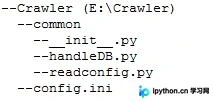
readconfig.py代码实现:
import configparser
import os
root_dir = os.path.dirname(os.path.abspath('.'))  # 获取当前文件所在目录的上一级目录,即项目所在目录E:\Crawler
cf = configparser.ConfigParser()
cf.read(root_dir+"/config.ini")  # 拼接得到config.ini文件的路径,直接使用
secs = cf.sections()  # 获取文件中所有的section(一个配置文件中可以有多个配置,如数据库相关的配置,邮箱相关的配置,每个section由[]包裹,即[section]),并以列表的形式返回
print(secs)
options = cf.options("Mysql-Database")  # 获取某个section名为Mysql-Database所对应的键
print(options)
items = cf.items("Mysql-Database")  # 获取section名为Mysql-Database所对应的全部键值对
print(items)
host = cf.get("Mysql-Database", "host")  # 获取[Mysql-Database]中host对应的值
print(host)
或者使用os.path.join()函数进行路径拼接
import configparser
import os
root_dir = os.path.dirname(os.path.abspath('.'))  # 获取当前文件所在目录的上一级目录,即项目所在目录E:\Crawler
configpath = os.path.join(root_dir, "config.ini")
cf = configparser.ConfigParser()
cf.read(configpath)  # 读取配置文件
secs = cf.sections()  # 获取文件中所有的section(一个配置文件中可以有多个配置,如数据库相关的配置,邮箱相关的配置,每个section由[]包裹,即[section]),并以列表的形式返回
print(secs)
options = cf.options("Mysql-Database")  # 获取某个section名为Mysql-Database所对应的键
print(options)
items = cf.items("Mysql-Database")  # 获取section名为Mysql-Database所对应的全部键值对
print(items)
host = cf.get("Mysql-Database", "host")  # 获取[Mysql-Database]中host对应的值
print(host)
4. 通过读取配置文件优化爬虫逻辑
重新编写之前使用requests结合正则表达式爬取猫眼电影的示例程序
将读取配置文件的readconfig.py和操作数据库的handleDB.py分别封装为独立的类
readconfig.py具体实现如下
import configparser
import os
class ReadConfig:
    """定义一个读取配置文件的类"""
    def __init__(self, filepath=None):
        if filepath:
            configpath = filepath
        else:
            root_dir = os.path.dirname(os.path.abspath('.'))
            configpath = os.path.join(root_dir, "config.ini")
        self.cf = configparser.ConfigParser()
        self.cf.read(configpath)
    def get_db(self, param):
        value = self.cf.get("Mysql-Database", param)
        return value
if __name__ == '__main__':
    test = ReadConfig()
    t = test.get_db("host")
    print(t)
handleDB.py具体实现如下
# coding: utf-8
# author: hmk
from common.readconfig import ReadConfig
import pymysql.cursors
class HandleMysql:
    def __init__(self):
        self.data = ReadConfig()
    def conn_mysql(self):
        """连接数据库"""
        host = self.data.get_db("host")
        user = self.data.get_db("user")
        password = self.data.get_db("password")
        db = self.data.get_db("db")
        charset = self.data.get_db("charset")
        self.conn = pymysql.connect(host=host, user=user, password=password, db=db, charset=charset)
        self.cur = self.conn.cursor()
    def execute_sql(self, sql, data):
        """执行操作数据的相关sql"""
        self.conn_mysql()
        self.cur.execute(sql, data)
        self.conn.commit()
    def search(self, sql):
        """执行查询sql"""
        self.conn_mysql()
        self.cur.execute(sql)
        return self.cur.fetchall()
    def close_mysql(self):
        """关闭数据库连接"""
        self.cur.close()
        self.conn.close()
if __name__ == '__main__':
    test = HandleMysql()
    sql = "select * from maoyan_movie"
    for i in test.search(sql):
        print(i)
最后的运行文件,调用前面封装好的方法
# coding: utf-8
# author: hmk
import requests
import re
from common import handleDB
class Crawler:
    """定义一个爬虫类"""
    def __init__(self):
        self.db = handleDB.HandleMysql()
    @staticmethod
    def get_html(url, header):
        response = requests.get(url=url, headers=header)
        if response.status_code == 200:
            return response.text
        else:
            return None
    @staticmethod
    def get_data(html, list_data):
        pattern = re.compile(r'<dd>.*?<i.*?>(\d+)</i>.*?'  # 匹配电影排名
                             r'<p class="name"><a.*?data-val=".*?">(.*?)'  # 匹配电影名称
                             r'</a>.*?<p.*?class="releasetime">(.*?)</p>'  # 匹配上映时间
                             r'.*?<i.*?"integer">(.*?)</i>'  # 匹配分数的整数位
                             r'.*?<i.*?"fraction">(.*?)</i>.*?</dd>', re.S)  # 匹配分数小数位
        m = pattern.findall(html)
        for i in m:  # 因为匹配到的所有结果会以列表形式返回,每部电影信息以元组形式保存,所以可以迭代处理每组电影信息
            ranking = i[0]  # 提取一组电影信息中的排名
            movie = i[1]  # 提取一组电影信息中的名称
            release_time = i[2]  # 提取一组电影信息中的上映时间
            score = i[3] + i[4]  # 提取一组电影信息中的分数,这里把分数的整数部分和小数部分拼在一起
            list_data.append([ranking, movie, release_time, score])  # 每提取一组电影信息就放到一个列表中,同时追加到一个大列表里,这样最后得到的大列表就包含所有电影信息
    def write_data(self, sql, data):
        self.db.conn_mysql()
        try:
            self.db.execute_sql(sql, data)
            print('导入成功')
        except:
            print('导入失败')
        self.db.close_mysql()
    def run_main(self):
        start_url = 'http://maoyan.com/board/4'
        depth = 10  # 爬取深度(翻页)
        header = {"Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
                  "Accept-Encoding": "gzip, deflate, sdch",
                  "Accept-Language": "zh-CN,zh;q=0.8",
                  "Cache-Control": "max-age=0",
                  "Connection": "keep-alive",
                  "Host": "maoyan.com",
                  "Referer": "http://maoyan.com/board",
                  "Upgrade-Insecure-Requests": "1",
                  "User-Agent": "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.75 Safari/537.36"}
        for i in range(depth):
            url = start_url + '?offset=' + str(10 * i)
            html = self.get_html(url, header)
            list_data = []
            self.get_data(html, list_data)
            for i in list_data:
                """这里的list_data参数是指正则匹配并处理后的列表数据(是一个大列表,包含所有电影信息,每个电影信息都存在各自的一个列表中;
                对大列表进行迭代,提取每组电影信息,这样提取到的每组电影信息都是一个小列表,然后就可以把每组电影信息写入数据库了)"""
                movie = i  # 每组电影信息,这里可以看做是准备插入数据库的每组电影数据
                sql = "insert into maoyan_movie(ranking,movie,release_time,score) values(%s, %s, %s, %s)"  # sql插入语句
                self.write_data(sql, movie)
if __name__ == '__main__':
    test = Crawler()
    test.run_main()
以上为个人经验分享,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









