

Python Scrapy框架中Request与Response对象详解

发布时间:2026-10-15| 4人浏览过
本文详细介绍Python Scrapy框架中Request和Response对象的核心用法。解析Request对象的url、callback、method等关键参数,演示如何通过FormRequest发送POST请求,并列举Response对象的text、body、xpath等常用属性,帮助开发者掌握Scrapy基础数据交互机制。
一、Request对象
Request对象主要用于发起数据请求,当需要爬取新一页数据时,会重新构建并发送一个请求。该对象的源码类定义位置如
下图所示:
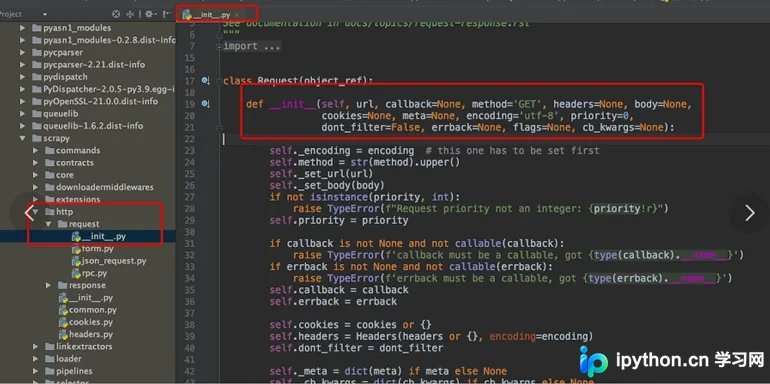
此处列出其源码,该方法包含多个参数:
class Request(object_ref):

    def __init__(self, url, callback=None, method='GET', headers=None, body=None,
                 cookies=None, meta=None, encoding='utf-8', priority=0,
                 dont_filter=False, errback=None, flags=None, cb_kwargs=None):

        self._encoding = encoding  # this one has to be set first
        self.method = str(method).upper()
        self._set_url(url)
        self._set_body(body)
        if not isinstance(priority, int):
            raise TypeError(f"Request priority not an integer: {priority!r}")
        self.priority = priority

        if callback is not None and not callable(callback):
            raise TypeError(f'callback must be a callable, got {type(callback).__name__}')
        if errback is not None and not callable(errback):
            raise TypeError(f'errback must be a callable, got {type(errback).__name__}')
        self.callback = callback
        self.errback = errback

        self.cookies = cookies or {}
        self.headers = Headers(headers or {}, encoding=encoding)
        self.dont_filter = dont_filter

        self._meta = dict(meta) if meta else None
        self._cb_kwargs = dict(cb_kwargs) if cb_kwargs else None
        self.flags = [] if flags is None else list(flags)
下面对各个参数进行简要说明:
url:指定该request对象要请求的URL地址。callback:指定在数据下载完成后执行的回调函数。method:指定请求方法,默认为GET,也可设置为其他HTTP方法。headers:设置请求头,部分固定配置可直接在settings.py中指定,非固定配置可在发送请求时动态指定。body:设置请求体,通常用于传入请求参数。meta:较为常用,用于在不同请求之间传递数据。encoding:指定编码格式,默认为utf-8,一般使用默认值即可。dont_filter:表示是否由调度器过滤,在需要执行多次重复请求时较为常用。errback:指定在发生错误时执行的回调函数。
二、发送POST请求
若需在请求数据时发送POST请求,需使用Request的子类FormRequest来实现。若希望爬虫启动时即发送POST请求,需在爬虫类中重写start_requests(self) 方法,且不再调用start_urls 中定义的url。
三、Response对象
Response对象通常由scrapy自动构建,因此开发者无需关心如何创建Response对象,而应关注如何使用它。Response对象包含多个属性,可用于提取数据。
主要属性如下:
meta:从其他请求传递过来的meta属性,可用于保持多个请求之间的数据连接。encoding:返回字符串编码和解码的格式。text:将返回的数据作为unicode字符串返回。body:将返回的数据作为bytes字符串返回。xpath:提供xpath选择器功能。css:提供css选择器功能。
到此这篇关于python基础之scrapy框架中Request对象和Response对象的介绍的文章就介绍到这了,更多相关Request对象和Response对象的介绍内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









