

Python实现爬虫定时任务的多种方案:从while循环到系统级调度
本文针对Windows任务计划频繁挂起的问题,探讨Python爬虫定时任务的实现方案。首先分析基于while True死循环的简单实现及其在复杂场景下的局限性,如多任务并发、网络稳定性及异常处理等。文章指出该方法适用于低频单次执行场景,后续将介绍更稳健的定时任务解决方案,帮助开发者优化爬虫调度策略。
2026-10-14
5

本文针对Windows任务计划频繁挂起的问题,探讨Python爬虫定时任务的实现方案。首先分析基于while True死循环的简单实现及其在复杂场景下的局限性,如多任务并发、网络稳定性及异常处理等。文章指出该方法适用于低频单次执行场景,后续将介绍更稳健的定时任务解决方案,帮助开发者优化爬虫调度策略。
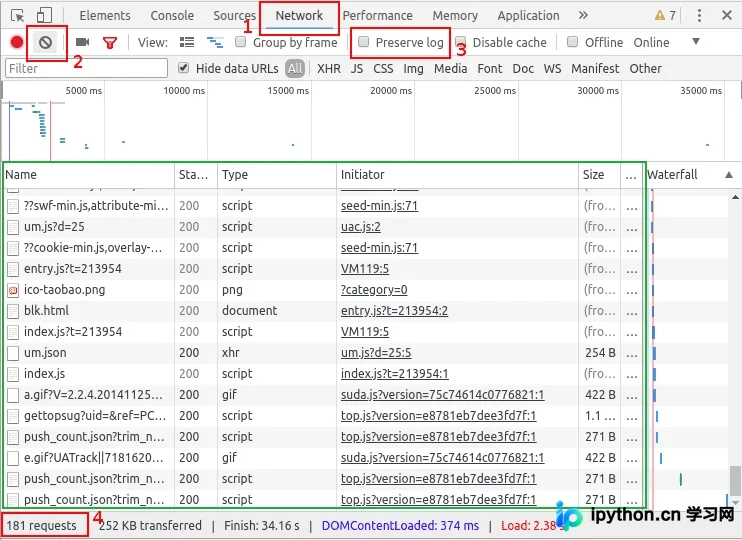
本文详解Python爬虫中Chrome浏览器F12开发者工具的使用。针对网页HTML源码中缺失但页面可见的数据,解析Ajax异步加载原理。通过Network面板筛选请求,利用Headers重建HTTP请求,结合Preview和Response获取目标数据,帮助开发者高效编写爬虫脚本。
本文解析在Python Scrapy爬虫中将数据存入Elasticsearch的两种方法。首先介绍基于elasticsearch-dsl的基础写入,指出其无法控制主键导致重复数据的问题。随后详解第二种方法,通过Elasticsearch客户端指定自定义_id实现覆盖插入,并展示如何在settings.py中注册Pipeline及执行查询操作,适用于ES 5.6.1版本。
本文详细解析Scrapy框架中Spider的四种核心爬取模式。通过具体代码示例,演示如何抓取单页数据、基于预设列表生成多页链接、识别并跟随“下一页”按钮,以及进入子链接提取深层内容。涵盖start_urls配置、parse回调处理及Request对象的使用,帮助开发者掌握不同场景下的爬虫构建技巧。
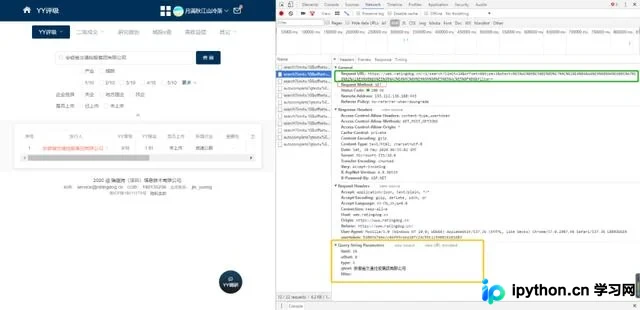
本文介绍使用Python编写爬虫批量获取YY评级分数的方法。通过解析Ajax GET请求URL规律,提取企业名称变量构建请求。重点讲解如何携带登录Cookie维持会话状态,并利用正则表达式从JSON响应中提取评级数据。最终实现将安徽省100多条发债企业数据保存至本地,适用于大规模企业评级信息查询场景。
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文深入解析Python BeautifulSoup库中的核心数据结构。详细讲解如何利用Tag对象获取HTML/XML标签名、读写属性及处理多值属性;介绍NavigableString类用于处理标签内文本及替换操作;阐述BeautifulSoup对象作为文档整体的特性,以及Comment对象在提取注释内容时的应用。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。