

Scrapy框架核心组件与工作流程详解

本文深入解析Scrapy框架的核心组件,包括引擎、调度器、下载器、Spider及管道等,并详细阐述数据在系统中的流动机制与处理流程,帮助开发者理解Scrapy的工作逻辑。
一、为什么使用Scrapy框架?
Scrapy是一个快速且高层次的屏幕抓取与Web抓取框架,广泛应用于数据挖掘、系统监测及自动化检测等场景。该框架设计灵活,允许开发者根据具体需求进行定制化修改与扩展。
二、Scrapy框架各组件详解
1. Scrapy引擎(py Engine):作为系统的控制中心,负责管理所有组件间的数据流,并在特定事件发生时触发相应的动作。
2. 调度器(Scheduler):接收来自引擎的请求,将其加入队列以便后续处理,并将请求重新提交给引擎以进行下一步操作。
3. 下载器(Downloader):负责从互联网获取网页数据,并将获取的数据返回给引擎,随后传递给Spider进行处理。
4. Spiders:这是由用户编写的类,用于分析下载器返回的响应(response),并从中提取Item数据或生成需要进一步跟进的URL。每个Spider通常负责处理特定网站的数据抓取任务。
5. Item Pipeline:负责处理Spider提取出的Item。典型的处理流程包括数据清洗、格式验证以及将数据持久化存储到数据库或文件中。
6. 下载器中间件(Downloader Middlewares):位于引擎与下载器之间的特定钩子(specific hook),用于处理从Downloader传递给引擎的Response。它提供了一种简便机制,允许通过插入自定义代码来扩展Scrapy的功能。
7. Spider中间件(Spider Middlewares):位于引擎与Spider之间的特定钩子(specific hook),用于处理Spider的输入(response)和输出(items及requests)。同样,它提供了一种机制,允许通过自定义代码扩展Scrapy的功能。
三、Scrapy框架工作原理
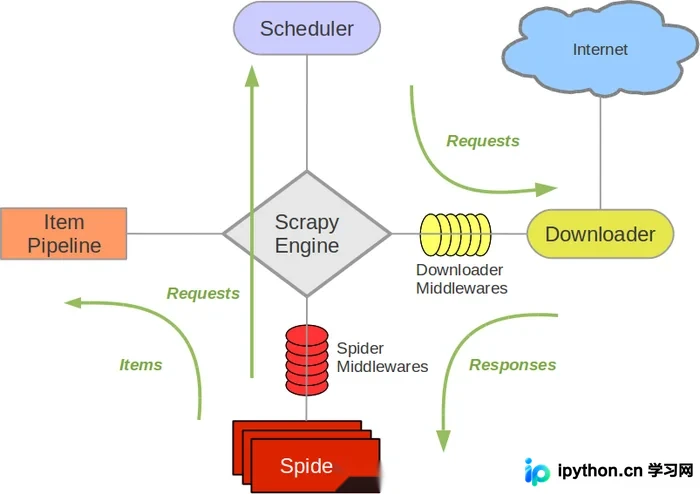
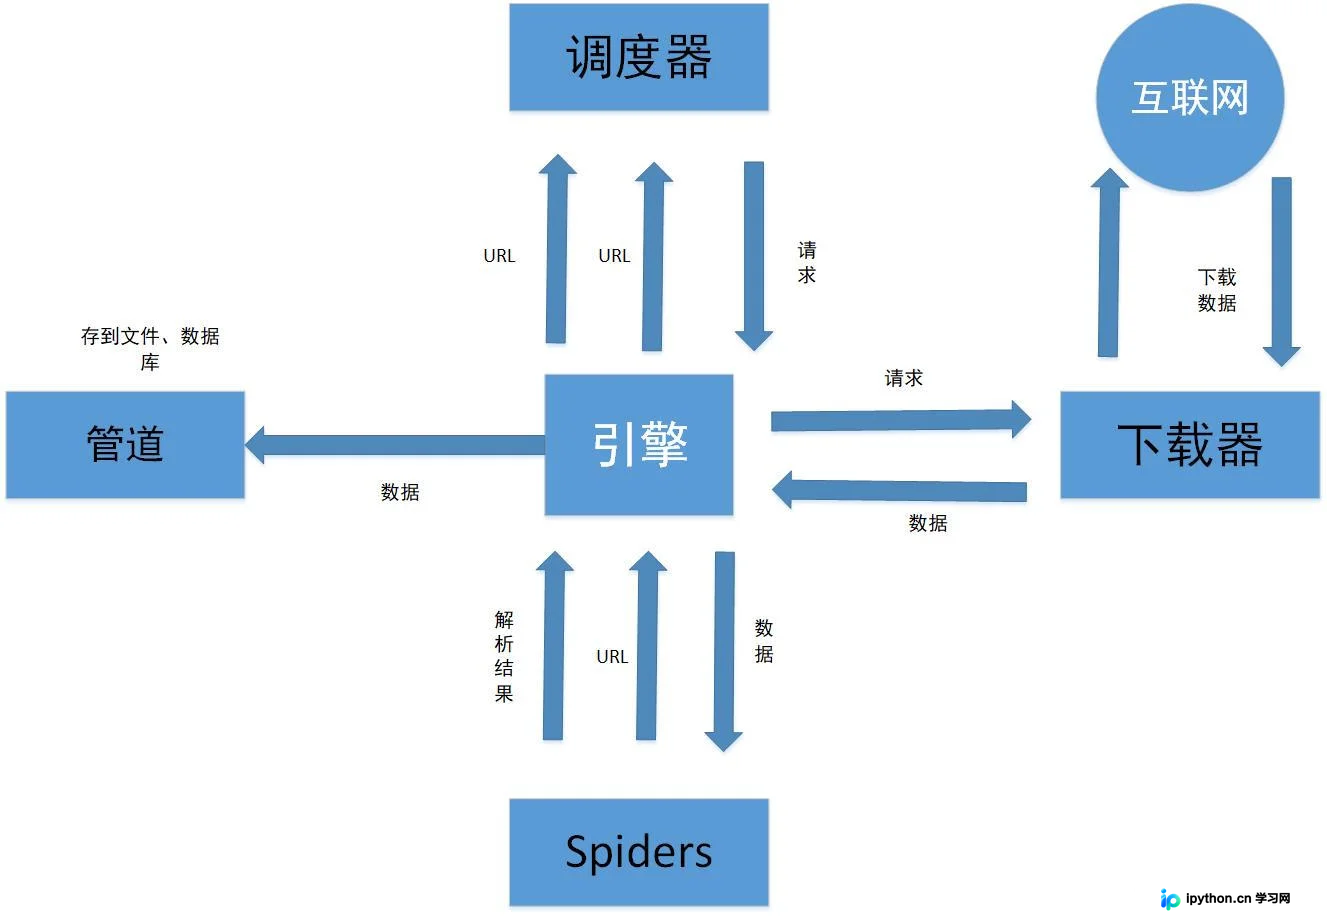
1. 引擎向Spider请求初始URL。
2. 引擎将待爬取的URL发送给调度器。
3. 调度器将URL封装成请求对象,并放入指定的队列中。
4. 从队列中取出一个请求对象。
5. 引擎将该请求发送给下载器进行处理。
6. 下载器发送HTTP请求以获取互联网数据。
7. 下载器将获取到的数据返回给引擎。
8. 引擎将接收到的数据再次传递给Spider。
9. Spider通过XPath等工具解析数据,提取出所需的数据或新的URL。
10. Spider将提取的数据或新URL返回给引擎。
11. 引擎判断返回内容的类型:如果是数据,则交给Item Pipeline处理;如果是URL,则交给调度器处理。
12. 当调度器中的队列为空,即没有任何待处理的请求时,整个程序停止运行。
以下是根据上述工作原理绘制的流程图,建议结合文字说明一起阅读以加深理解:
总结
本文到此结束,希望能为您的学习带来帮助。欢迎持续关注本站,获取更多技术内容!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









