Python Scrapy多页数据爬取实现过程解析
本文详细解析使用Python Scrapy框架进行多页数据爬取的实现过程。通过定义通用URL模板,在parse方法中利用递归逻辑手动发送后续页码的请求,从而实现对多页内容的自动抓取与解析。
2026-10-15
4

本文详细解析使用Python Scrapy框架进行多页数据爬取的实现过程。通过定义通用URL模板,在parse方法中利用递归逻辑手动发送后续页码的请求,从而实现对多页内容的自动抓取与解析。
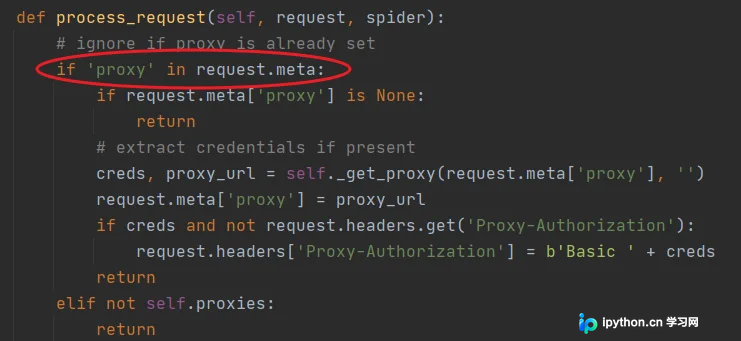
本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
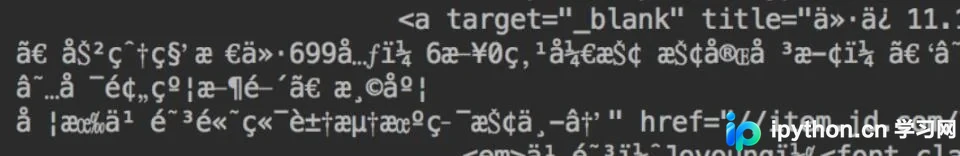
本文详细介绍Python中requests库获取的response对象的常用属性。涵盖状态码(status_code)、文本内容(text)、二进制数据(content)、编码方式(encoding)及响应头(headers)等关键属性,并通过代码示例对比text与content的区别,帮助开发者高效处理HTTP响应数据。
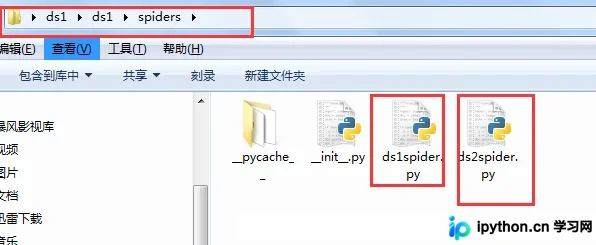
本文介绍如何在Scrapy项目中配置多个爬虫同时运行。通过自定义commands模块,修改crawlall.py以遍历并启动所有spider,并在settings.py中指定模块路径。最后通过命令行验证命令可用性并执行启动,实现多爬虫并行抓取。
本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
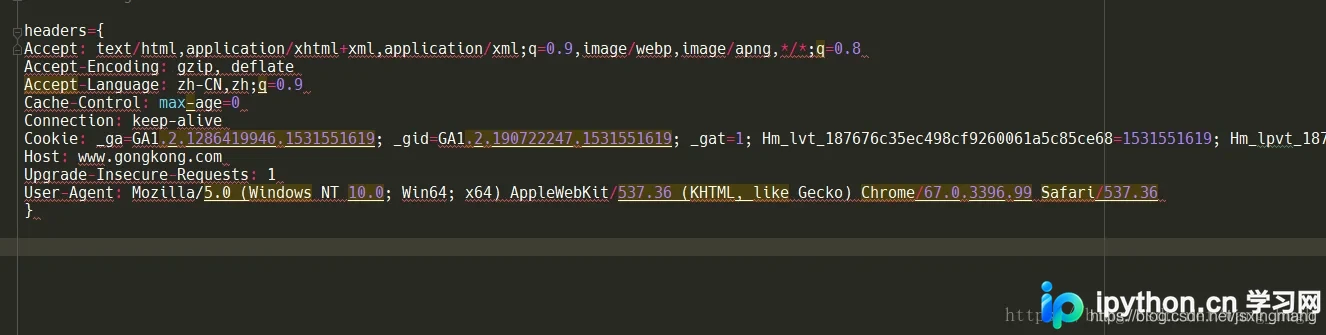
本文介绍如何在 PyCharm 中利用正则替换功能,快速将浏览器复制的 Request Headers 文本转换为标准的 Python 字典键值对格式。通过 Ctrl+R 调用正则工具,配合特定正则表达式与替换规则,可一键完成引号添加与格式整理,大幅提升爬虫开发效率。
本文详解Scrapy框架实现翻页爬取的核心机制。通过Spider的parse方法生成新Request并控制dont_filter参数,结合Pipeline中的set对象实现Item去重,配合settings.py配置开启管道,即可高效完成多页数据抓取与清洗。
本文详细解析Scrapy中请求头部的生成机制与覆盖优先级。从自动添加的User-Agent和Accept-Encoding,到settings.py中的DEFAULT_REQUEST_HEADERS配置,再到Request对象及下载中间件中的自定义Header,层层剖析其生效顺序。特别指出Referer中间件的最高优先级特性及关闭方法,帮助开发者精准控制HTTP请求头部。
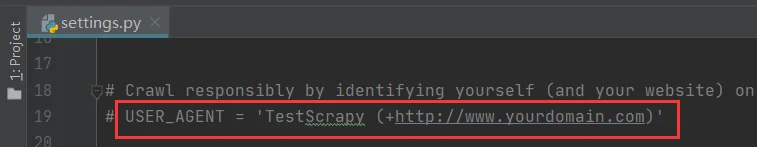
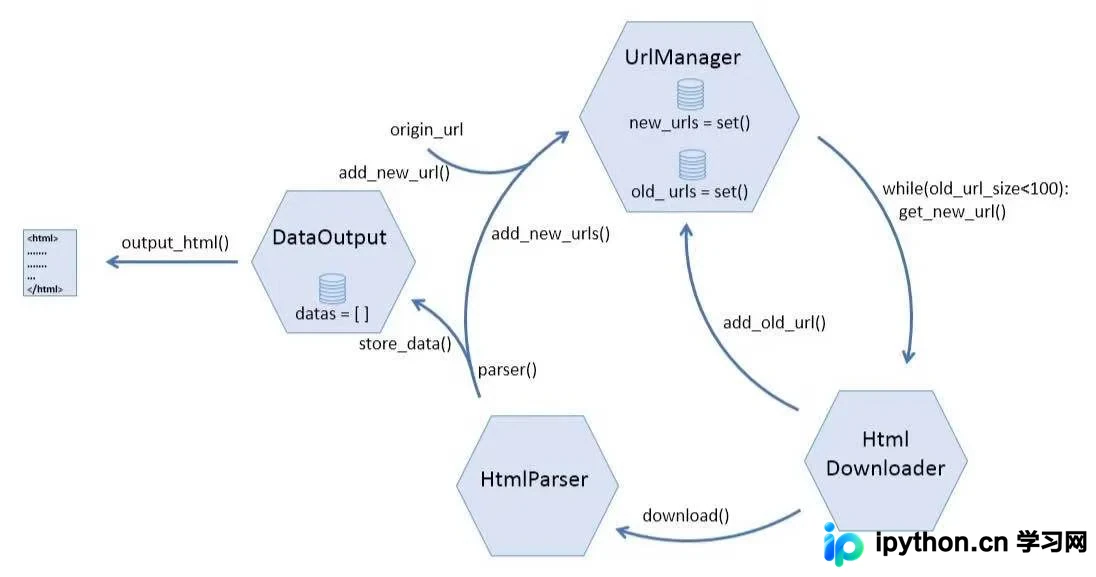
本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
本文详细介绍Python爬虫中URL管理器的核心功能,重点解析如何利用Python的set()函数实现链接去重。通过对比新旧URL仓库,阐述如何高效识别并过滤重复链接,从而提升爬虫抓取效率。文中提供了完整的UrlManager类代码示例,帮助开发者掌握去重逻辑的具体实现。
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
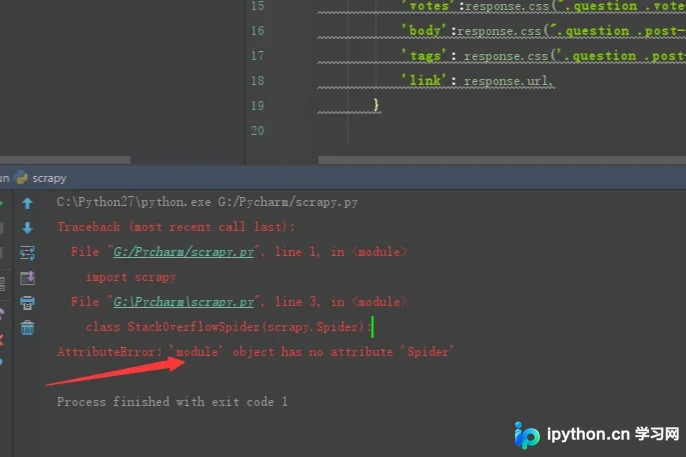
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。