

Scrapy异常处理实战:捕获HTTP错误与代码异常

本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
Scrapy异常处理实战:捕获HTTP错误与代码异常
前言
Scrapy常见异常类型分析
在使用Scrapy执行耗时较长的爬取任务(通常以天为单位)时,即便主机网络状况良好,最终日志中的“item_scraped_count”往往也无法与预设的种子数量完全一致,总会存在部分种子请求失败。失败的类型主要包含两类,具体表现可参考Scrapy任务结束时的日志截图:
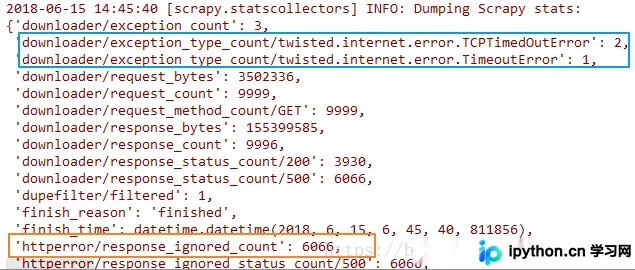
Scrapy中常见的异常主要涵盖两类:一是下载过程中的错误(对应日志中的蓝色区域),二是返回HTTP状态码为403或500的情况(对应日志中的橙色区域)。
针对上述任意一种异常,我们都可以参考Scrapy内置的RetryMiddleware(重试中间件)的实现逻辑,来编写自定义的异常处理中间件。
深入RetryMiddleware源码机制
正文
在IDE中打开Scrapy项目的任意文件,输入以下代码以引入中间件:
from scrapy.downloadermiddlewares.retry import RetryMiddleware按住Ctrl键并用鼠标左键点击RetryMiddleware,即可跳转至该中间件所在的项目文件位置。你也可以通过查看文件的方式定位,其路径通常为:site-packages/scrapy/downloadermiddlewares/retry.RetryMiddleware。
该中间件的源代码结构如下:
class RetryMiddleware(object):

  # IOError is raised by the HttpCompression middleware when trying to
  # decompress an empty response
  EXCEPTIONS_TO_RETRY = (defer.TimeoutError, TimeoutError, DNSLookupError,
              ConnectionRefusedError, ConnectionDone, ConnectError,
              ConnectionLost, TCPTimedOutError, ResponseFailed,
              IOError, TunnelError)

  def __init__(self, settings):
    if not settings.getbool('RETRY_ENABLED'):
      raise NotConfigured
    self.max_retry_times = settings.getint('RETRY_TIMES')
    self.retry_http_codes = set(int(x) for x in settings.getlist('RETRY_HTTP_CODES'))
    self.priority_adjust = settings.getint('RETRY_PRIORITY_ADJUST')

  @classmethod
  def from_crawler(cls, crawler):
    return cls(crawler.settings)

  def process_response(self, request, response, spider):
    if request.meta.get('dont_retry', False):
      return response
    if response.status in self.retry_http_codes:
      reason = response_status_message(response.status)
      return self._retry(request, reason, spider) or response
    return response

  def process_exception(self, request, exception, spider):
    if isinstance(exception, self.EXCEPTIONS_TO_RETRY) \
        and not request.meta.get('dont_retry', False):
      return self._retry(request, exception, spider)

  def _retry(self, request, reason, spider):
    retries = request.meta.get('retry_times', 0) + 1

    retry_times = self.max_retry_times

    if 'max_retry_times' in request.meta:
      retry_times = request.meta['max_retry_times']

    stats = spider.crawler.stats
    if retries <= retry_times:
      logger.debug("Retrying %(request)s (failed %(retries)d times): %(reason)s",
             {'request': request, 'retries': retries, 'reason': reason},
             extra={'spider': spider})
      retryreq = request.copy()
      retryreq.meta['retry_times'] = retries
      retryreq.dont_filter = True
      retryreq.priority = request.priority + self.priority_adjust

      if isinstance(reason, Exception):
        reason = global_object_name(reason.__class__)

      stats.inc_value('retry/count')
      stats.inc_value('retry/reason_count/%s' % reason)
      return retryreq
    else:
      stats.inc_value('retry/max_reached')
      logger.debug("Gave up retrying %(request)s (failed %(retries)d times): %(reason)s",
             {'request': request, 'retries': retries, 'reason': reason},
             extra={'spider': spider})
通过阅读源码可知,对于返回特定HTTP状态码的Response,该中间件通过process_response方法进行拦截与处理。其逻辑相对简单:判断response.status是否包含在预定义的self.retry_http_codes集合中。向前追溯该集合的定义,它位于default_settings.py文件中,具体配置如下:
RETRY_HTTP_CODES = [500, 502, 503, 504, 522, 524, 408]这意味着,中间件首先检查HTTP状态码是否在上述集合内。若包含,则触发重试逻辑;若不包含,则直接返回Response。至此,针对返回HTTP状态码异常(如5xx系列)的Response处理逻辑已实现。
然而,对于另一类异常的处理机制则有所不同。前一种情况准确来说属于HTTP请求错误(如超时),而另一种异常发生时,会表现为如下所示的直接代码抛出异常(若不进行处理):
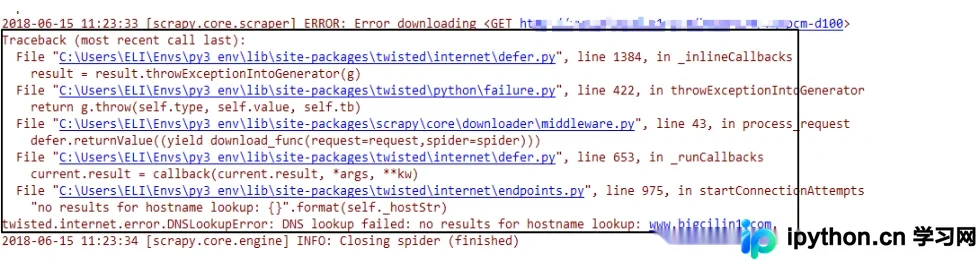
你可以创建一个Scrapy项目,在start_urls中填入一个无效的URL,即可模拟出此类异常。值得注意的是,RetryMiddleware中同样提供了处理此类异常的方法:process_exception。
通过分析源码,我们可以梳理出其大致处理逻辑:首先定义一个集合存放所有需要重试的异常类型,然后判断传入的exception是否存在于该集合中(排除dont try的情况)。若存在,则进入重试逻辑;若不存在,则忽略该异常。
自定义异常处理中间件实现
明确了Scrapy捕捉异常的机制后,思路已清晰。下面提供一个实用的异常处理中间件模板:
from twisted.internet import defer
from twisted.internet.error import TimeoutError, DNSLookupError, \
  ConnectionRefusedError, ConnectionDone, ConnectError, \
  ConnectionLost, TCPTimedOutError
from scrapy.http import HtmlResponse
from twisted.web.client import ResponseFailed
from scrapy.core.downloader.handlers.http11 import TunnelError

class ProcessAllExceptionMiddleware(object):
  ALL_EXCEPTIONS = (defer.TimeoutError, TimeoutError, DNSLookupError,
           ConnectionRefusedError, ConnectionDone, ConnectError,
           ConnectionLost, TCPTimedOutError, ResponseFailed,
           IOError, TunnelError)
  def process_response(self,request,response,spider):
    #捕获状态码为40x/50x的response
    if str(response.status).startswith('4') or str(response.status).startswith('5'):
      #随意封装,直接返回response,spider代码中根据url==''来处理response
      response = HtmlResponse(url='')
      return response
    #其他状态码不处理
    return response
  def process_exception(self,request,exception,spider):
    #捕获几乎所有的异常
    if isinstance(exception, self.ALL_EXCEPTIONS):
      #在日志中打印异常类型
      print('Got exception: %s' % (exception))
      #随意封装一个response,返回给spider
      response = HtmlResponse(url='exception')
      return response
    #打印出未捕获到的异常
    print('not contained exception: %s'%exception)
Spider解析代码示例如下:
class TESTSpider(scrapy.Spider):
  name = 'TEST'
  allowed_domains = ['TTTTT.com']
  start_urls = ['http://www.TTTTT.com/hypernym/?q=']
  custom_settings = {
    'DOWNLOADER_MIDDLEWARES': {
      'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
      'TESTSpider.middlewares.ProcessAllExceptionMiddleware': 120,
    },
    'DOWNLOAD_DELAY': 1, # 延时最低为2s
    'AUTOTHROTTLE_ENABLED': True, # 启动[自动限速]
    'AUTOTHROTTLE_DEBUG': True, # 开启[自动限速]的debug
    'AUTOTHROTTLE_MAX_DELAY': 10, # 设置最大下载延时
    'DOWNLOAD_TIMEOUT': 15,
    'CONCURRENT_REQUESTS_PER_DOMAIN': 4 # 限制对该网站的并发请求数
  }
  def parse(self, response):
    if not response.url: #接收到url==''时
      print('500')
      yield TESTItem(key=response.meta['key'], _str=500, alias='')
    elif 'exception' in response.url:
      print('exception')
      yield TESTItem(key=response.meta['key'], _str='EXCEPTION', alias='')
注意:该中间件的Order_code数值不宜过大。如果数值过大,该中间件在中间件链中的位置将更接近下载器,从而优先于RetryMiddleware处理Response。由于本中间件旨在作为兜底方案,即当一个500错误Response进入中间件链时,必须先经过RetryMiddleware处理,而非由我们编写的中间件直接处理。本中间件不具备重试功能,若直接接收500 Response并放弃该Request直接返回,是不合理的。只有当RetryMiddleware重试后仍产生异常的Request,才应由我们编写的中间件接手,此时可根据需求进行再次重试或返回一个重新构造的Response。
效果验证与注意事项
接下来验证效果(测试一个无效URL),下图为未启用自定义中间件时的情况:
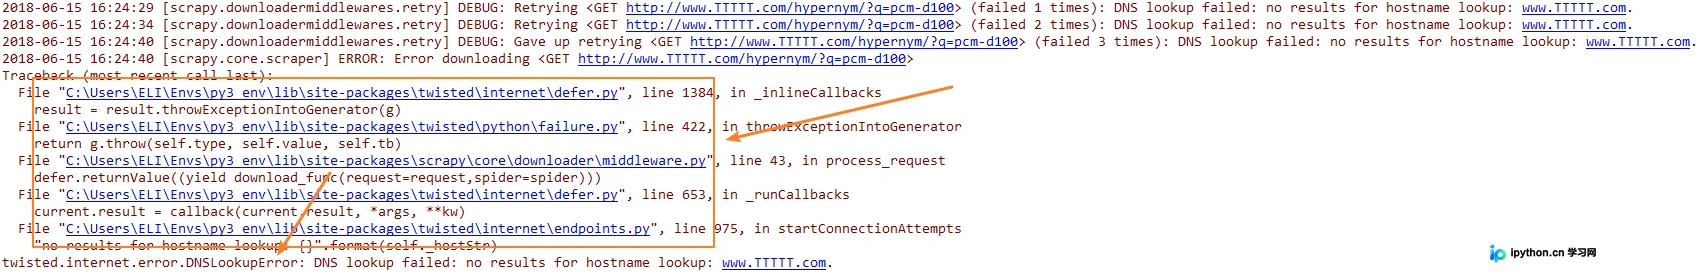
启用自定义中间件后查看效果:

结果符合预期:即使程序运行时抛出异常,也能被成功捕获并处理。
至此,关于如何在Scrapy中捕获并处理各类异常的介绍完毕。如需了解更多Scrapy捕获处理异常的相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









