

解决Scrapy爬虫搭建报错:文件命名冲突排查

发布时间:2026-10-14| 4人浏览过
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
Scrapy爬虫搭建报错现象
在之前的分享中,我们介绍了Python爬虫的相关内容。随后,有读者反馈在使用Scrapy框架搭建爬虫时遇到了错误。起初,问题并不明显,但经过反复讨论与测试,最终定位并解决了出错点。如果您也遇到了类似的搭建问题,请仔细阅读以下内容,找出可能存在的疏忽之处。
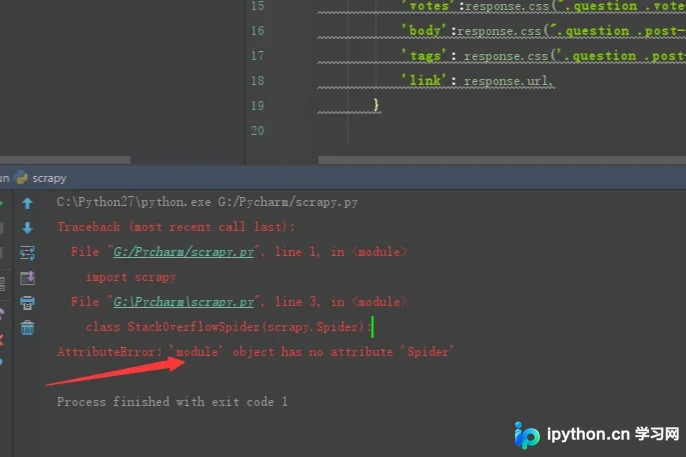
问题描述
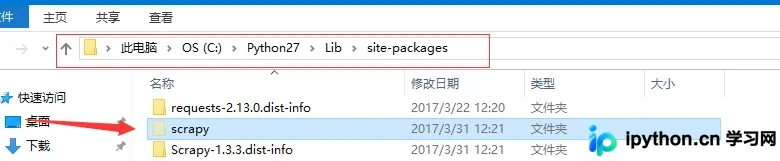
安装位置
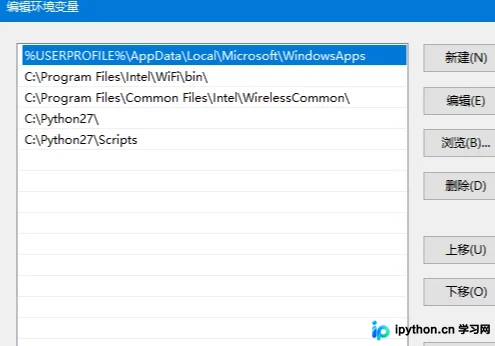
环境变量
错误原因分析与解决
解决办法
关键原因在于文件命名。当用户将项目中的文件命名为scrapy.py时,该名称与Scrapy官方库的包名发生了直接冲突。
class StackOverFlowSpider(scrapy.Spider)这种命名冲突会导致Python解释器在查找Spider属性时,优先定位到当前目录下的scrapy.py文件,而非真正的Scrapy库模块,从而引发错误。
开发规范建议
综上所述,问题的根源在于文件命名不规范。这里总结一下相关的经验教训。
在日常开发中,务必避免使用与第三方库包名或Python内置函数相同的文件名,以防止类似的导入和解析错误。
以上就是关于Scrapy在Python爬虫搭建过程中出现错误的解决方法。更多关于Scrapy搭建出错的处理技巧,欢迎查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









