

Django与Scrapy集成生成JSON接口的完整指南

本文详细讲解如何将Django框架与Scrapy爬虫深度集成,实现从51job网站抓取数据、自动存入MySQL数据库,并通过Django视图生成标准JSON接口的完整流程。内容涵盖项目创建、setting配置、scrapy_djangoitem使用、反爬处理及数据库迁移等关键步骤。
前言与学习目标
目前网络上关于Django与Scrapy结合使用的资料相对较少,本文内容基于笔者在查阅资料时的学习总结整理而成。若文中存在疏漏或错误,欢迎读者指正与修正。
鉴于后续技术方向的调整,关于Django相关的具体教程可能不再持续更新。
鉴于个人精力与深度研究的限制,本文仅涉及基础应用层面。未来的技术分享将更注重质量而非数量,力求精简深入。
希望这一系列分享能坚持完成,共同进步。
本文涵盖的核心学习点如下:
- 最终实现的功能效果。
- Django项目与Scrapy项目的初始化创建过程。
- 在settings配置文件中对接两者的具体位置及代码片段。
- 如何使用scrapy_djangoitem库实现数据映射。
- Scrapy爬虫的数据抓取与持久化保存逻辑。
- 数据库模型设计以及开发中可能遇到的问题。
- Django后端的具体配置细节。
Django与Scrapy集成配置
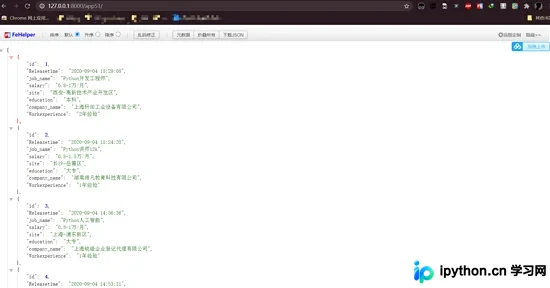
最终实现的效果展示:
Django与Scrapy项目的创建步骤:
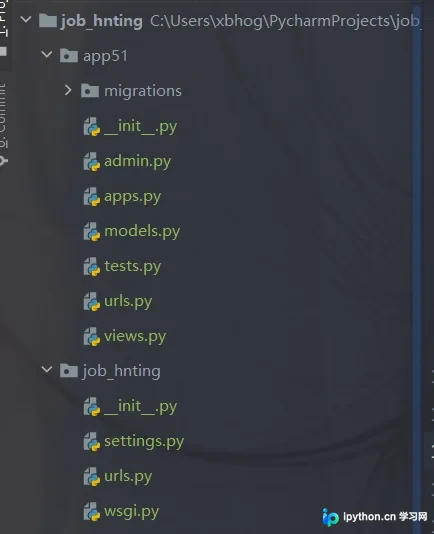
Django项目的创建流程:
django startproject 项目名称
cd 项目名称
python manage.py startapp appname
具体示例操作如下:
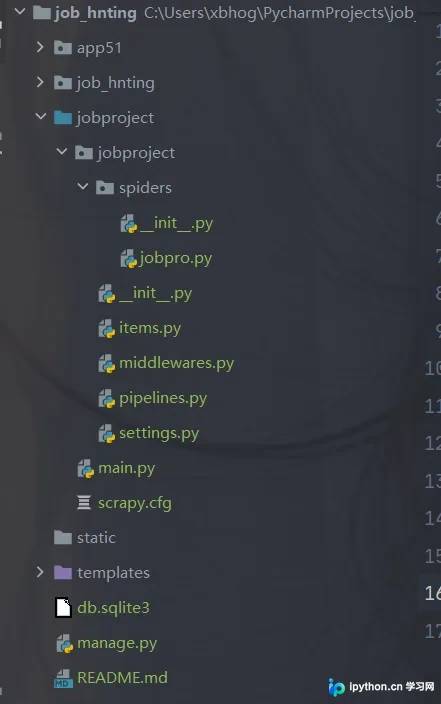
Scrapy项目的创建流程:
# cd django的根目录下
cd job_hnting
scrapy startproject 项目名称
#创建爬虫
scrapy genspider spidername 'www.xxx.com'
具体示例操作如下:
Settings配置文件的设置:
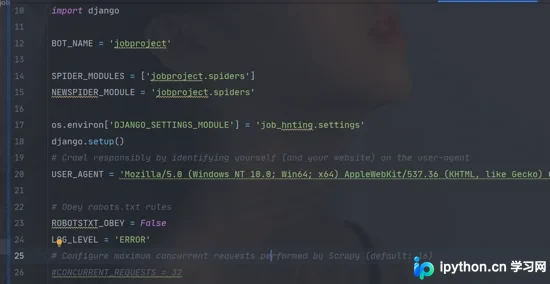
在Scrapy框架的setting中指向Django配置,使Django能够识别并加载Scrapy相关设置;
同时在Scrapy项目的setting中进行相应配置;
import os
import django

#导入
os.environ['DJANGO_SETTINGS_MODULE'] = 'job_hnting.settings'
#手动初始化
django.setup()
具体配置示例如下:
scrapy_djangoitem库的使用说明:
pip install scrapy_djangoitem该库需在Scrapy项目的items.py文件中引入并使用;
import scrapy
# 引入django中app中models文件中的类
from app51.models import app51data
# scrapy与django对接的库
from scrapy_djangoitem import DjangoItem


class JobprojectItem(DjangoItem):
  #引用django下的model中的类名
  django_model = app51data
数据存储的具体对接逻辑将在后文详细解释,目前整体框架已搭建完毕;
Scrapy爬虫开发与反爬处理
Scrapy数据抓取与保存部分:
首先编写Scrapy爬虫的核心代码;
本次示例选取51招聘网站作为数据源;
爬虫逻辑主要包含三个关键函数:
- 主请求函数。
- 数据解析函数。
- 总页数获取函数。
针对51job网站常见的反爬机制:
其JSON数据格式通常隐藏在网页HTML结构中,网上部分教程建议借助其他库进行解析(此处略过,读者可自行查阅);
本文采用的方法是使用正则表达式匹配提取定位到数据部分,随后使用json库进行解析;
# 定位数据位置,提取json数据
    search_pattern = "window.__SEARCH_RESULT__ = (.*?)</script>"
    jsonText = re.search(search_pattern, response.text, re.M | re.S).group(1)
获取关键字及总页数:
# 解析json数据
    jsonObject = json.loads(jsonText)
    number = jsonObject['total_page']
在主函数中构造页面URL并将其传递给解析函数;
  for number in range(1,int(numbers)+1):
      next_page_url = self.url.format(self.name,number)
      # print(next_page_url)
      #构造的Urlcallback到data_parse函数中
      yield scrapy.Request(url=next_page_url,callback=self.data_parse)
最后在解析函数中提取所需的具体数据字段;
 for job_item in jsonObject["engine_search_result"]:
      items = JobprojectItem()
      items['job_name'] = job_item['job_name']
      items['company_name'] = job_item["company_name"]
      # 发布时间
      items['Releasetime'] = job_item['issuedate']
      items['salary'] = job_item['providesalary_text']
      items['site'] = job_item['workarea_text']
      .......
相关的细节部分需根据实际需求自行调整,完整代码已托管在 GitHub 中。
数据持久化与数据库配置
数据爬取部分解决后,需将数据写入Scrapy项目中的pipeline文件进行保存;
class SeemeispiderPipeline(object):
  def process_item(self, item, spider):
    item.save()
    return item
记得在setting文件中取消掉pipeline的注释以启用该功能。
数据库配置设置:
Django配置数据库主要有两种方法:
方法一:直接在settings.py文件中添加数据库配置信息(本文个人采用的方式);
DATABASES = {
  # 方法一
  'default': {
    'ENGINE': 'django.db.backends.mysql',  # 数据库引擎
    'NAME': 'mysite',            # 数据库名称
    'USER': 'root',           # 数据库登录用户名
    'PASSWORD': '123',        # 密码
    'HOST': '127.0.0.1',        # 数据库主机IP,如保持默认,则为127.0.0.1
    'PORT': 3306,              # 数据库端口号,如保持默认,则为3306
  }
}
方法二:将数据库配置信息单独存储在一个配置文件中,然后在settings.py文件中将其引入。
新建数据库配置文件my.cnf(文件名可自定义选择);
[client]
database = blog
user = blog
password = blog
host =127.0.0.1
port = 3306
default-character-set = utf8
在settings.py文件中引入my.cnf配置文件;
DATABASES = {
  # 方法二:
  'default': {
    'ENGINE': 'django.db.backends.mysql',
    'OPTIONS': {
      'read_default_file': 'utils/dbs/my.cnf',
    },
  }
}
启用Django与MySQL数据库的连接;
在生产环境中安装pymysql,并且需要在settings.py文件所在包中的 __init__.py 中导入pymysql库。
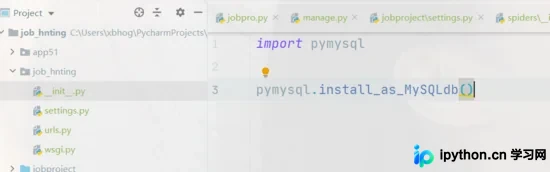
import pymysql
pymysql.install_as_MySQLdb()
对应前面的item定义,在spider中编写时按照model设置的字段即可;
from django.db import models
# Create your models here.
#定义app51的数据模型
class app51data(models.Model):
  #发布时间,长度20
  Releasetime = models.CharField(max_length=20)
  #职位名,长度50
  job_name =models.CharField(max_length=50)
  #薪水
  salary = models.CharField(max_length=20)
  #工作地点
  site = models.CharField(max_length=50)
  #学历水平
  education = models.CharField(max_length=20)
  #公司名称
  company_name = models.CharField(max_length=50)
  #工作经验
  Workexperience = models.CharField(max_length=20)
  #指定表名
  class Meta:
    db_table = 'jobsql51'

  def __str__(self):
    return self.job_name
当指定完表名后,在DBMS中只需要创建对应的数据库即可,表名会自动创建。
每次修改数据库模型都要执行以下命令:
python manage.py makemigrations
python manage.py migrate
至此MySQL数据库配置完成。
配置数据库时遇到的常见错误:
Django启动时报错:AttributeError: 'str' object has no attribute 'decode'。
解决方法:
找到Django安装目录;
G:\env\django_job\Lib\site-packages\django\db\backends\mysql\operations.py
编辑operations.py文件;
将第146行的decode方法修改为encode;
def last_executed_query(self, cursor, sql, params):
    # With MySQLdb, cursor objects have an (undocumented) "_executed"
    # attribute where the exact query sent to the database is saved.
    # See MySQLdb/cursors.py in the source distribution.
    query = getattr(cursor, '_executed', None)
    if query is not None:
      #query = query.decode(errors='replace')
      uery = query.encode(errors='replace')
    return query
Django视图与JSON接口生成
Django后端配置:
关于Django的基础配置,如路由设置、app注册等基础用法,此处不再赘述;
以下主要介绍APP中视图的配置,重点在于生成JSON数据;
from django.shortcuts import render
from django.http import HttpResponse
# Create your views here.
#引入数据
from .models import app51data
import json

def index(request):
  # return HttpResponse("hello world")
  # return render(request,'index.html')
  #获取所有的对象,转换成json格式
  data =app51data.objects.all()
  list3 = []
  i = 1
  for var in data:
    data = {}
    data['id'] = i
    data['Releasetime'] = var.Releasetime
    data['job_name'] = var.job_name
    data['salary'] = var.salary
    data['site'] = var.site
    data['education'] = var.education
    data['company_name'] = var.company_name
    data['Workexperience'] = var.Workexperience
    list3.append(data)
    i += 1

  # a = json.dumps(data)
  # b = json.dumps(list2)

  # 将集合或字典转换成json 对象
  c = json.dumps(list3)
  return HttpResponse(c)
实现效果展示:
完整代码在 GitHub 中,希望读者随手star,感谢支持!。
到此这篇关于Django-Scrapy生成后端json接口的方法示例的文章就介绍到这了,更多相关Django Scrapy生成json接口内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









