

Scrapy结合scrapy_redis实现分布式爬虫部署详解

本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。
环境准备与前置条件
准备工作
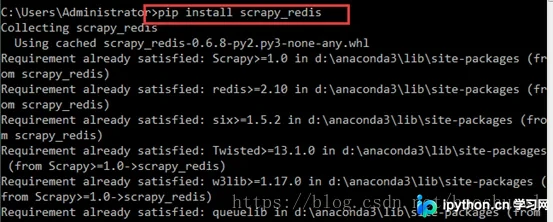
首先,需要在命令行工具中执行 pip install scrapy_redis 命令以安装必要的依赖包。
确保已拥有一个运行正常、无报错的现有Scrapy爬虫项目作为基础。
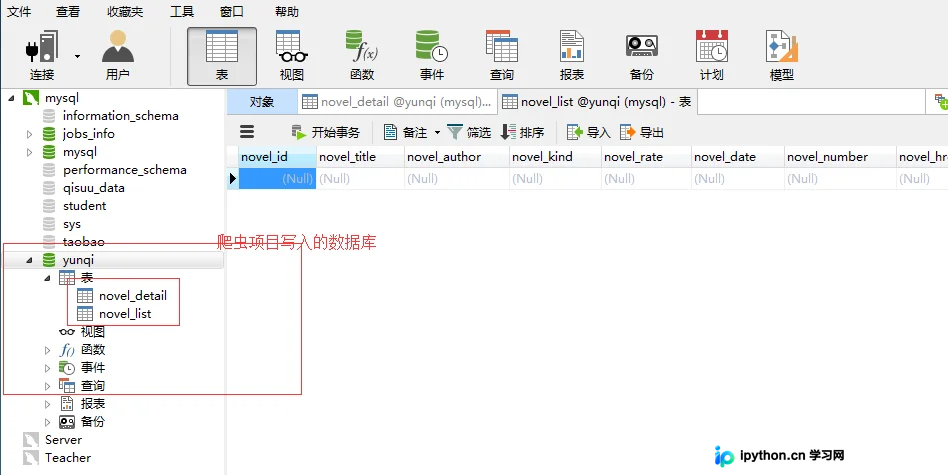
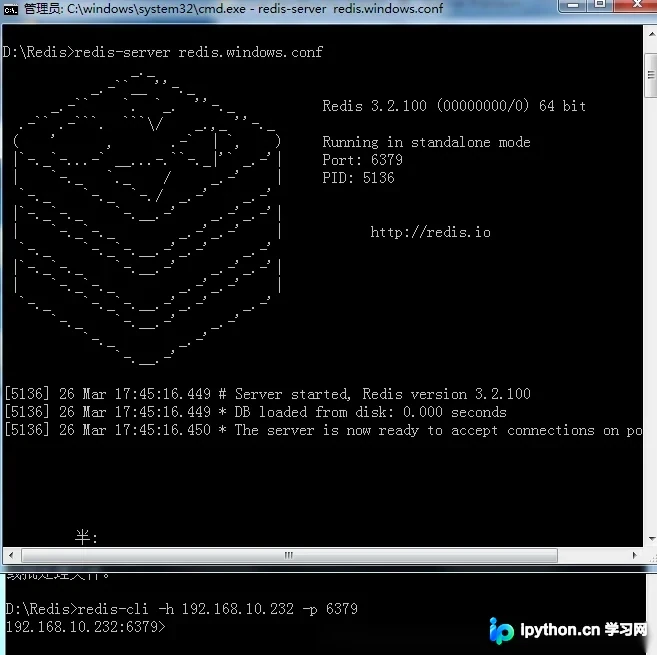
准备一台Redis主服务器以及一个与爬虫程序关联的MySQL数据库。
注意,MySQL数据库需开启远程连接权限。默认情况下,MySQL安装后的root用户仅允许本地连接,具体配置方法可参考相关技术文章。
Scrapy分布式配置详解
部署过程
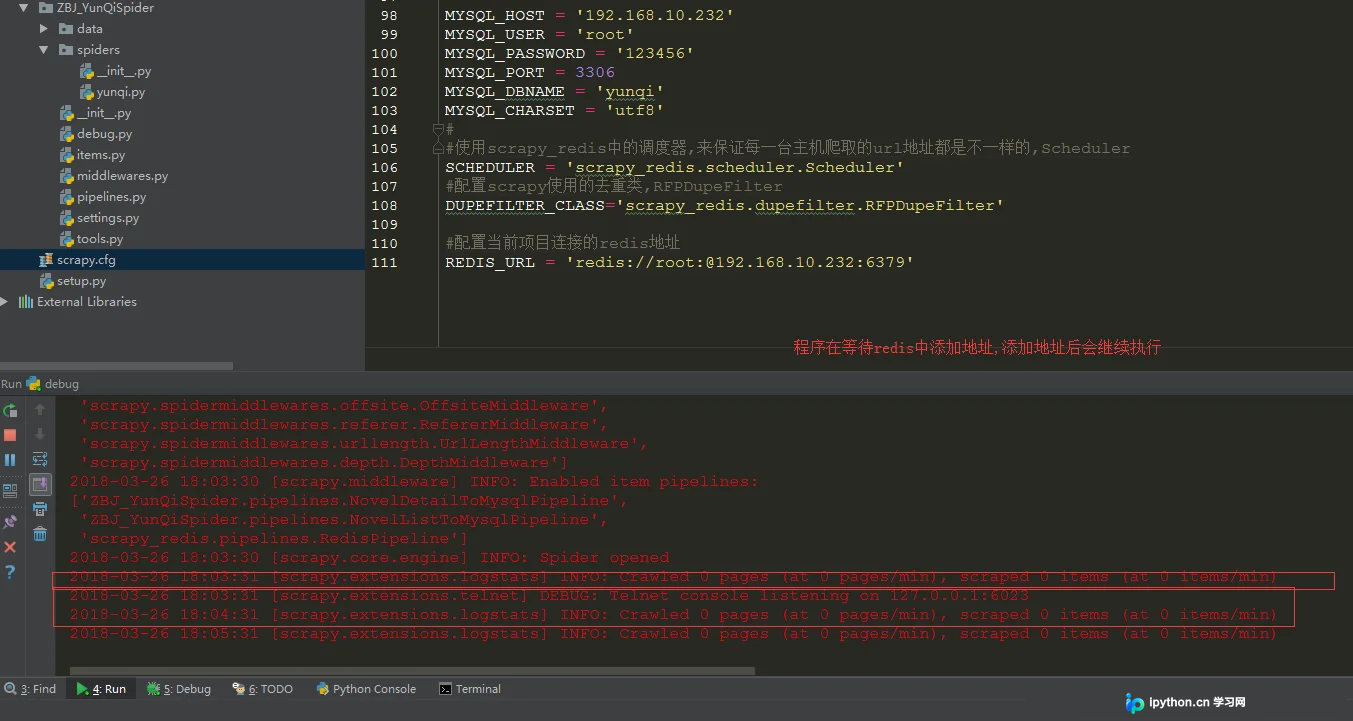
第一步,修改爬虫项目的 settings.py 配置文件。
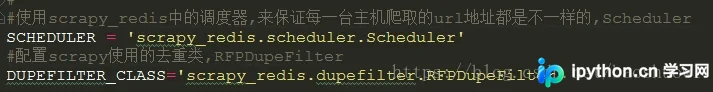
在已安装的 scrapy_redis 包中,scheduler.py 文件包含用于调度URL的 Scheduler 类,而 dupefilter.py 文件包含用于URL去重的 RFPDupeFilter 类。因此,需要在 settings.py 文件中添加相应的配置以启用这两个组件。
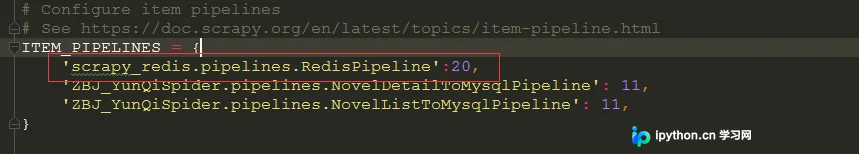
此外,scrapy_redis 包中的 pipelines.py 文件提供了 RedisPipeline 类,可将爬取数据写入Redis,从而提升数据存储的稳定性和安全性。需在 settings.py 的 ITEM_PIPELINES 配置中启动该 Pipeline。
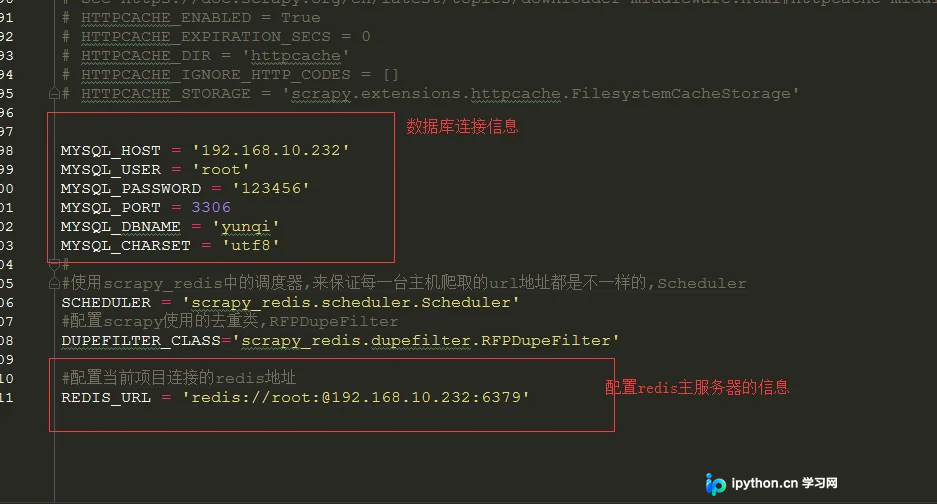
最后,需在 settings.py 中修改 Redis 的连接配置信息。
第二步,修改 Spider 爬虫源文件。
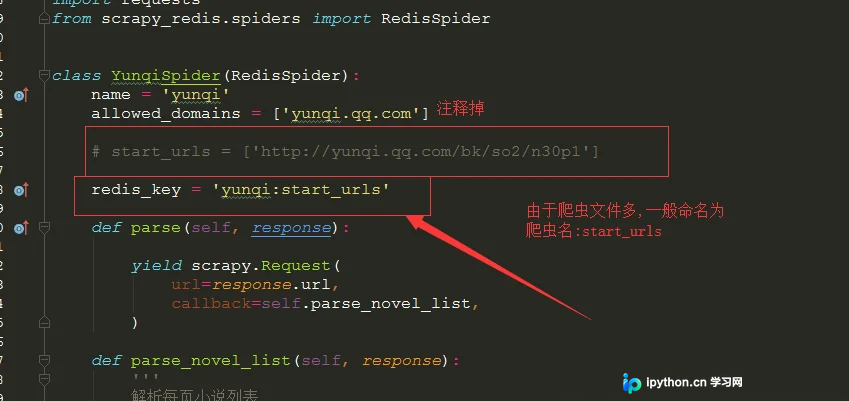
首先,从 scrapy_redis.spider 模块中导入 RedisSpider 类,并将原 Spider 文件中继承的 scrapy.Spider 替换为 RedisSpider。
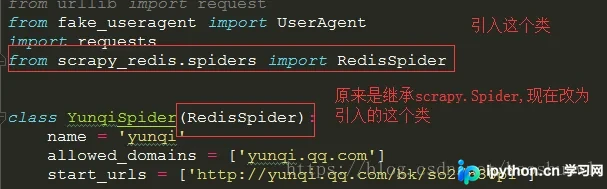
接着,注释掉原有的 start_urls 列表,并添加 redis_key 属性,其值通常为自定义的键名,建议格式为“爬虫名:urls”。
部署测试与多节点运行
测试部署是否成功
直接运行修改后的爬虫项目。
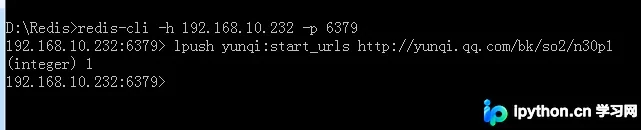
打开 Redis 客户端,向名为 yunqi:start_urls 的列表中添加键值,其中值为待抓取的网址。
添加成功后,程序将自动开始运行并抓取数据。
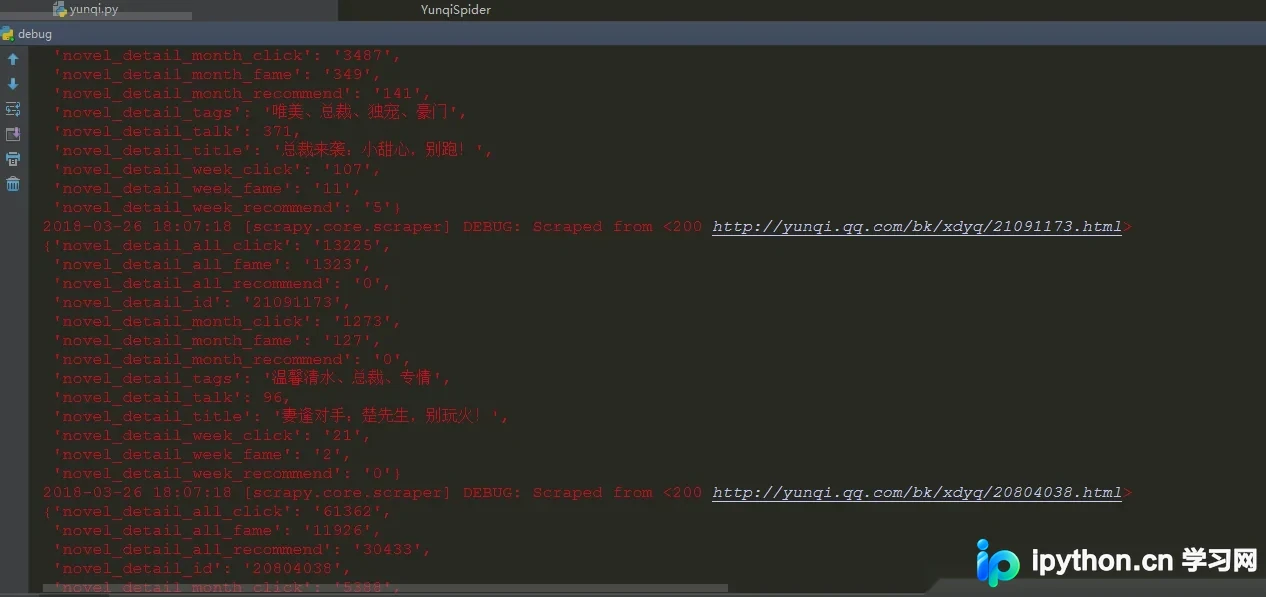
检查数据是否已正确插入到数据库中。
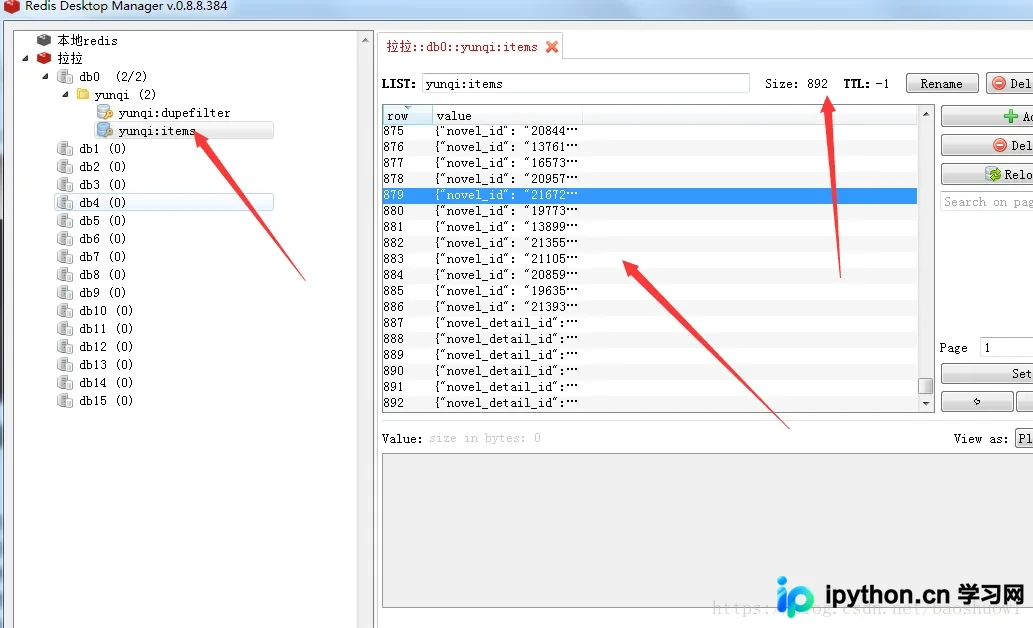
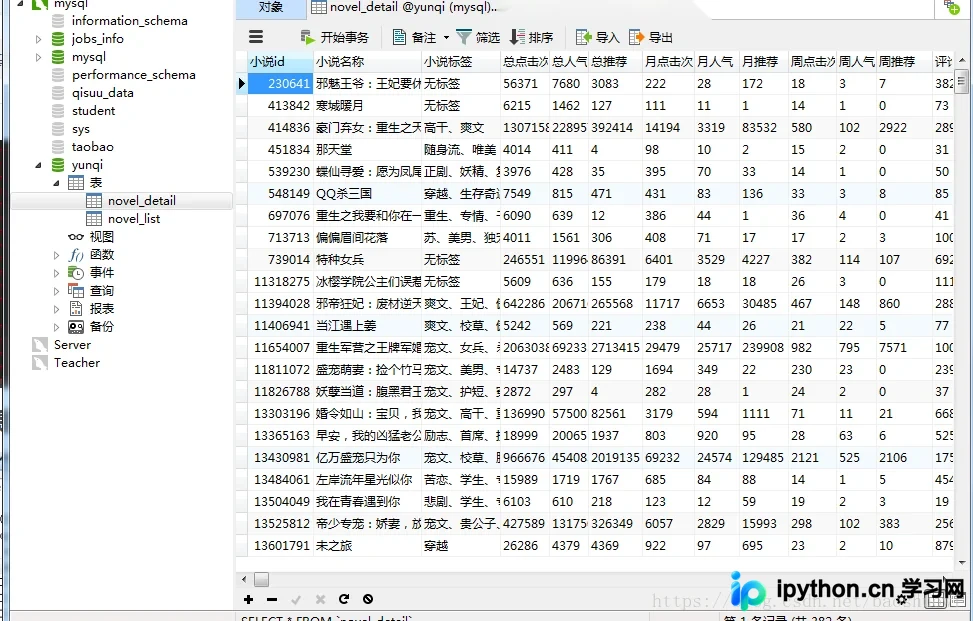
分布式部署的核心在于使用同一套代码进行多节点运行。具体步骤如下: 1)将项目配置修改为分布式模式; 2)将项目代码拷贝至多台服务器; 3)启动所有服务器上的爬虫进程; 4)在主 Redis 客户端中,通过 lpush 命令将目标网址推入指定的列表; 5)效果:所有爬虫节点开始运行,且各自抓取的数据互不重复。
至此,关于 Scrapy 基于 scrapy_redis 实现分布式爬虫部署的示例介绍完毕。如需了解更多 Scrapy 与 Redis 分布式爬虫相关内容,请搜索本站过往文章或浏览后续相关文章,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









