

Python Scrapy shell 快速调试与规则验证指南

在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。
核心目标与环境准备
Scrapy shell 提供了与正式爬虫 parse 方法完全一致的上下文环境。开发者可以在该环境中输入 Python 代码,实时查看对目标网页的数据解析结果,避免反复修改代码后执行完整测试带来的延迟。开始之前,请确保已安装 Scrapy 并创建好对应的项目目录与隔离环境。
启动 Scrapy shell 的真实操作顺序
第1步:进入目标项目目录
目的:让命令行上下文指向 Scrapy 项目根路径,以便后续命令能正确读取配置文件。
操作入口:系统终端(Terminal / CMD)
执行动作:
cd /path/to/your/scrapy_project注:请将路径替换为实际存放项目的文件夹地址。
第2步:激活虚拟环境
目的:确保当前命令行调用的是项目专用的 Python 解释器和已安装的 Scrapy 依赖,避免版本冲突。
操作入口:终端命令行
执行动作(以 Linux/macOS 为例):
source /path/to/venv/bin/activateWindows 用户请使用 .\venv\Scripts\activate。激活成功后,命令行前缀通常会显示 (venv)。
第3步:加载目标网址启动交互
目的:向服务端发起请求,下载 HTML 内容,并在内存中构建可供操作的 response 对象。
操作入口:终端命令行
执行动作:
scrapy shell "https://car.autohome.com.cn/pic/series/66.html"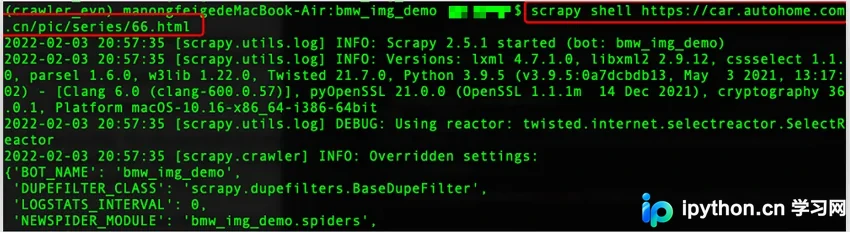
运行指令后,终端会输出 HTTP 请求过程日志,当出现 [scrapy] 提示符时,说明环境已就绪。
第4步:编写并测试数据提取规则
目的:在交互环境中实时运行解析逻辑,核对返回数据结构是否符合预期。
操作入口:>> 交互式命令行
执行动作:
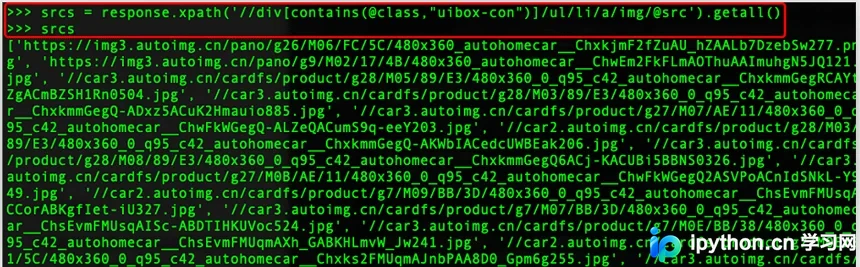
srcs = response.xpath('//div[contains(@class,"uibox-con")]/ul/li/a/img/@src').getall()键入上述命令并按回车后,系统将返回匹配的属性列表。可观察到的完成状态为:终端直接打印出提取出的字符串数组,无 Error 或 NoneType 报错信息。
验证标准与排错建议
完成判断依据
当命令执行后,右侧输出区域呈现结构化数据(如列表、字典或字符串),且未触发拦截机制或超时异常,即表示提取逻辑通过验证。此时可直接将测试通过的表达式迁移至正式爬虫的逻辑中。
常见问题排查
- 报 NameError:检查是否误拼变量名,环境中默认的响应对象始终为
response,无需手动导入。 - 提取结果为空:使用
response.text[:500]预览原始 HTML,确认目标元素的 Class 或结构是否已被动态脚本渲染或反爬策略修改。 - 网络中断:若目标站点限制频率,连续发起多次请求可能导致临时封禁 IP,建议在真实环境中控制并发请求节奏。
简要总结
掌握 Scrapy shell 的调用流程与环境配置,能够有效剥离爬虫运行的冗余开销,让开发者专注于选择器语法的准确性校验。通过标准的目录定位、环境激活与命令测试三步组合,即可实现低延迟的规则验证循环。以上就是 Scrapy shell 快速测试与规则验证的详细操作指南,更多关于 Python 爬虫开发与数据采集优化的实战资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









