Python爬虫之requests库基本介绍
本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
2026-10-15
5

本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
本文详解Python中利用requests库进行外部接口调用的完整流程,涵盖Get与Post请求的多种参数提交方式(Form、JSON、文件上传)。结合Flask框架演示接口接收逻辑,重点解析SSL证书验证、数据序列化及中文编码处理等关键细节,提供可直接运行的代码示例。
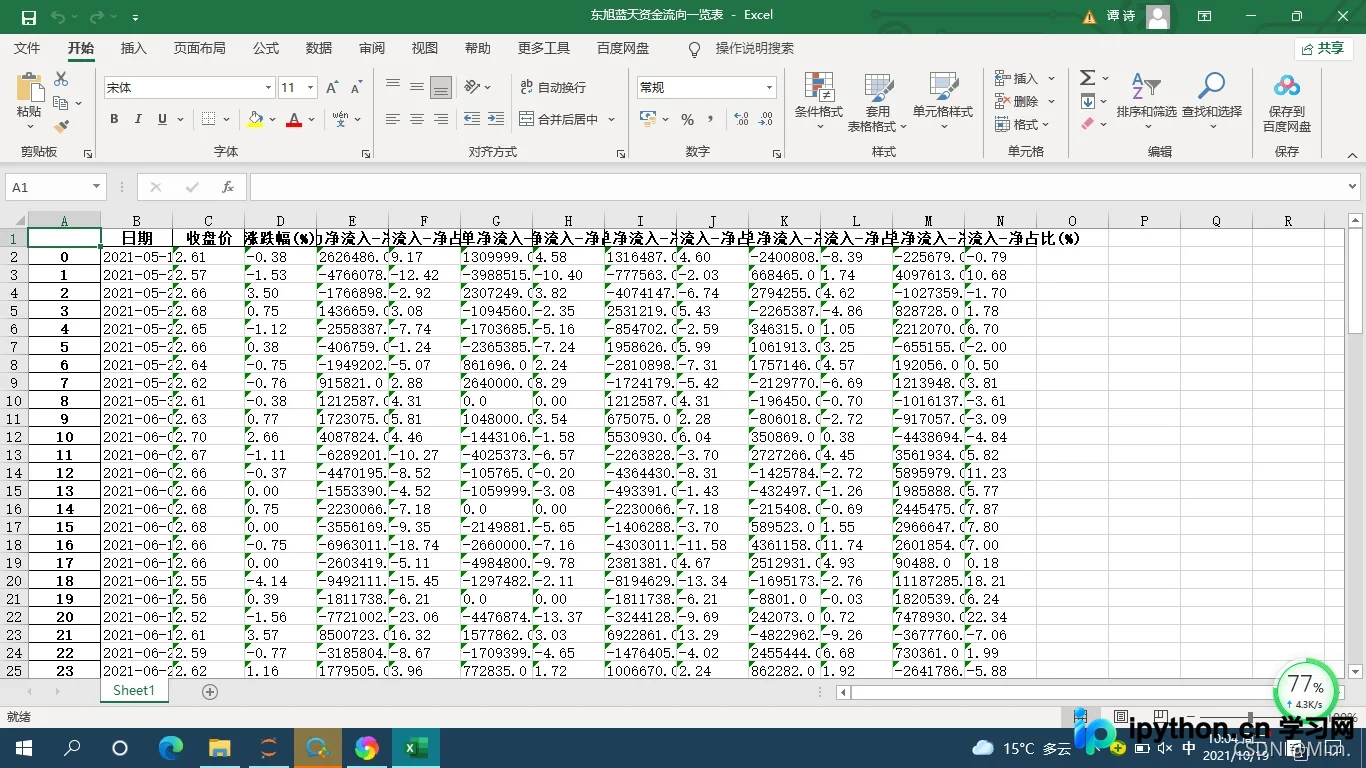
本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。
本文详细介绍在PyCharm中导入requests模块的步骤,包括获取Python安装路径、使用CMD执行pip install命令以及解决常见下载错误的方法。通过具体代码和命令行操作示例,帮助用户快速完成环境配置。
本文详解如何使用Python的requests库实现豆瓣登录及会话状态保持,通过Session对象自动管理Cookie,进而批量抓取《荒野生存》影评数据。结合正则表达式提取内容,利用结巴分词与词云库进行数据分析,完整展示从登录接口分析到数据可视化的全流程。
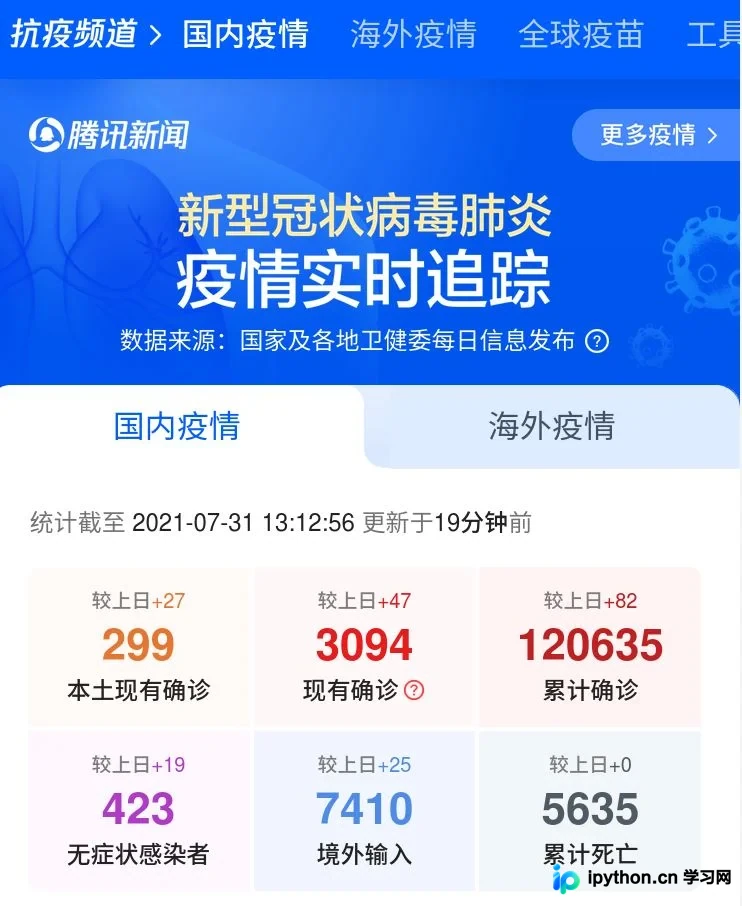
本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
本文详细介绍在PyCharm开发环境中安装和使用Python第三方库requests的完整流程。内容涵盖从Python官网下载安装包、PyCharm IDE的配置,到通过pip命令安装requests库的具体步骤。作为网页抓取的首选工具,requests以简洁高效著称,掌握其环境配置是进行Python网络编程的基础。
本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。
本文介绍使用Python的Selenium和Requests库批量获取B站直播主播头像并保存的方法。提供两种实现路径:一是通过官方API接口直接获取数据,二是利用Selenium定位HTML元素提取图片链接。代码包含环境安装、请求处理及文件保存逻辑,帮助开发者掌握网络爬虫基础技巧。
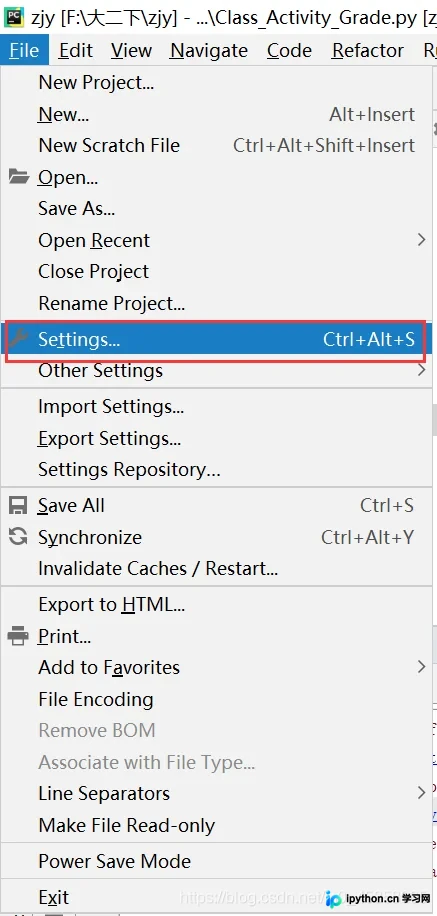
本文详细介绍在PyCharm编辑器中安装第三方库的两种常用方法。第一种是通过内置Terminal终端使用pip命令进行安装,操作简便直接;第二种是通过Settings设置界面图形化安装。以安装requests库为例,分别演示了命令行输入及界面点击的具体步骤,帮助用户快速完成Python依赖包的管理与配置。

本文深入解析Python requests库中timeout参数的两种设置方式:单一值与元组形式。重点指出连接超时默认21秒而读取超时无默认值易导致程序永久挂起的风险,并提供针对高并发场景的超时配置建议及常见卡死问题的解决方案。
本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。