

Selenium与Requests实现B站主播头像批量下载:接口与DOM解析双方案

发布时间:2026-10-14| 4人浏览过
本文介绍使用Python的Selenium和Requests库批量获取B站直播主播头像并保存的方法。提供两种实现路径:一是通过官方API接口直接获取数据,二是利用Selenium定位HTML元素提取图片链接。代码包含环境安装、请求处理及文件保存逻辑,帮助开发者掌握网络爬虫基础技巧。
声明:本文内容整理自网络资源及专业书籍,经过理解、实践与梳理后形成的学习笔记。
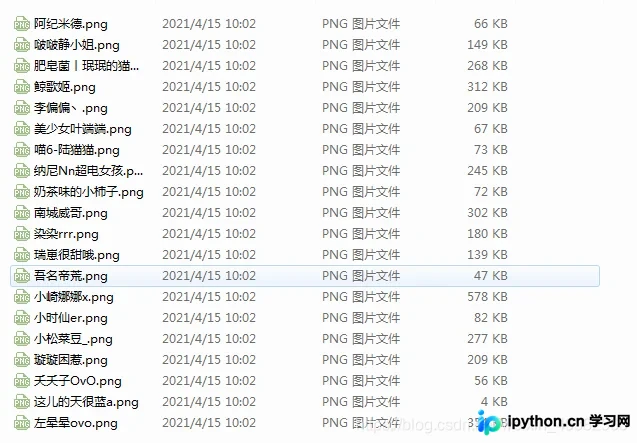
基于Python的Selenium自动化测试框架,实现从哔哩哔哩平台获取主播头像,并以主播昵称作为文件名保存至本地文件的功能演示。
运行效果展示
方案一
利用API接口直接获取数据
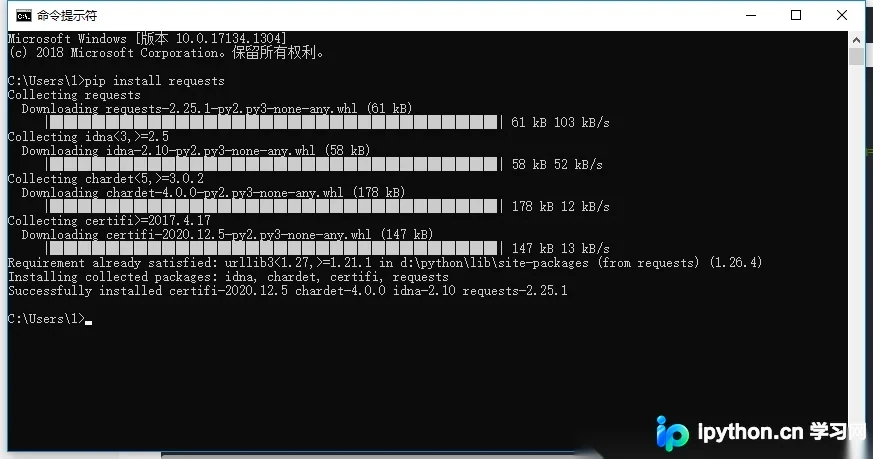
第一步,通过pip工具安装requests库。
pip install requests
import requests
# 通过接口获取请求的接口:想要获取网页的url
url = 'https://api.live.bilibili.com/xlive/web-interface/v1/second/getList?platform=web&parent_area_id=1&area_id=0&sort_type=sort_type_152&page=1'
# 发送get请求,获取返回数据
request = requests.get(url)
# 保存图片的路径
dir = '../requests/bilibili/'
# 将获取的数据转化为json文件并获取到图片的链接
info = request.json()['data']['list']
for i in info:
	# 将图片以主播的昵称命名
    file = open(dir + '{}.png'.format(i['uname']), 'wb')
    # 将图片保存到之前的路径
    file.write(requests.get(i['face']).content)
    # 关闭文件流
    file.close()
方案二
通过HTML元素定位提取信息
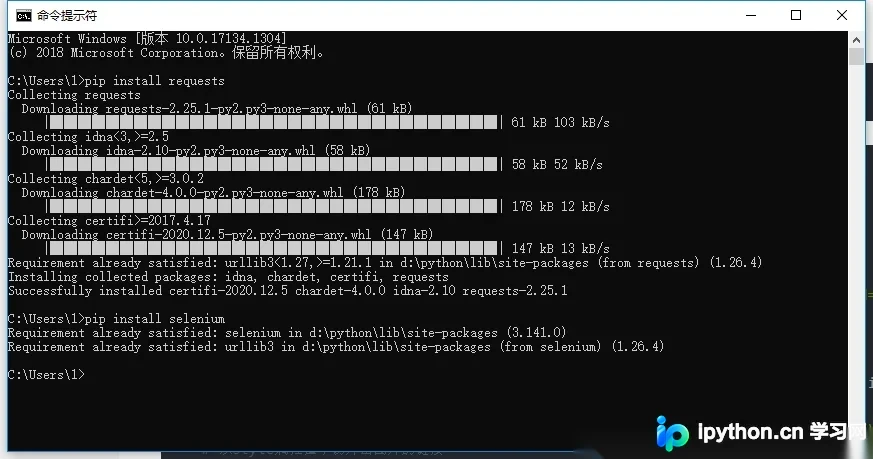
第一步,通过pip工具分别安装requests和selenium库。
pip install requests pip install selenium
import requests
from selenium import webdriver
# 使用谷歌驱动打开谷歌浏览器
driver = webdriver.Chrome()
# 访问哔哩哔哩直播页面
driver.get('https://live.bilibili.com/p/eden/area-tags?visit_id=2mwktlg4e2q0&areaId=0&parentAreaId=1')
# 循环30次一次保存的头像图片
for i in range(1, 31):
	# xpth定位头像的位置
    image_xpath = '/html/body/div[1]/div[3]/div/ul/li[{}]/a/div[1]/div/div'.format(i)
    # 获取位置的style属性值
    image_style_value = driver.find_element_by_xpath(image_xpath).get_attribute('style')
    # 从style属性值中切片出图片的链接
    image_url = image_style_value[image_style_value.find('h'):image_style_value.find('@'):1]
    # xpath定位昵称的位置
    title_xpath = '/html/body/div[1]/div[3]/div/ul/li[{}]/a/div[2]/div[2]/div/span'.format(i)
    # 获取位置的title值
    name_title_value = driver.find_element_by_xpath(title_xpath).get_attribute('title')
    print(image_url)
    # 发送get请求,获取返回数据
    request = requests.get(image_url)
    # 保存图片的路径
    file = open('D:Python Projects/requests/bilibili/{}.jpg'.format(name_title_value), 'wb')
    # 将图片保存到路径
    file.write(request.content)
    # 关闭文件流
    file.close()
最后,额外提供一段获取B站视频相关信息的操作代码供参考。
# coding:utf-8
import requests
import json
import time
import pymysql
import bs4
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.132 Safari/537.36'
}
result = []
def get_aid(page):
    url = 'https://search.bilibili.com/all?keyword=爬虫&from_source=nav_search&spm_id_from=333.851.b_696e7465726e6174696f6e616c486561646572.11' + '&page=' + str(page)
    response = requests.get(url, headers=headers, verify=False).text
    time.sleep(1)
    try:
        soup = bs4.BeautifulSoup(response, 'lxml').find('div', attrs={'id':'all-list'}).find('div', attrs={'class':'mixin-list'})
        ul = soup.find('ul', attrs={'class':'video-list clearfix'}).find_all('li', attrs={'class':'video-item matrix'})
        for item in ul:
            # print(item)
            info = item.find('div', attrs={'class': 'headline clearfix'}).find('span', attrs={'class': 'type avid'}).get_text()
            aid = info.replace('av', '')
            print(aid)
            result.append(aid)
        return result
    except:
        print('something is wrong')
def get_contents(url):
    response = requests.get(url=url, headers=headers, verify=False).json()
    time.sleep(1)
    try:
        data_1 = response['data']
        data = data_1['stat']
        aid = data['aid']
        view = data['view']
        coin = data['coin']
        like = data['like']
        favorite = data['favorite']
        share = data['share']
        danmaku = data['danmaku']
        print('视频编号', aid)
        print('观看数量', view)
        print('投币数量', coin)
        print('收藏数量', favorite)
        print('点赞数量', like)
        print('分享数量', share)
        print('弹幕数量', danmaku)
    except:
        print('------------')
if __name__ == '__main__':
    for i in range(1, 50):
        result = get_aid(i)
    for i in result:
        url = 'https://api.bilibili.com/x/web-interface/view?aid=' + str(i)
        get_contents(url)
至此,关于使用Selenium爬取B站主播头像并以昵称命名保存至本地的教程介绍完毕,希望能为读者提供帮助。如需了解更多Python爬虫相关内容,请查阅本站往期文章或继续浏览后续系列,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









