

Python接口测试中保持登录状态的三种实现方式
本文总结了在Python接口测试中保持登录状态的三种常用方法。第一种为手动注入已获取的Cookie,适用于已知凭证的场景;第二种通过调用登录接口并从响应对象中提取Cookies供后续请求使用;第三种利用requests.Session()实例自动管理Cookie,实现跨请求的状态保持。这三种方式各有适用场景,可根据实际需求选择。
2026-10-13
6

本文总结了在Python接口测试中保持登录状态的三种常用方法。第一种为手动注入已获取的Cookie,适用于已知凭证的场景;第二种通过调用登录接口并从响应对象中提取Cookies供后续请求使用;第三种利用requests.Session()实例自动管理Cookie,实现跨请求的状态保持。这三种方式各有适用场景,可根据实际需求选择。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
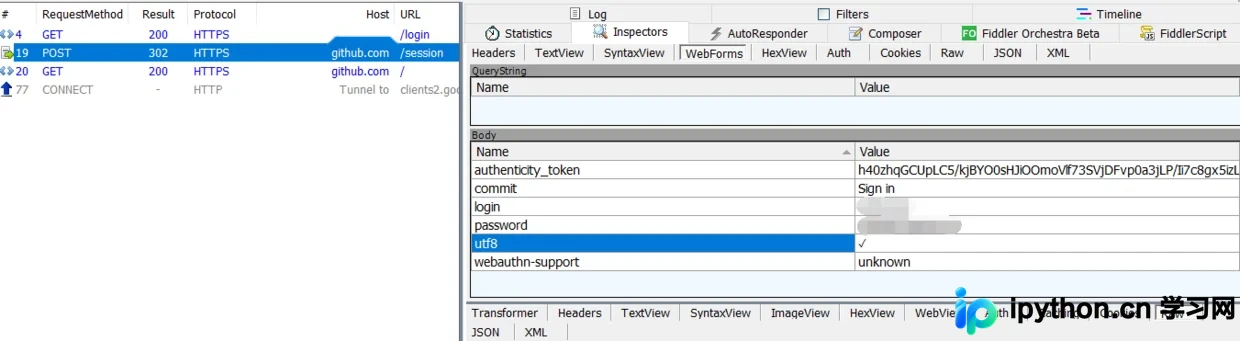
本文详细讲解如何使用Python结合Fiddler抓包工具模拟GitHub登录。通过抓取HTTP请求分析登录流程,提取关键参数authenticity_token,并利用requests库构建Session会话完成POST表单提交。文中包含处理SSL证书警告、正则提取Token及通过页面标题判断登录状态的具体代码实现,适合希望学习网络爬虫基础与接口模拟的开发者参考。
本文提供Python实现的百度贴吧图片爬取完整示例。代码涵盖贴吧名称、页码范围输入,利用urllib构造请求URL,通过lxml解析HTML获取图片链接,并使用requests下载图片保存至本地。示例包含完整的类定义与执行逻辑,供Python学习者参考。
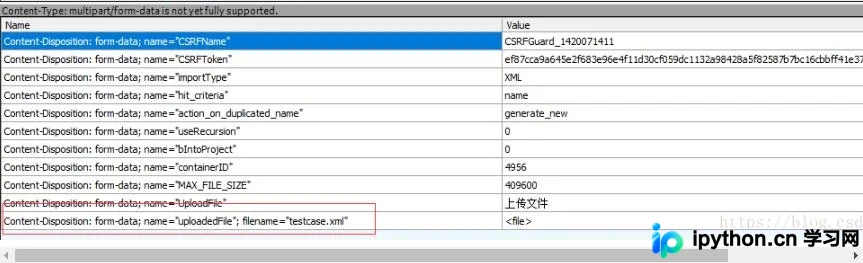
本文详解如何使用Python Requests库调用包含文件参数的接口。针对Fiddler抓包显示的Form-Data结构,说明不能仅用data传参,需将文件参数通过files字典传递。通过对比抓包结果验证请求一致性,确保文件上传逻辑正确。
本文介绍如何利用Python将浏览器开发者工具中复制的原始Headers字符串转换为标准的字典格式,并进一步序列化为JSON字符串。通过字符串分割与字典生成式技术,自动处理键值对提取及协议头修正,适用于网络爬虫调试与接口开发场景。
本文详解如何使用Python的requests库发送JSON格式数据。通过修改headers中的Content-Type为application/json,并利用json.dumps()将字典转换为JSON字符串,即可正确发送POST请求,适用于爬虫及接口测试场景。
本文介绍如何利用Python的requests库判断计算机是否拥有网络连接。通过安装requests第三方库,编写简单函数尝试访问百度并设置超时时间,若成功则返回真,否则捕获异常返回假。该实例代码简洁,适合初学者参考学习网络状态检测的基本方法。
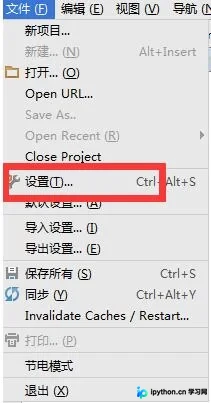
本文介绍在PyCharm中无需使用pip即可安装第三方库的方法。通过文件设置进入Project Interpreter,利用内置搜索功能添加模块。注意Python 3.x环境下可能无法直接搜索到如urllib2等仅适用于2.x版本的库,需根据实际需求调整解释器或查阅相关资料。
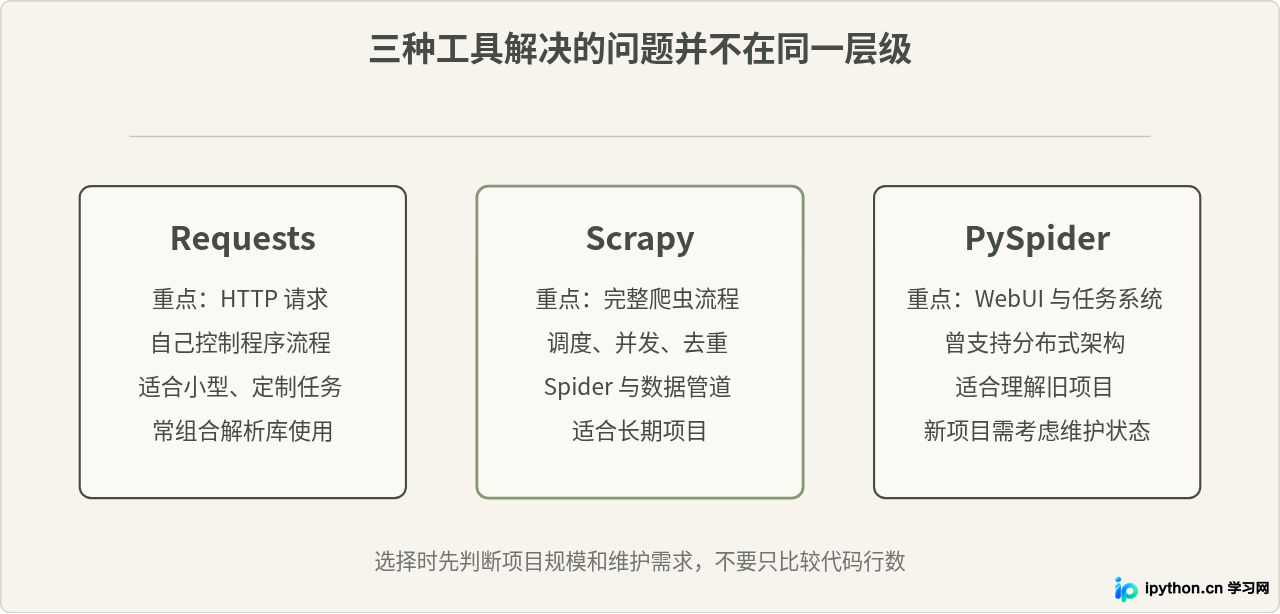
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。
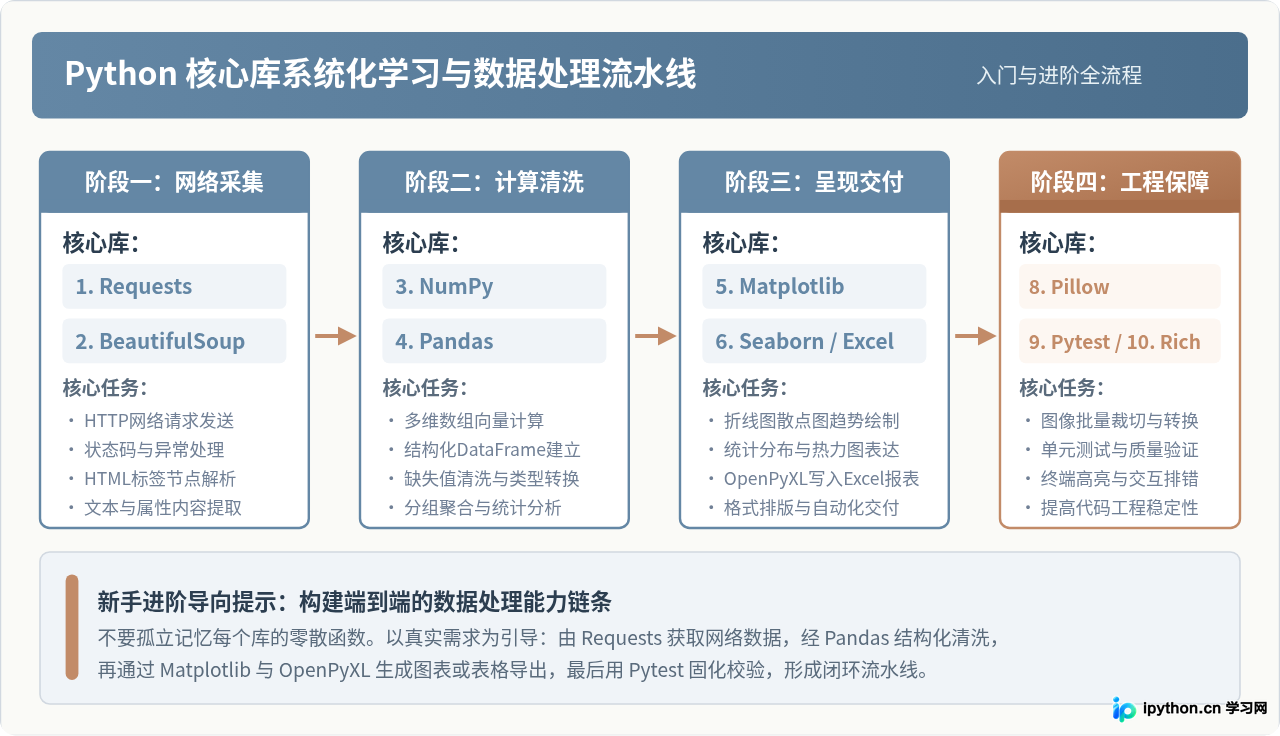
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
本文详细介绍 Python requests 库中 params、data 和 files 参数的使用方法,涵盖 GET 查询、表单提交及文件上传。同时解析 Django 后端如何通过 request.GET、request.POST 和 request.FILES 接收对应数据,并对比直接取值与 get 方法的异常处理差异。