Python爬取网页的详细步骤与代码实例教程
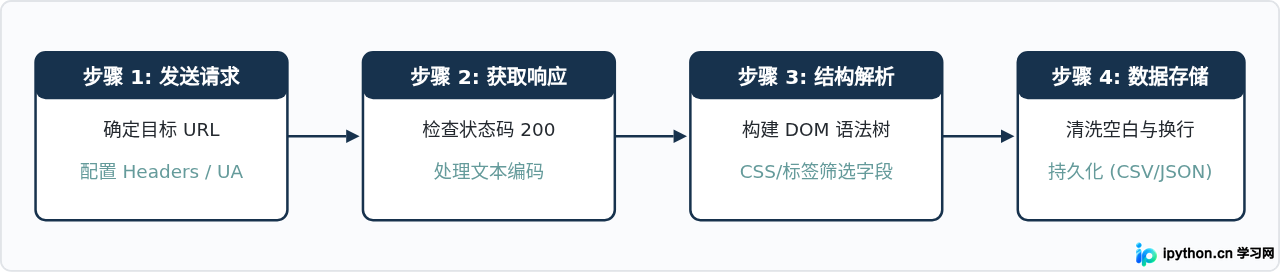
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
2026-10-15
38

一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
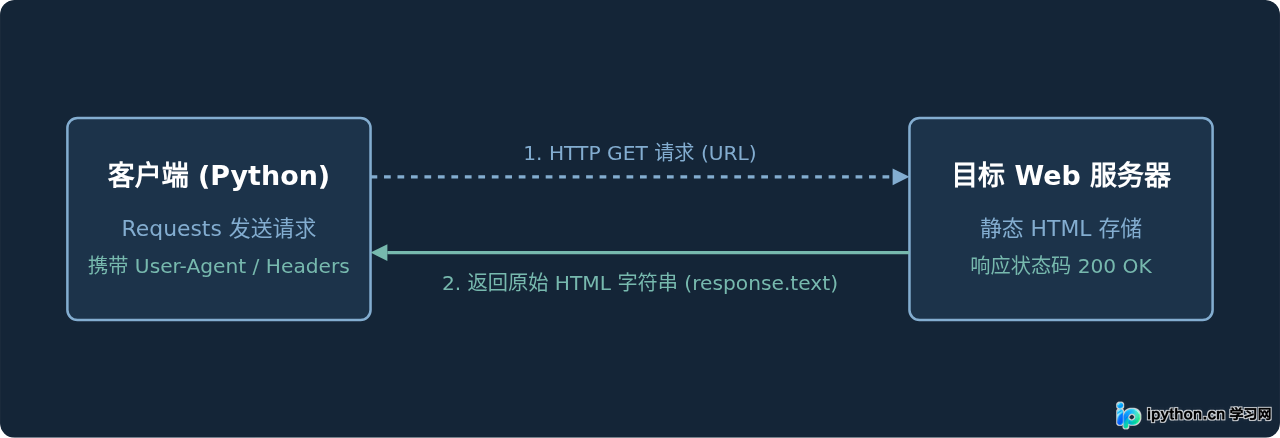
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
本文总结了在Python接口测试中保持登录状态的三种常用方法。第一种为手动注入已获取的Cookie,适用于已知凭证的场景;第二种通过调用登录接口并从响应对象中提取Cookies供后续请求使用;第三种利用requests.Session()实例自动管理Cookie,实现跨请求的状态保持。这三种方式各有适用场景,可根据实际需求选择。
本文提供Python实现的百度贴吧图片爬取完整示例。代码涵盖贴吧名称、页码范围输入,利用urllib构造请求URL,通过lxml解析HTML获取图片链接,并使用requests下载图片保存至本地。示例包含完整的类定义与执行逻辑,供Python学习者参考。
本文详解如何使用Python的requests库发送JSON格式数据。通过修改headers中的Content-Type为application/json,并利用json.dumps()将字典转换为JSON字符串,即可正确发送POST请求,适用于爬虫及接口测试场景。
本文介绍如何利用Python的requests库判断计算机是否拥有网络连接。通过安装requests第三方库,编写简单函数尝试访问百度并设置超时时间,若成功则返回真,否则捕获异常返回假。该实例代码简洁,适合初学者参考学习网络状态检测的基本方法。
本文解决Python在VSCode中使用requests库时出现的could not be resolved报错。通过pip list检查安装状态,若未安装则执行pip install requests。针对VSCode环境,需修改.vscode/settings.json文件,将python.analysis.extraPaths指向正确的site-packages路径,即可解决模块无法解析的问题。

本文详细介绍 Python requests 库中 params、data 和 files 参数的使用方法,涵盖 GET 查询、表单提交及文件上传。同时解析 Django 后端如何通过 request.GET、request.POST 和 request.FILES 接收对应数据,并对比直接取值与 get 方法的异常处理差异。
本文详解Python中利用requests库进行外部接口调用的完整流程,涵盖Get与Post请求的多种参数提交方式(Form、JSON、文件上传)。结合Flask框架演示接口接收逻辑,重点解析SSL证书验证、数据序列化及中文编码处理等关键细节,提供可直接运行的代码示例。
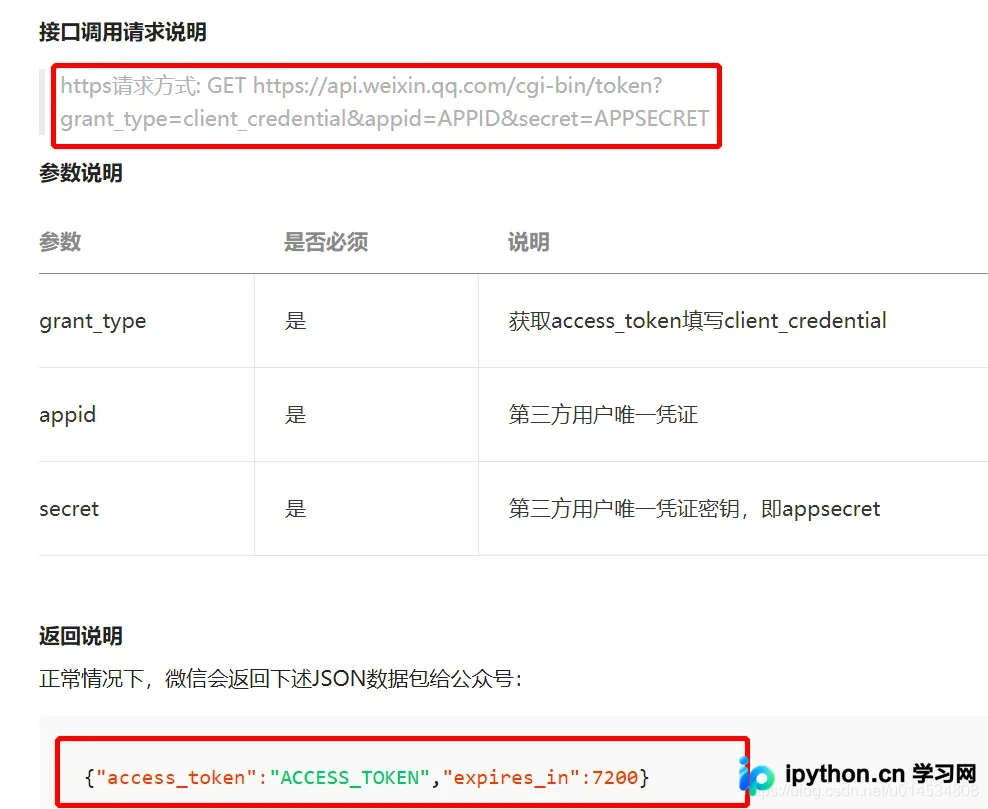
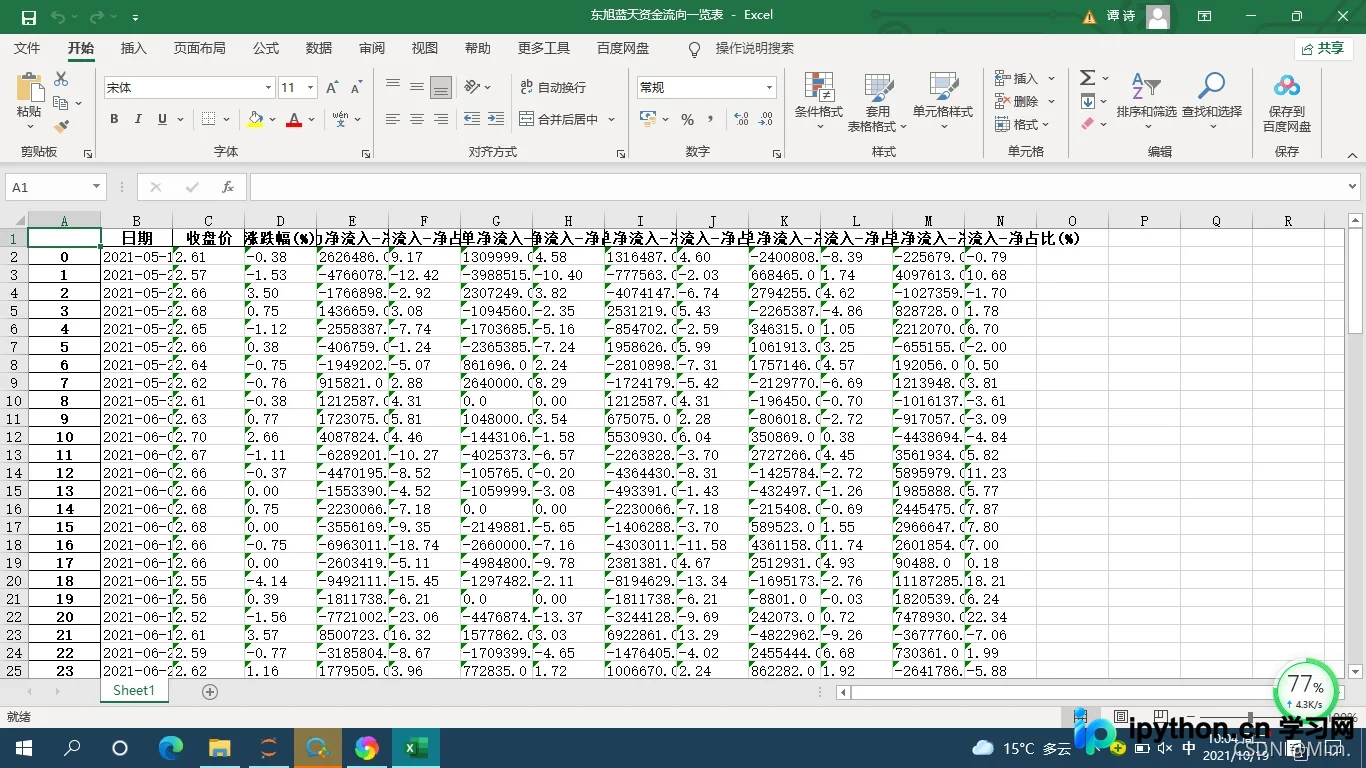
本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。
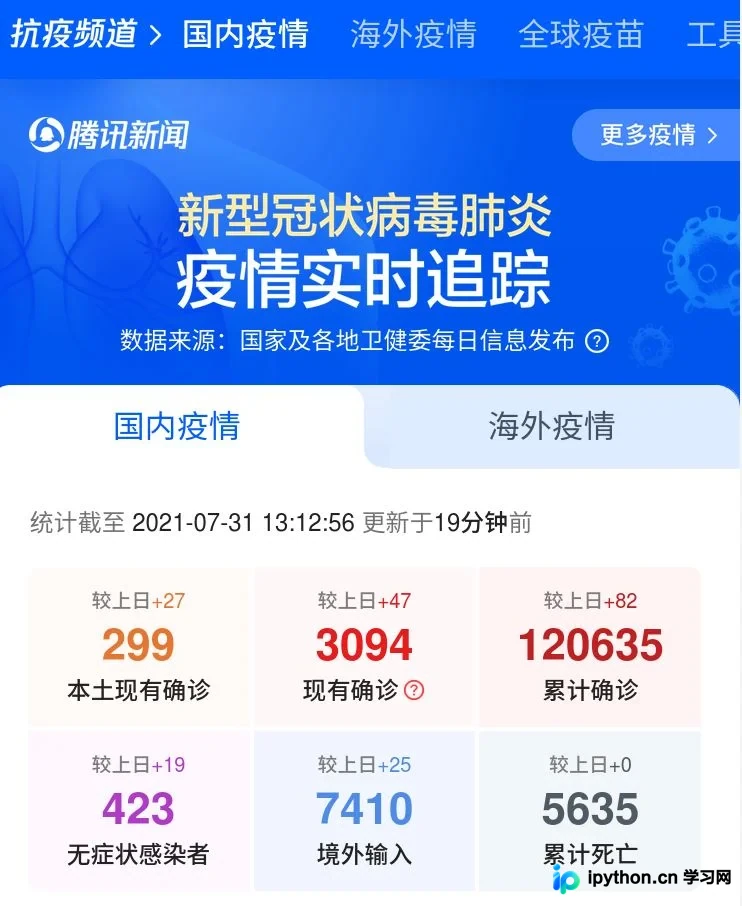
本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。