

Python爬虫实战:使用Requests与BeautifulSoup抓取笔趣阁小说

发布时间:2026-10-14| 5人浏览过
本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。
前言
为了在工作间隙方便阅读,本文分享一个使用Python编写的笔趣阁小说爬虫程序。这既是一个实用的工具,也是学习Python网络请求与数据解析的典型案例。
一、首先导入相关的模块
import os
import requests
from bs4 import BeautifulSoup
二、向网站发送请求并获取网站数据
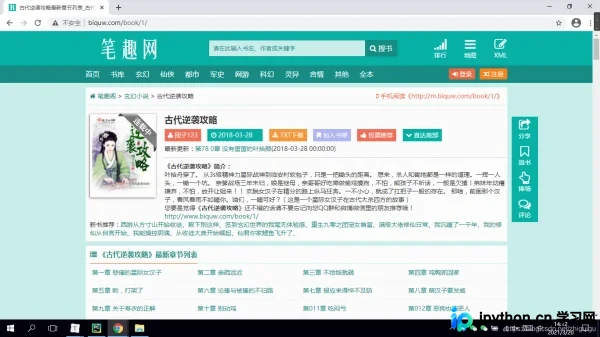
目标网站URL末尾的数字代表小说ID,每个ID对应一部特定的小说。本文以ID为1的小说为例进行演示。
进入网站后,可以看到章节列表页面。我们的首要任务是编写代码抓取这些章节的名称。
# 声明请求头
headers = {
	'User-Agent': 'Mozilla/5.0 (Windows NT 10.0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.182 Safari/537.36'
}

# 创建保存小说文本的文件夹
if not os.path.exists('./小说'):
    os.mkdir('./小说/')

# 访问网站并获取页面数据
response = requests.get('http://www.biquw.com/book/1/').text
print(response)
在实际操作中,初学者可能会发现直接访问网站返回的数据出现乱码。
这是由于网页HTML的编码格式与Python默认使用的UTF-8解码方式不一致所致。页面可能采用GBK或GB2312编码。因此,我们需要在代码中根据页面的实际编码格式动态调整解码方式,以确保中文数据正确显示。
#### 重新编写访问代码
```python
response = requests.get('http://www.biquw.com/book/1/')
response.encoding = response.apparent_encoding
print(response.text)

'''
这种方式返回的中文数据才是正确的
'''
三、拿到页面数据之后对数据进行提取
通过正确的编码方式获取网页源码后,接下来需要对静态页面结构进行分析,从HTML数据中提取出我们需要的章节列表信息。
1.首先打开浏览器
2.按F12调出开发者工具
3.选中元素选择器
4.在页面中选中我们想要的数据并定位元素
5.观察数据所存在的元素标签
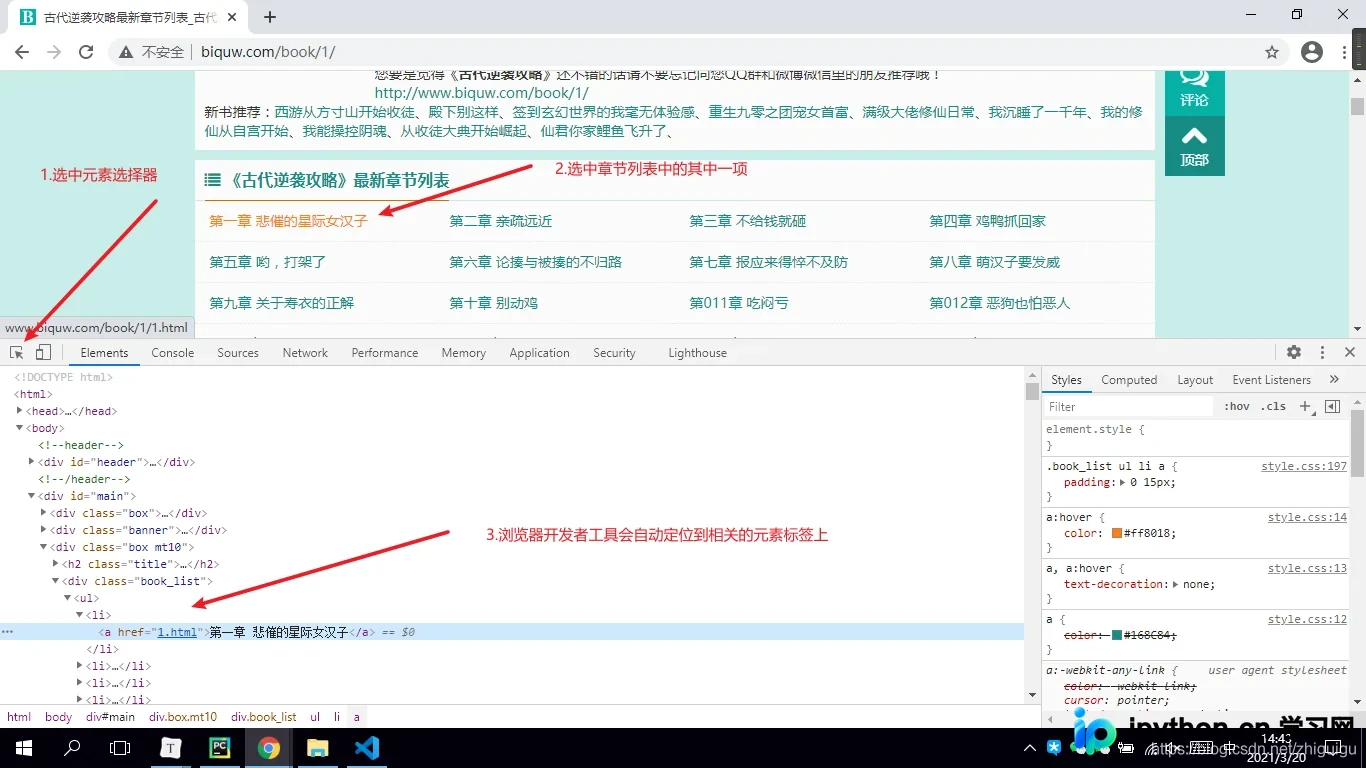
'''
根据上图所示,数据是保存在a标签当中的。a的父标签为li,li的父标签为ul标签,ul标签之上为div标签。所以如果想要获取整个页面的小说章节数据,那么需要先获取div标签。并且div标签中包含了class属性,我们可以通过class属性获取指定的div标签,详情看代码~
'''
# lxml: html解析库 将html代码转成python对象,python可以对html代码进行控制
soup = BeautifulSoup(response.text, 'lxml')
book_list = soup.find('div', class_='book_list').find_all('a')
# soup对象获取批量数据后返回的是一个列表,我们可以对列表进行迭代提取
for book in book_list:
    book_name = book.text
    # 获取到列表数据之后,需要获取文章详情页的链接,链接在a标签的href属性中
    book_url = book['href']
四、获取到小说详情页链接之后进行详情页二次访问并获取文章数据
book_info_html = requests.get('http://www.biquw.com/book/1/' + book_url, headers=headers)
book_info_html.encoding = book_info_html.apparent_encoding
soup = BeautifulSoup(book_info_html.text, 'lxml')
五、对小说详情页进行静态页面分析
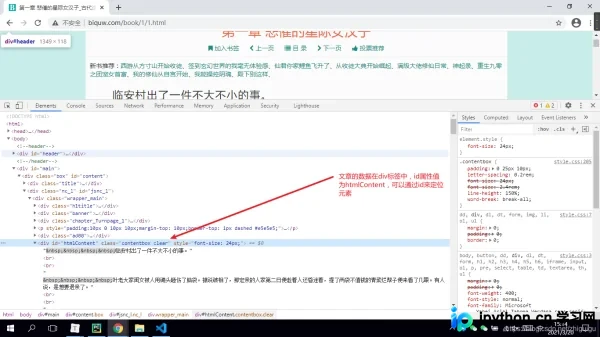
info = soup.find('div', id='htmlContent')
print(info.text)
六、数据下载
with open('./小说/' + book_name + '.txt', 'a', encoding='utf-8') as f:
    f.write(info.text)
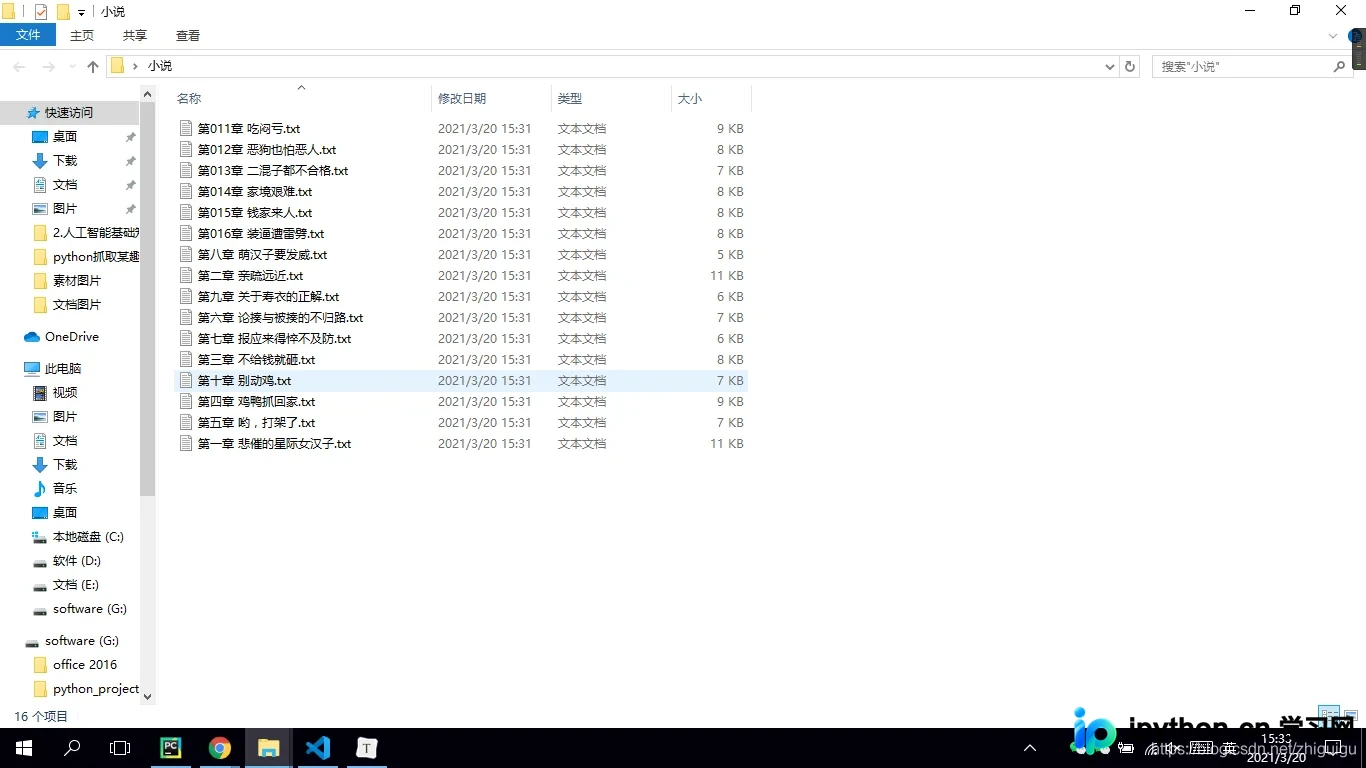
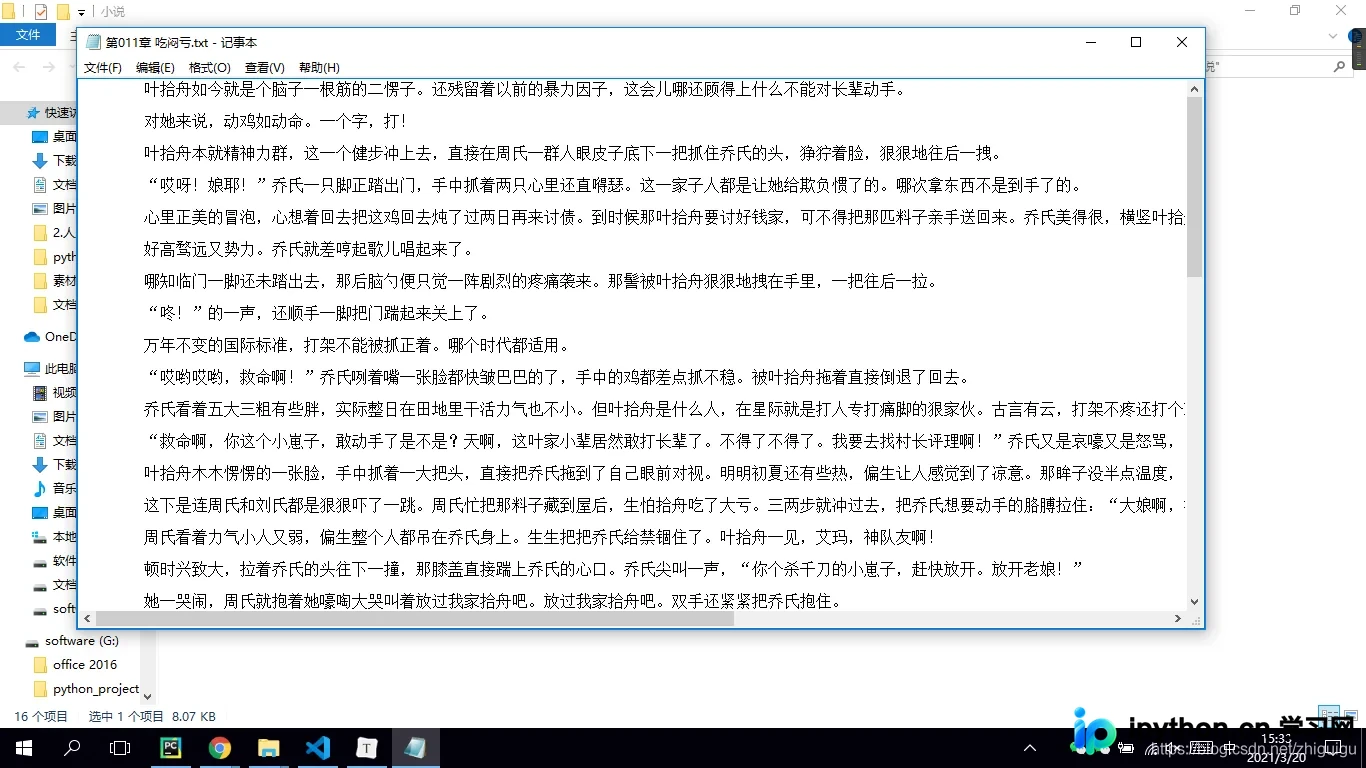
最后让我们看一下代码效果吧~
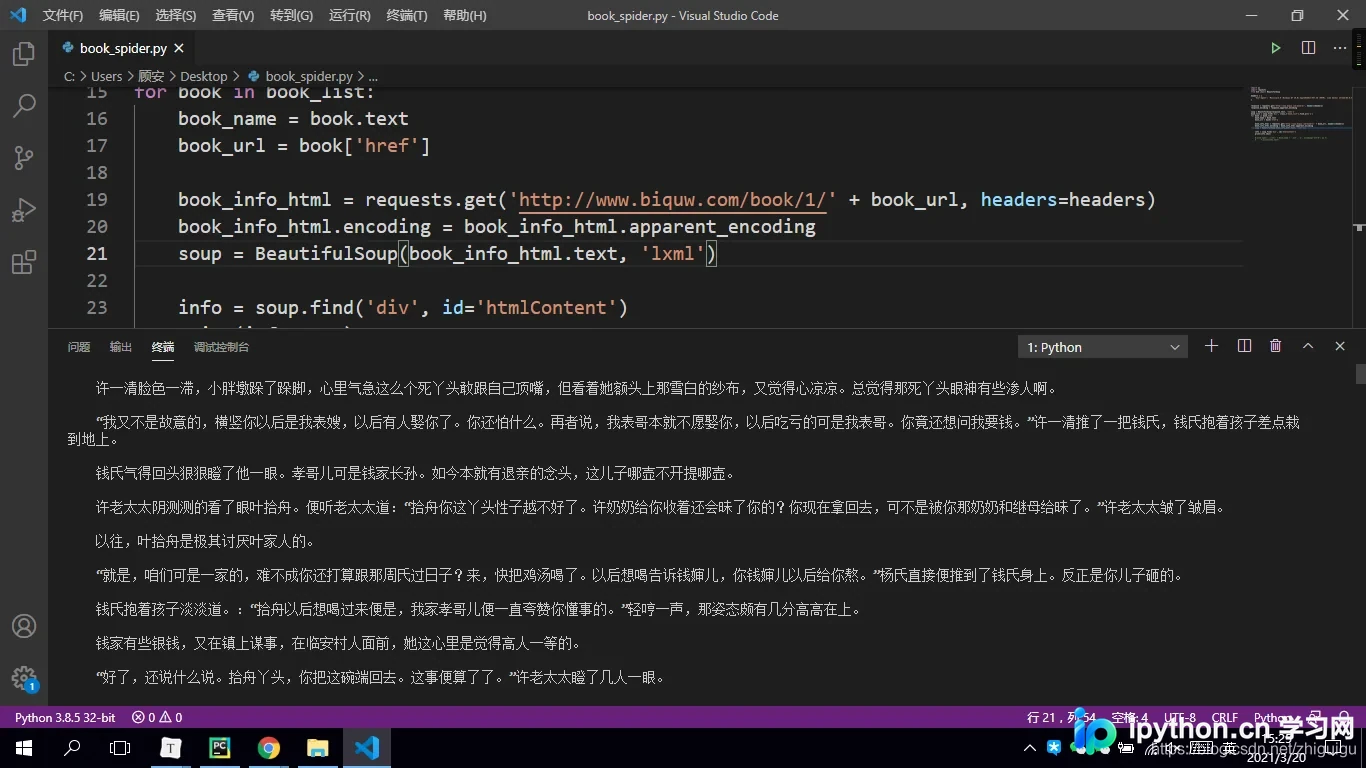
抓取的数据
到此这篇关于python爬虫之爬取笔趣阁小说的文章就介绍到这了,更多相关python爬取小说内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









