Python爬虫实战:抓取猫眼电影实时票房数据
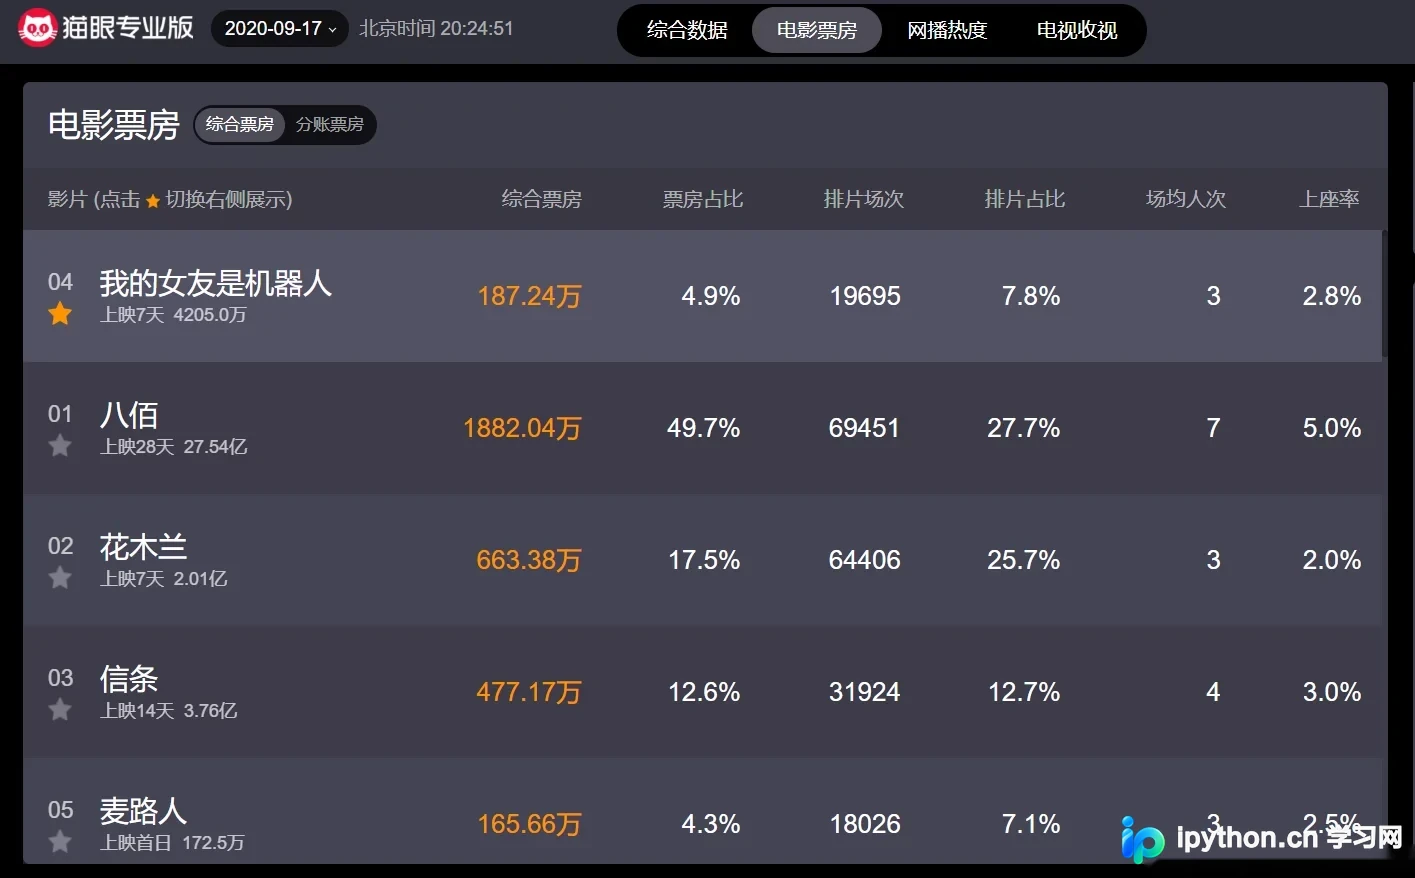
本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。
2026-10-15
5

本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。
本文详细介绍如何使用Python的requests模块调用远程接口。内容涵盖模块安装、GET请求的参数配置(url、params、headers)及代码示例,以及POST请求的数据提交方式与完整实现。通过具体代码片段,帮助开发者快速掌握Python发起HTTP请求的核心技巧。
本文详细介绍Python中requests库进行接口测试的核心用法。涵盖GET与POST请求的参数传递方式,重点解析params、data与json三者的区别及适用场景。同时讲解如何利用requests.Session()保持会话状态,并演示如何获取状态码、响应头、编码格式及JSON数据等关键响应信息,帮助开发者快速掌握接口自动化测试基础。
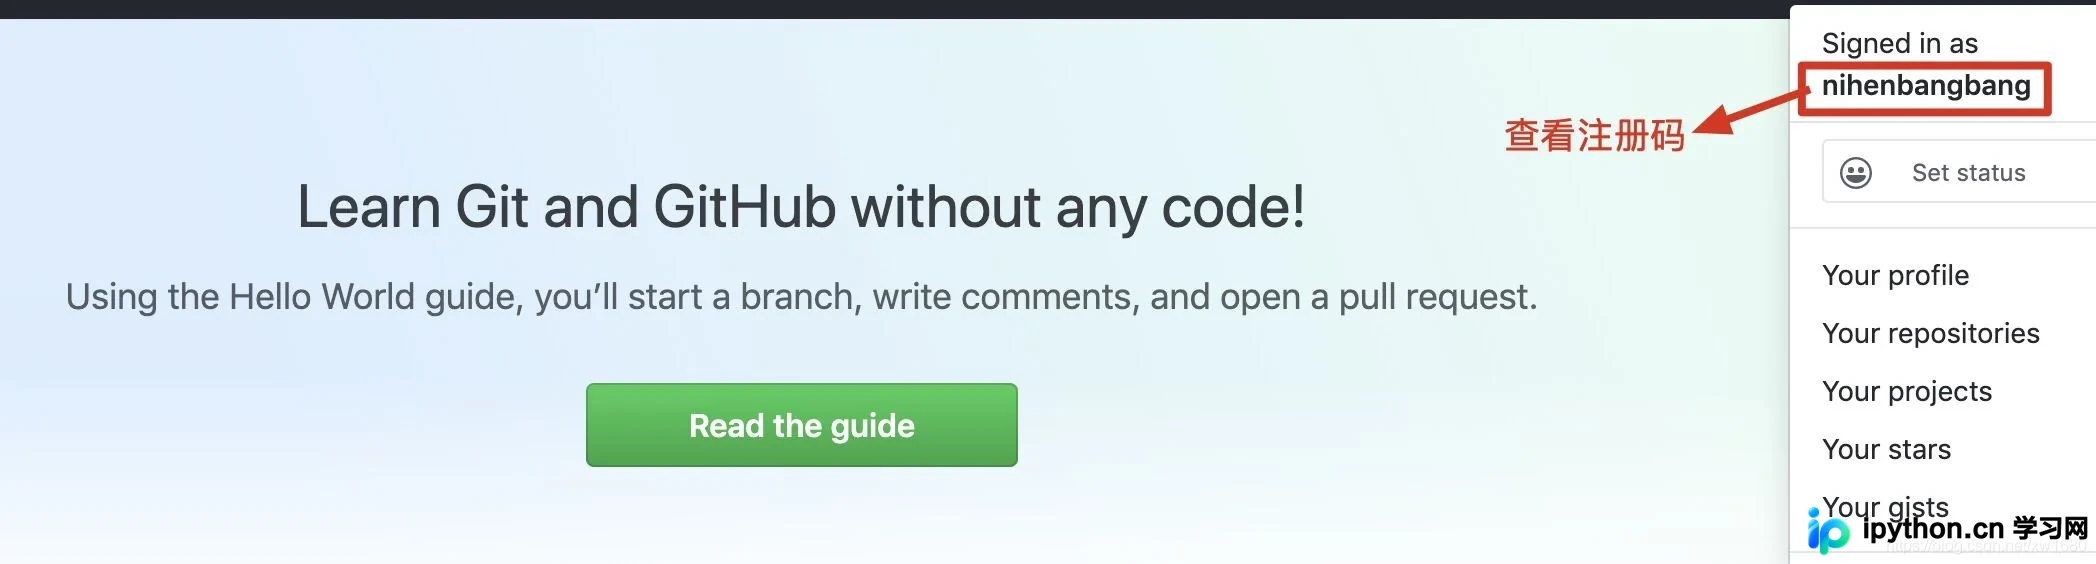
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
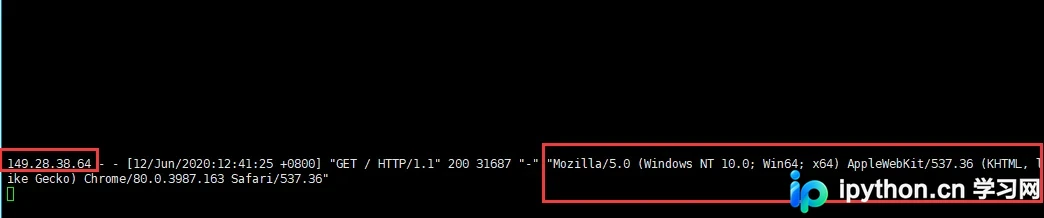
本文介绍Python3中requests库的基本特性及其在模拟浏览器行为中的应用。通过具体代码示例,详细讲解如何配置User-Agent、代理服务器及处理HTTP请求,帮助开发者实现更灵活的网络数据抓取与交互操作。
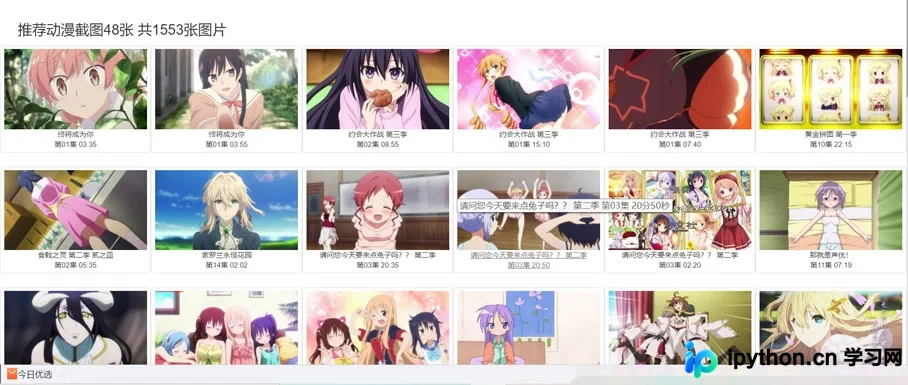
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文介绍如何在 Python 中通过 PySocks 库配置 SOCKS5 全局代理。首先讲解 pip 安装方法,随后通过代码示例展示如何替换默认 socket 以启用代理。最后提供完整的测试脚本,演示在启用代理后访问外部网站(如 Google)的效果,帮助开发者快速实现网络请求的代理转发。
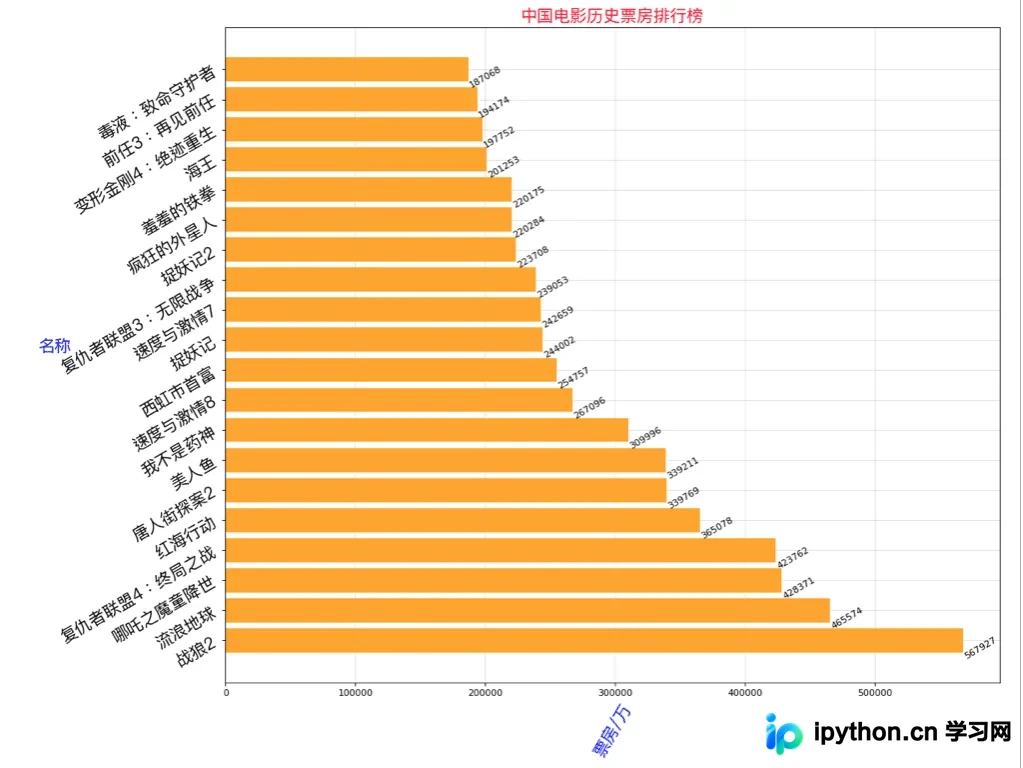
本文通过Python实现电影历史票房数据的抓取与可视化展示。利用requests库请求指定API获取JSON数据,结合matplotlib库绘制横向条形图。代码采用面向对象设计,封装了请求、解析及绘图逻辑,可直接运行查看结果,适合Python初学者参考学习。
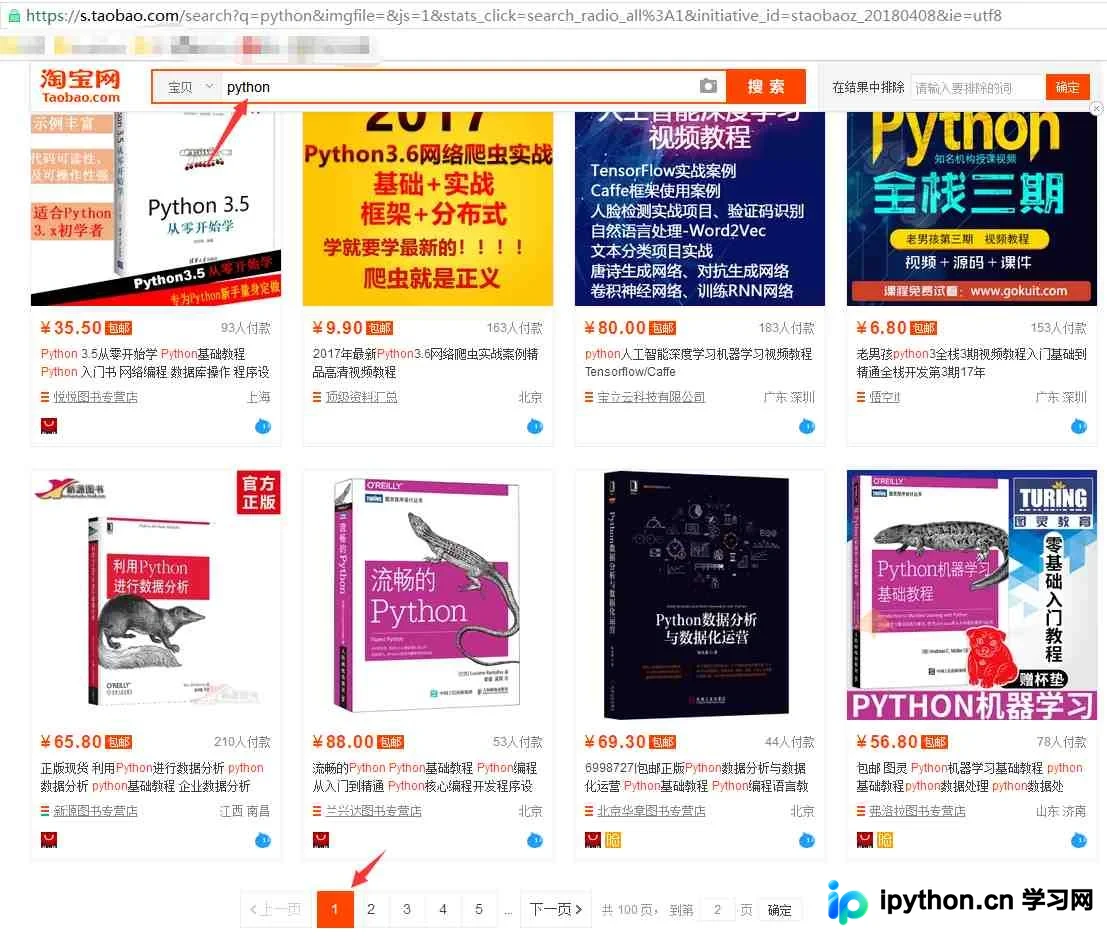
本文详细介绍如何使用Python的requests和re库爬取淘宝商品列表。通过解析URL参数q和s,构建分页请求,利用正则表达式精准提取raw_title和view_price字段。代码示例展示了从获取HTML源码、解析数据到存储结果的完整流程,适合Python初学者学习网络爬虫基础。
本文介绍了使用Python自动访问网页的两种方法。第一种利用requests库结合IP池和User-Agent随机化,模拟浏览器请求以规避简单反爬;第二种通过socket直接构建TCP连接并发送原始HTTP报文,解析响应体保存为HTML文件。代码包含完整实现细节,供开发者参考。
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。