Python3 将 bytes 格式图片保存为本地 JPG 文件的方法
本文介绍在 Python3 环境下,如何将爬取或接口返回的 bytes 格式图片数据直接保存为本地 JPG 文件。文章提供了两种主要实现方式:一是利用 urllib 库的 urlretrieve 方法直接下载保存;二是结合 requests 获取内容,并通过 PIL (Pillow) 库将字节流转换为图像对象后保存。文中包含具体的代码示例,涵盖从网络请求到本地文件写入的完整流程,适用于爬虫数据处理及 API 图像存储场景。
本文介绍使用Python爬取好看视频平台搞笑栏目短视频的方法。针对网站懒加载特性,通过构造API请求获取视频列表,解析标题与播放地址,并利用requests库下载保存视频文件。

本文介绍如何在 Python 的 Requests 库中正确发送携带 Cookies 的请求。通过构造 RequestsCookieJar 对象并更新 Session,实现 Cookie 的持久化与复用。结合具体监控平台消息下发的案例,展示了从加载 Cookie、发送带时间戳的消息到根据状态码触发邮件报警的完整流程,适用于需要维持登录状态的接口自动化测试场景。

本文汇总了 Python 中下载文件的多种实现方式,涵盖 requests、wget 及 urllib 等常用库。重点解析了处理重定向、大文件分块下载、多线程并行加速以及添加进度条等实用技巧,并提供了通过代理服务器下载国外资源的配置方案,帮助开发者高效完成文件获取任务。
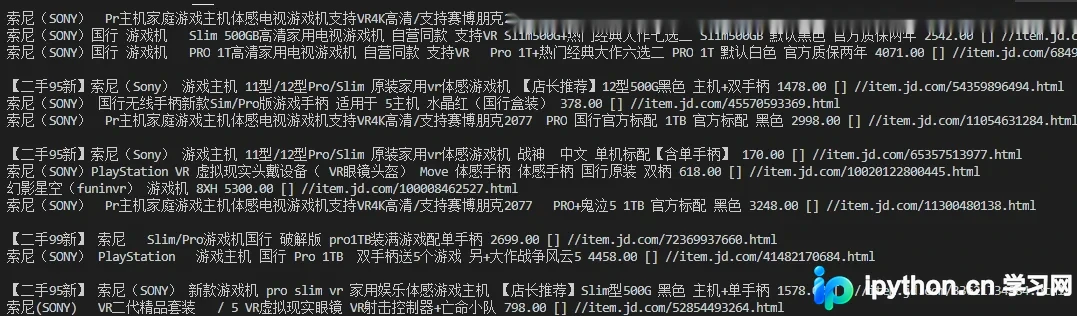
本文介绍使用 Python 编写爬虫程序,通过 requests 发送请求并配合 lxml 解析 HTML 结构,从京东搜索页面提取 PS4 商品名称、价格、评论数及链接等关键信息。代码包含完整的请求头设置与数据清洗逻辑,适用于电商数据抓取学习。

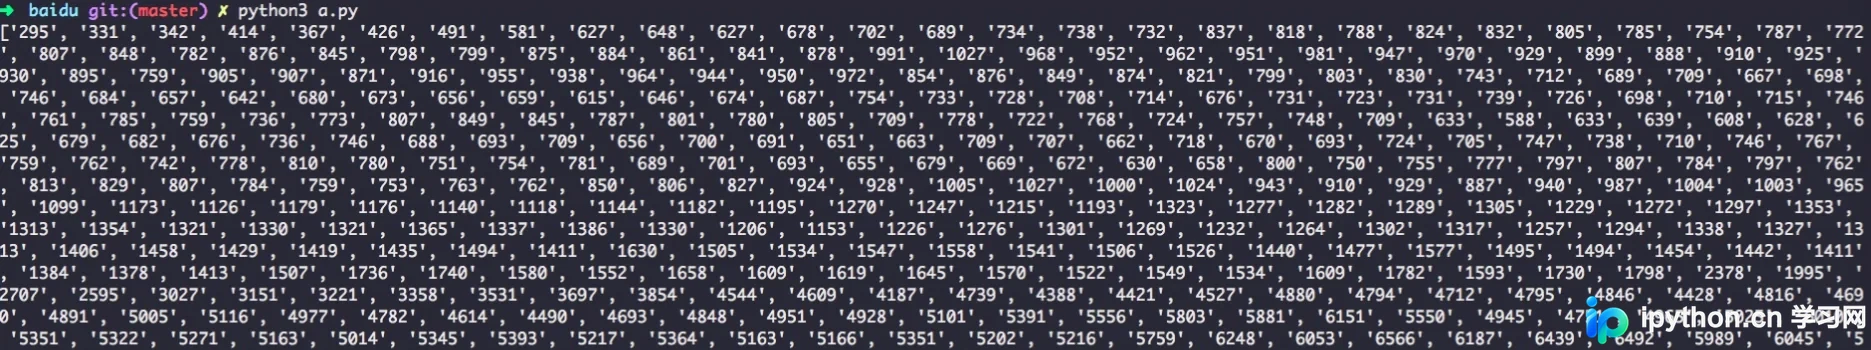
本文详细讲解如何使用Python爬虫获取百度指数数据。针对百度指数接口变更的情况,提供了包含请求头设置、Cookie处理及数据解密逻辑的完整代码示例。通过解析API返回的加密数据,实现关键词搜索量的获取,适用于数据分析及股票趋势观察等场景。

本文介绍Python爬虫在遇到登录验证(如验证码、拖拽)时的两种主流解决方案:Cookie注入与模拟登录。通过获取浏览器Cookie并利用requests库复用会话,可绕过多数验证机制;同时简述基于requests的模拟登录思路。文中包含完整代码示例,展示如何配置代理、设置Cookie及处理登录状态,帮助开发者高效解决登录墙问题。
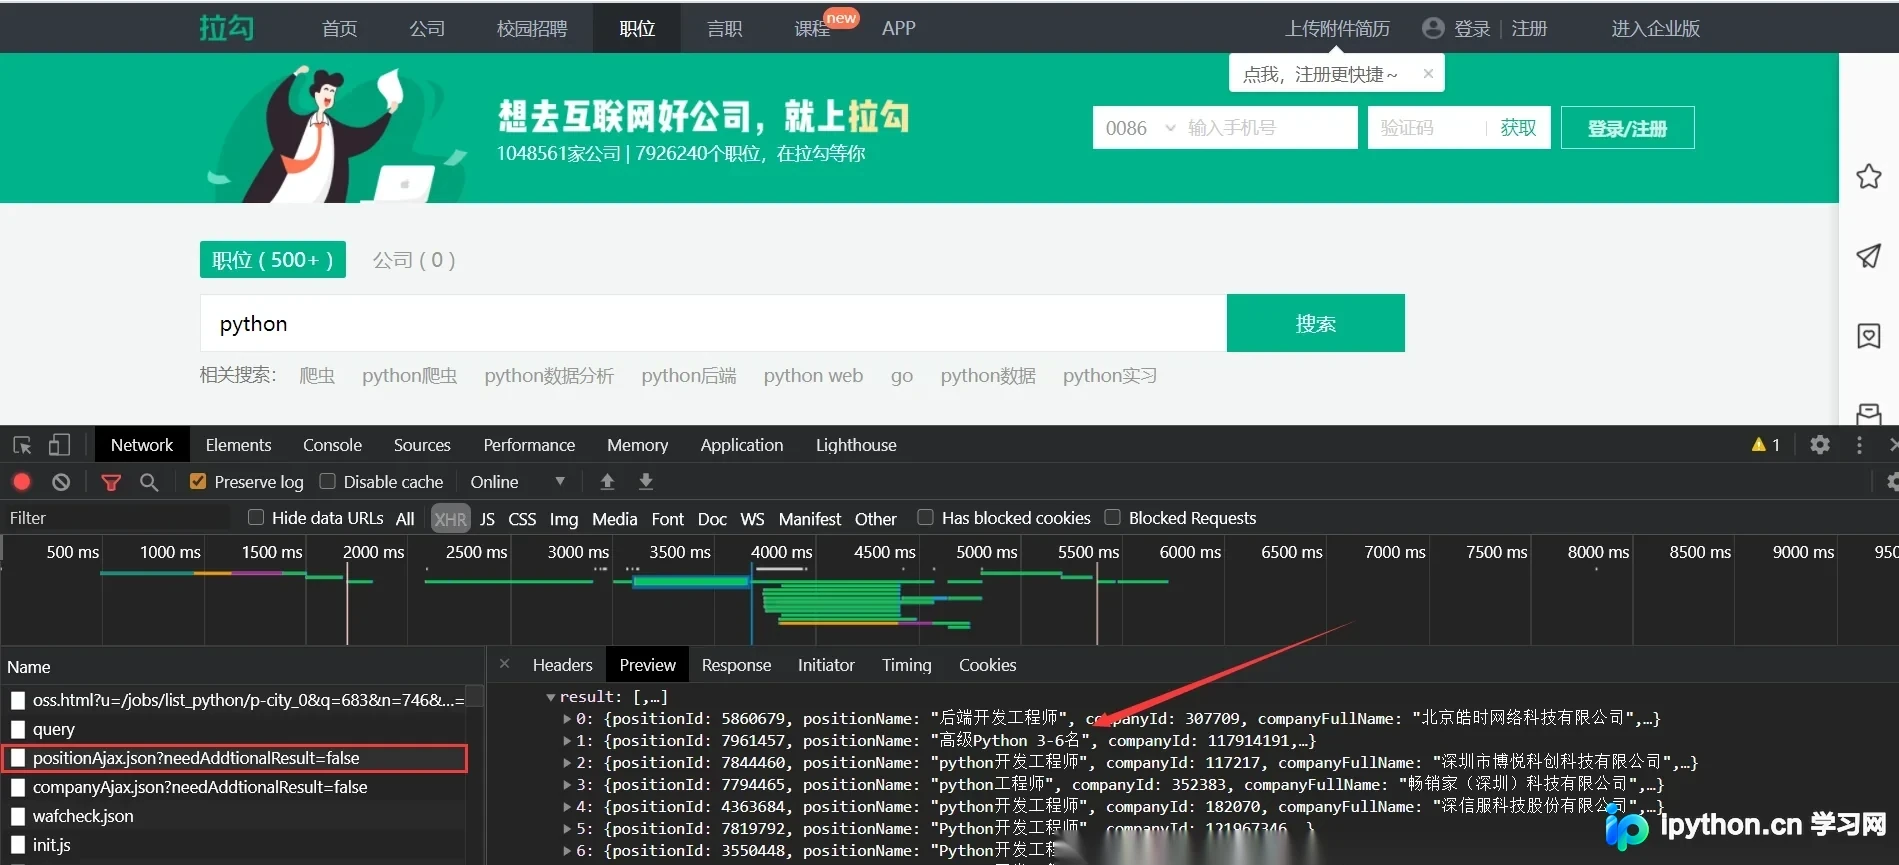
本文详细解析使用Python Requests库爬取拉勾网招聘信息的完整流程。重点解决接口返回操作频繁错误的问题,通过获取并动态刷新Cookies解决反爬限制。代码包含分页请求、字段提取及CSV保存功能,每十次请求自动更新Cookie,确保数据抓取的稳定性与有效性。

本文介绍如何使用Python的Requests库对文件分片上传接口进行自动化测试。通过模拟前端行为,将大文件按指定大小分片,计算整体及分片MD5值,并循环调用后端接口上传各分片。最后通过对比服务器返回的MD5值来验证上传完整性与正确性,适用于Vue前端与PHP后端的系统测试场景。
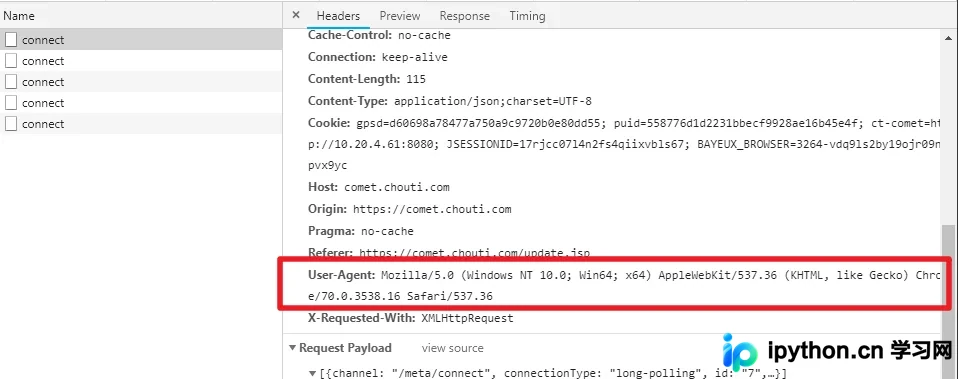
本文详细介绍Python中Requests库的核心用法,涵盖GET与POST请求的基本实例,深入解析request()方法的各类参数如params、data、json及headers配置。同时讲解如何通过User-Agent规避拦截,并对比HTTP与HTTPS的区别,阐述SSL证书在通信中的作用及verify参数的使用场景。

本文通过10个Python爬虫实例,详解requests库的get、post、put方法及其传参技巧。内容涵盖环境安装、响应对象处理、编码设置、文件保存及图片抓取,并演示如何通过修改User-Agent绕过知乎的反爬机制,适合初学者快速掌握网络数据采集基础。
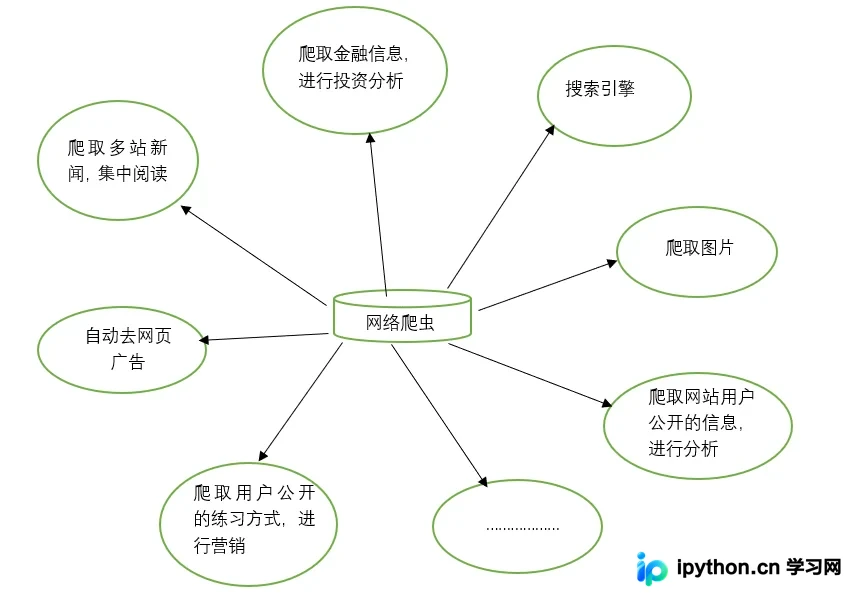
本文详细介绍Python网络爬虫的基础概念与核心功能,涵盖搜索引擎、图片抓取、金融分析及营销数据采集等应用场景。教程演示如何在Windows环境下通过pip安装requests第三方库,并提供完整的Python代码示例,展示如何获取淘宝首页HTML源码及使用BeautifulSoup进行初步数据解析,同时强调爬取频率控制与法律合规性注意事项。