

Python 爬虫实战:自动抓取彼岸桌面高清壁纸

本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。
本次爬虫项目所选取的目标网站为:
http://www.netbian.com/index.htm(彼岸桌面)。该网站收录了大量优质壁纸资源,且均提供高清无损下载,质量较高,因此非常适合作为练手对象。
作为编程初学者,在初期阶段,无论代码质量如何,只要程序能够正确且完整地运行,就能带来极大的成就感。这类似于游戏机制:当玩家能在短时间内获得正向反馈时,参与兴趣会显著提升。
学习过程亦是如此。若在短期内能观察到学习成果带来的反馈,学习者的求知欲和动力便会更加强烈。
作为一名新手,能够独立完成此次爬虫程序的编写,便是一次巨大的收获。但实际上,我在整个过程中获得的经验远不止于此。
优秀的代码通常应具备以下特性:
- 能够满足最关键的业务需求
- 逻辑清晰,易于理解
- 包含充分的注释说明
- 使用规范的变量与函数命名
- 不存在明显的安全漏洞
- 经过充分的测试验证
以充分的测试为例,经常编写代码的人应当知晓:尽管大多数时候代码看似没有 BUG,但这仅意味着在常规情况下运行稳定。然而,在特定条件触发或存在逻辑缺陷时,程序仍可能出错。这是客观存在的现象。至于具体原因,不同代码表现各异。若软件能一次性完美无缺,便无需频繁更新迭代。其余道理不一一赘述,时间自会证明一切。
优质代码一般具备以下五大特性:
1. 便于维护 2. 具备可复用性 3. 支持扩展 4. 具有强灵活性 5. 高健壮性
通过运行我的代码发现,其时间复杂度较高,因此这是我后续重点改进的方向。此外,代码中还存在许多利用不合理之处,这些不足之处有待我逐步提升并优化。
欢迎各位路过的大佬留下宝贵的代码修改建议,
完整代码如下
import os
import bs4
import re
import time
import requests
from bs4 import BeautifulSoup

def getHTMLText(url, headers):
  """向目标服务器发起请求并返回响应"""
  try:
    r = requests.get(url=url, headers=headers)
    r.encoding = r.apparent_encoding
    soup = BeautifulSoup(r.text, "html.parser")
    return soup
  except:
    return ""

def CreateFolder():
  """创建存储数据文件夹"""
  flag = True
  while flag == 1:
    file = input("请输入保存数据文件夹的名称:")
    if not os.path.exists(file):
      os.mkdir(file)
      flag = False
    else:
      print('该文件已存在,请重新输入')
      flag = True

  # os.path.abspath(file) 获取文件夹的绝对路径
  path = os.path.abspath(file) + "\\"
  return path

def fillUnivList(ulist, soup):
  """获取每一张图片的原图页面"""
  # [0]使得获得的ul是 <class 'bs4.BeautifulSoup'> 类型
  div = soup.find_all('div', 'list')[0]
  for a in div('a'):
    if isinstance(a, bs4.element.Tag):
      hr = a.attrs['href']
      href = re.findall(r'/desk/[1-9]\d{4}.htm', hr)
      if bool(href) == True:
        ulist.append(href[0])

  return ulist

def DownloadPicture(left_url,list,path):
  for right in list:
    url = left_url + right
    r = requests.get(url=url, timeout=10)
    r.encoding = r.apparent_encoding
    soup = BeautifulSoup(r.text,"html.parser")
    tag = soup.find_all("p")
    # 获取img标签的alt属性,给保存图片命名
    name = tag[0].a.img.attrs['alt']
    img_name = name + ".jpg"
    # 获取图片的信息
    img_src = tag[0].a.img.attrs['src']
    try:
      img_data = requests.get(url=img_src)
    except:
      continue

    img_path = path + img_name
    with open(img_path,'wb') as fp:
      fp.write(img_data.content)
    print(img_name, "  ******下载完成!")

def PageNumurl(urls):
  num = int(input("请输入爬取所到的页码数:"))
  for i in range(2,num+1):
    u = "http://www.netbian.com/index_" + str(i) + ".htm"
    urls.append(u)

  return urls


if __name__ == "__main__":
  uinfo = []
  left_url = "http://www.netbian.com"
  urls = ["http://www.netbian.com/index.htm"]
  headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.90 Safari/537.36"
  }
  start = time.time()
  # 1.创建保存数据的文件夹
  path = CreateFolder()
  # 2. 确定要爬取的页面数并返回每一页的链接
  PageNumurl(urls)
  n = int(input("访问的起始页面:"))
  for i in urls[n-1:]:
    # 3.获取每一个页面的首页数据文本
    soup = getHTMLText(i, headers)
    # 4.访问原图所在页链接并返回图片的链接
    page_list = fillUnivList(uinfo, soup)
    # 5.下载原图
    DownloadPicture(left_url, page_list, path)

  print("全部下载完成!", "共" + str(len(os.listdir(path))) + "张图片")
  end = time.time()
  print("共耗时" + str(end-start) + "秒")
运行
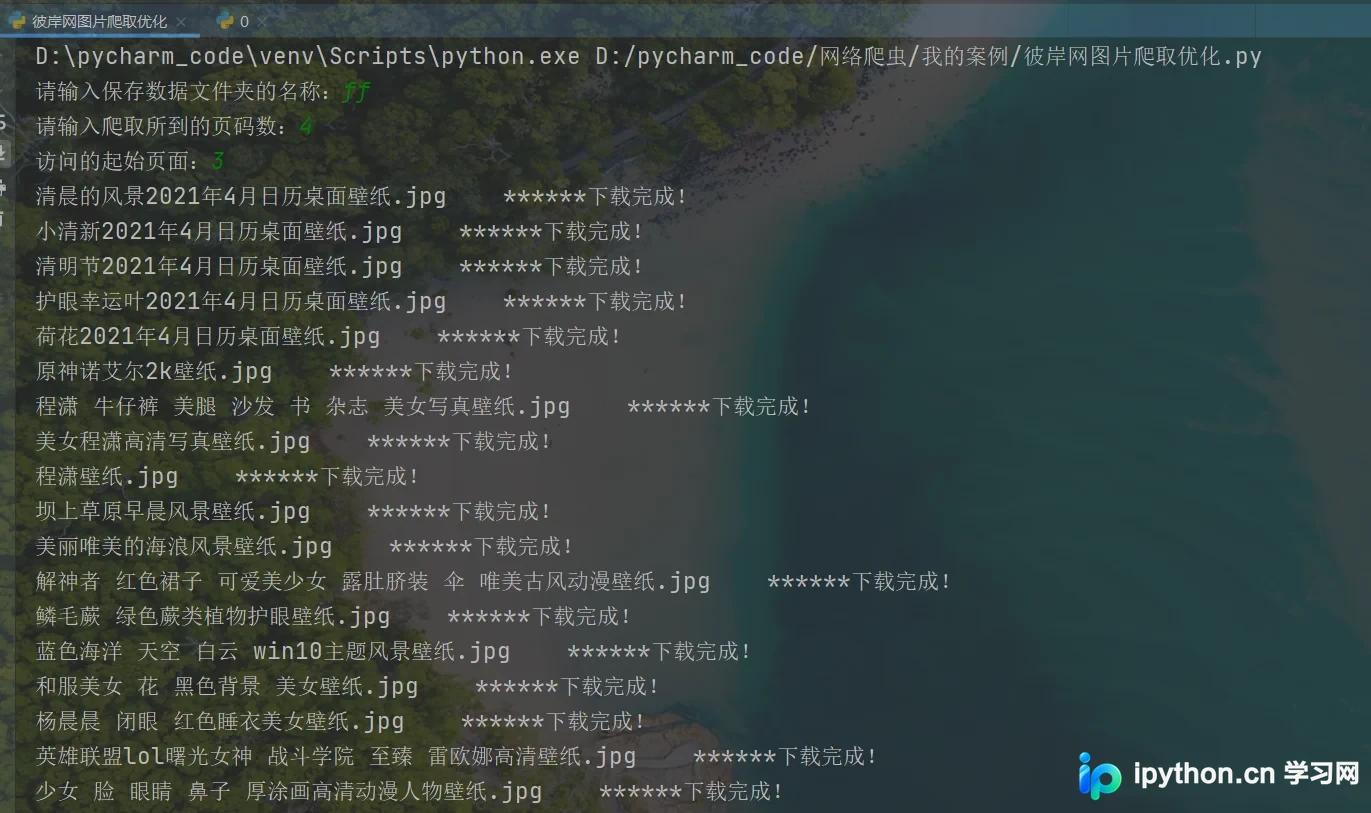
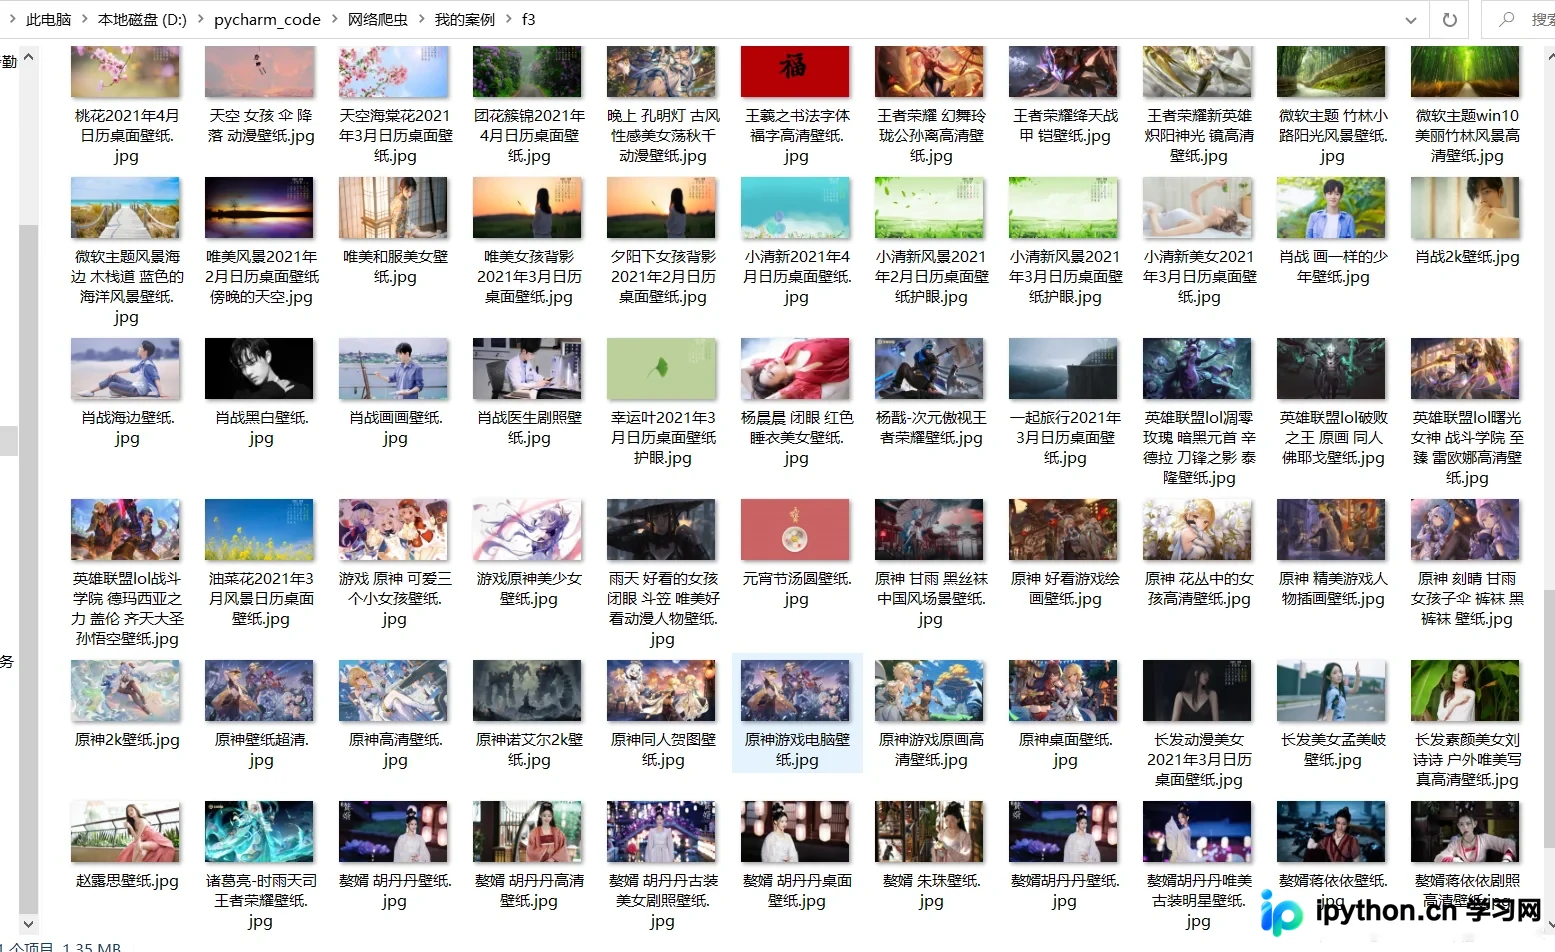
部分展示结果如下:
以上就是 Python 爬取壁纸网站示例的详细内容,更多关于 Python 爬取壁纸网站的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









