

Python 爬取学信网登录页面的实现方法
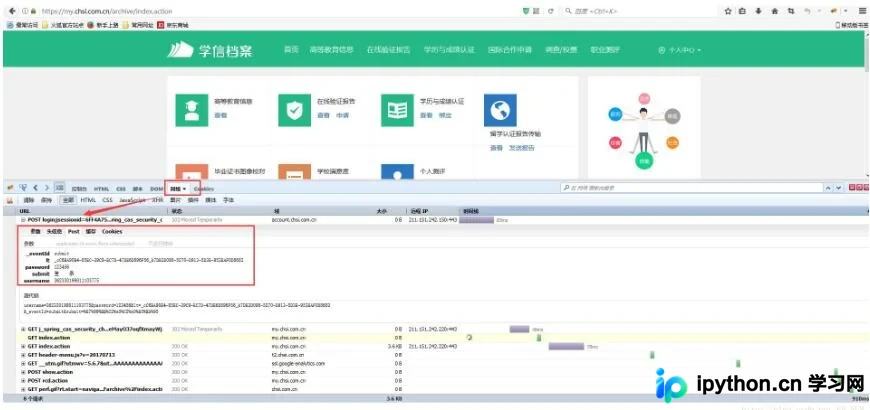
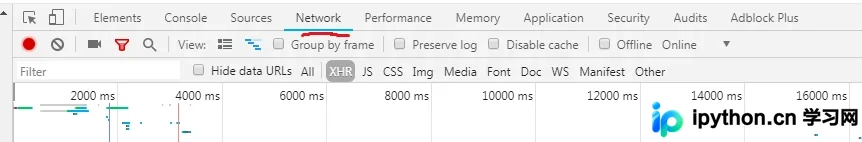
本文以学信网为例,详细介绍如何使用 Python 模拟登录并爬取个人信息。通过 Firefox 开发者工具分析网络请求,定位 POST 提交链接及表单参数,利用 requests 库和 BeautifulSoup 构造会话与提交数据,最终实现自动登录并解析页面表格内容,为类似网站的爬虫开发提供参考。
2026-10-13
6

本文以学信网为例,详细介绍如何使用 Python 模拟登录并爬取个人信息。通过 Firefox 开发者工具分析网络请求,定位 POST 提交链接及表单参数,利用 requests 库和 BeautifulSoup 构造会话与提交数据,最终实现自动登录并解析页面表格内容,为类似网站的爬虫开发提供参考。
本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
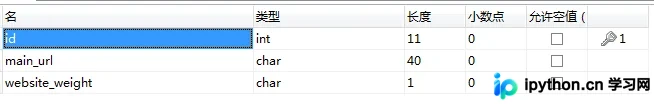
本文详细解析如何使用Python3批量查询网站百度权重。通过openpyxl读取Excel中的网址列表,利用Requests伪造请求获取seo.chinaz.com页面,并用BeautifulSoup提取权重数据。最终将结果写入MySQL数据库及Excel文件,提供完整的代码逻辑与配置说明。
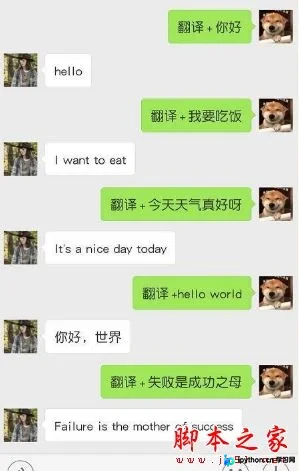
本文介绍如何利用Python的itchat库与有道翻译API,开发一个微信自动翻译机器人。通过解析用户发送的消息关键字,调用接口获取翻译结果并自动回复,实现简单的中英文互译功能。
本文详细介绍如何使用Python编写爬虫程序,通过知乎开放API获取话题下的回答列表,并利用百度云人脸检测接口对图片进行颜值评分。教程涵盖环境配置、API调用、反爬策略处理及图片保存逻辑,帮助开发者实现自动化筛选高颜值图片的功能。
本文介绍使用PHP开发简单爬虫以获取特定标题文章链接的方法。通过curl请求网页并处理编码,利用正则初步筛选a标签后,推荐使用DOMDocument类更稳定地解析HTML DOM结构,提取href属性。配合JavaScript前端展示结果,适用于特定网站的内容采集场景。
本文介绍如何使用Python的requests库结合面向对象思想,编写程序批量抓取百度贴吧指定吧前1000页的网页内容。通过封装URL生成、请求发送及HTML保存等方法,实现高效的数据采集流程,适合初学者理解爬虫基础逻辑与代码结构。
本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
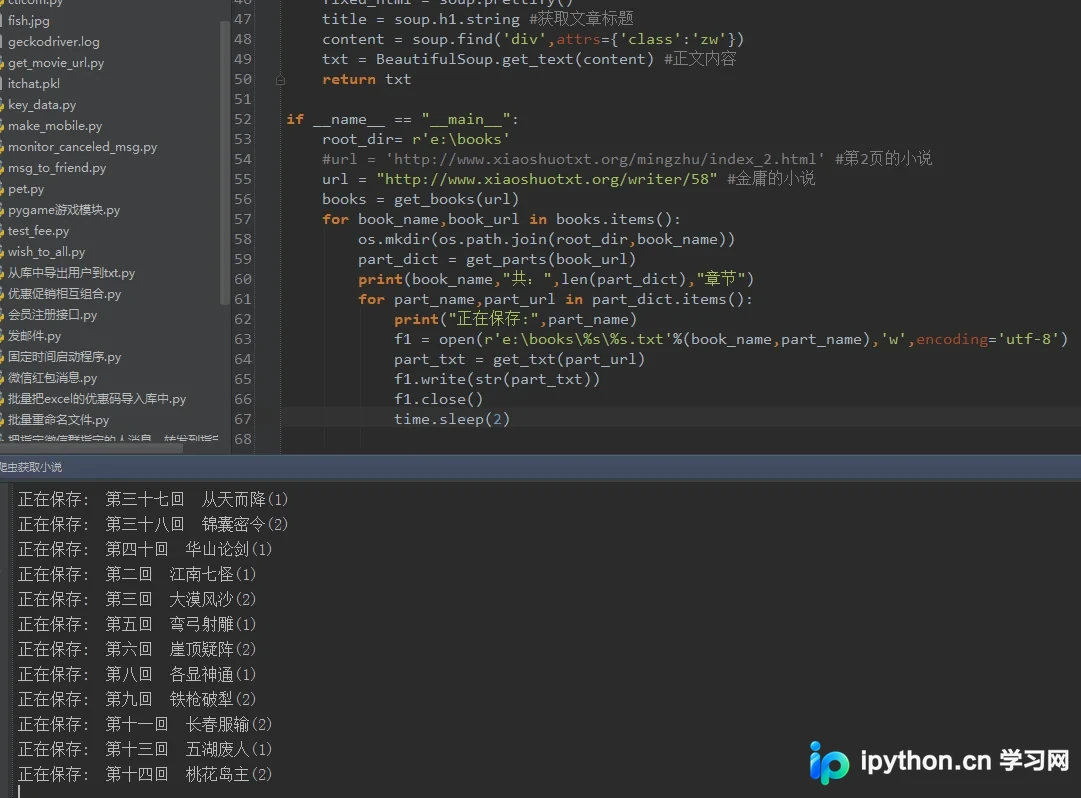
本文提供基于Python的完整爬虫示例,演示如何自动抓取金庸小说全集。通过BeautifulSoup解析网页结构,遍历章节列表并逐章下载保存为本地文本文件。代码包含URL请求、HTML解析及文件写入逻辑,适合Python初学者学习网络数据采集与文件处理实战。
本文分析Python BeautifulSoup库中常见的TypeError: list indices must be integers or slices, not str错误。该错误源于混淆了find/select与find_all/select的返回值类型。通过对比Tag与ResultSet/List的区别,并提供索引取值和改用select_one两种解决方案,帮助开发者快速定位并修复代码。
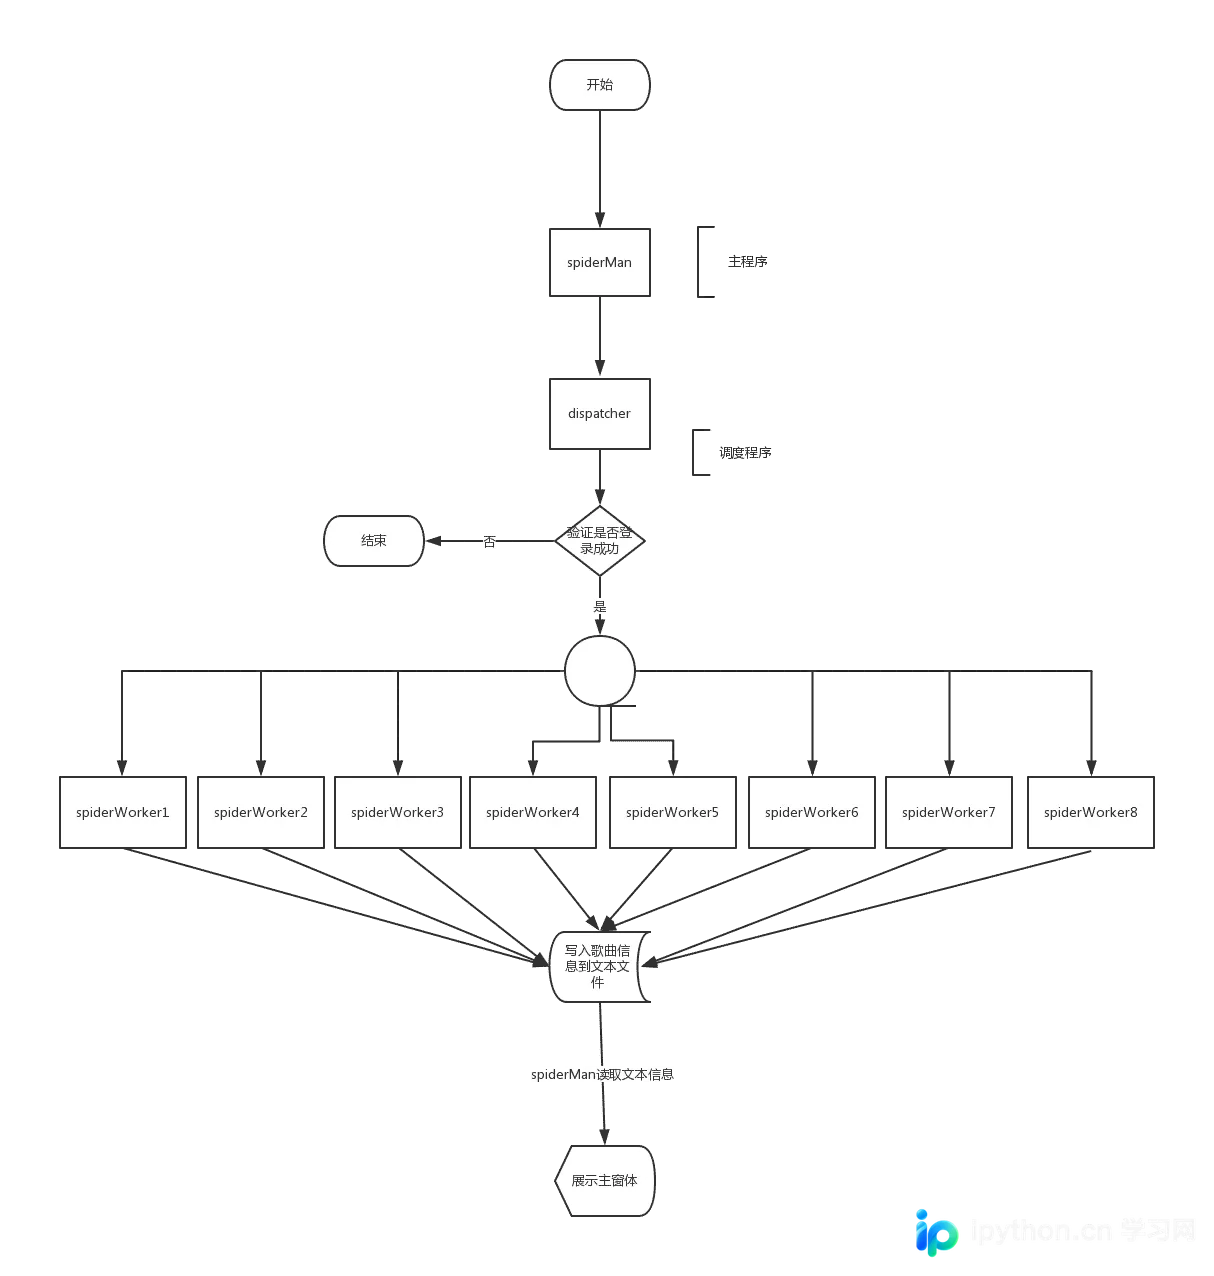
本文介绍了一款基于Python和PyQt的百度音乐下载器的改进版。通过引入主线程加8个子线程的多线程架构,将百首歌曲扫描时间从40秒缩短至9秒左右,并解决了UI阻塞问题。同时,详细解析了os.path.dirname与os.getcwd在脚本执行路径获取上的差异及正确用法,提供了完整的配置与运行指南。
本文详细解析如何使用Python的requests库进行视频文件的流式下载,解决内存占用问题。通过引入contextlib.closing处理上下文管理器缺失,并优化文件写入策略以实时保存数据。最后结合多线程与队列机制,实现高效的多线程并发下载,包含断点判断与进度显示功能。