

PHP基于DOMDocument构建简单爬虫:提取指定标题文章链接

在数据采集场景中,有时需要快速从指定网站提取包含特定关键词的文章URL。本文介绍如何使用PHP后端结合DOMDocument与JavaScript前端,构建一个能抓取并展示特定文章链接的简易爬虫工具。
明确爬虫目标与界面设计
开发爬虫前需明确核心需求:针对多个网站,查找包含特定关键字的文章,并返回其链接以便快速阅读。为此,界面应包含三个核心要素:
- URL输入框:用于填写目标网站地址。
- 标题输入框:用于输入搜索的关键字或标题。
- 结果显示区:用于展示匹配到的文章链接。
以下是基础界面的HTML结构示例,使用Bootstrap风格面板进行布局:
<div class="jumbotron" id="mainJumbotron">
 <div class="panel panel-default">
  <div class="panel-heading">文章URL抓取</div>
  <div class="panel-body">
   <div class="form-group">
    <label for="article_title">文章标题</label>
    <input type="text" class="form-control" id="article_title" placeholder="文章标题">
   </div>
   <div class="form-group">
    <label for="website_url">网站URL</label>
    <input type="text" class="form-control" id="website_url" placeholder="网站URL">
   </div>
   <button type="submit" class="btn btn-default">抓取</button>
  </div>
 </div>
 <div class="panel panel-default">
  <div class="panel-heading">文章URL</div>
  <div class="panel-body">
   <h3></h3>
  </div>
 </div>
</div>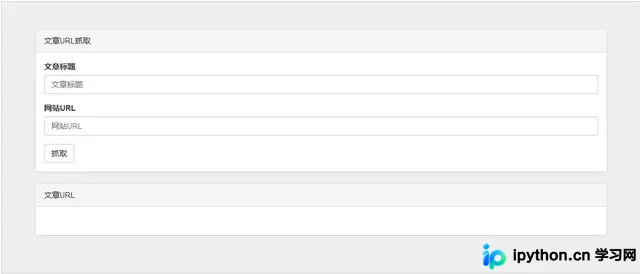
后端逻辑实现步骤
第1步:使用CURL获取网页源码
目的:通过网络请求获取目标网站的原始HTML内容。
入口:定义PHP函数接收$url参数。
动作:初始化cURL会话,设置超时、用户代理(User-Agent)以避免被识别为机器人,并启用gzip解码。
private function get_html($url){
 $ch = curl_init();
 $timeout = 10;

 curl_setopt($ch, CURLOPT_URL, $url);
 curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);
 curl_setopt($ch, CURLOPT_ENCODING, 'gzip');
 // 模拟浏览器UA
 curl_setopt($ch, CURLOPT_USERAGENT, 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/34.0.1847.131 Safari/537.36');
 curl_setopt($ch, CURLOPT_CONNECTTIMEOUT, $timeout);

 $html = curl_exec($ch);
 return $html;
}
第2步:统一处理字符编码
目的:防止因网站编码(如GBK)与PHP处理编码不一致导致后续解析出错。
入口:获取到$html字符串。
动作:检测当前编码,若非UTF-8则强制转换为UTF-8。
$coding = mb_detect_encoding($html);
if ($coding != "UTF-8" || !mb_check_encoding($html, "UTF-8")) {
 $html = mb_convert_encoding($html, 'utf-8', 'GBK,UTF-8,ASCII');
}
第3步:解析HTML并提取链接(推荐DOMDocument)
目的:从HTML中提取所有超链接及其文本,这是爬虫的核心。虽然可以使用正则表达式,但考虑到现代网页结构复杂,直接使用DOM操作更为稳健。
入口:已转换编码的$html。
动作:使用PHP内置的DOMDocument加载HTML,通过XPath查询所有标签,并遍历获取href属性和文本内容。
$dom = new DOMDocument();
@$dom->loadHTML($html); // @抑制警告,因为loadHTML对非标准HTML可能报错

$xpath = new DOMXPath($dom);
$nodes = $xpath->query('//a');

$results = [];
for ($i = 0; $i < $nodes->length; $i++) {
 $node = $nodes->item($i);
 $href = $node->getAttribute('href');
 $title = trim($node->nodeValue);
 // 可根据$title进行过滤,例如判断是否包含特定关键字
 if (!empty($href) && !empty($title)) {
     $results[] = ['url' => $href, 'title' => $title];
 }
}注:原文中提到的正则表达式|<a[^>]*>(.*)</a>|isU在某些嵌套或格式混乱的HTML中可能失效,建议使用上述DOM方式。
前端数据展示
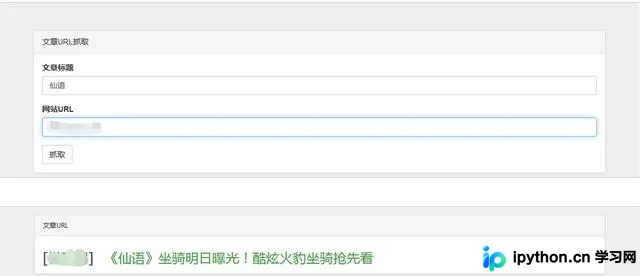
后端处理后,将提取到的数据以JSON格式返回。前端使用JavaScript(jQuery)发起请求,并将结果动态插入页面容器。
var website_url = '/your/api/endpoint';
$.getJSON(website_url, function(data){
 if(data && data.text) {
  var string = '';
  var list = data.text;
  for (var j in list) {
   var content = list[j].url_content;
   for (var i in content) {
    if (content[i].title != '') {
     string += '<div class="item">'
      + '<em>[' + list[j].website.web_name + ']</em>'
      + '<a href="' + content[i].url + '" target="_blank" class="web_url">'
      + content[i].title + '</a>'
      + '</div>';
    }
   }
  }
  $('#article_url').html(string);
 } else {
  $('#article_url').html('<p>暂无该文章链接</p>');
 }
});
总结与注意事项
通过以上步骤,我们实现了一个基础的“抓去特定文章链接”的工具。在实际应用中,还需注意以下几点:
- 合规性:爬取数据请遵守robots.txt协议及相关法律法规,避免高频请求干扰对方服务器。
- 错误处理:DOMDocument对残缺HTML容错较好,但仍需处理loadHTML可能产生的PHP警告。
- 相对路径:提取的href可能是相对路径,如需绝对链接,需结合base_url进行拼接。
以上就是PHP+HTML+JavaScript+Css实现简单爬虫开发的详细内容,更多关于PHP开发技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









