

Python使用Requests库正则表达式爬取段子网站数据详解

本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
网站数据结构分析与URL规律
首先,利用谷歌浏览器开发者工具进行抓包分析,以获取该网站的数据结构,分析结果如下所示:
目标网站的地址为:http://www.budejie.com/text
该网站的数据均通过HTML页面展示。默认URL对应第一页,而第二页的URL格式为http://www.budejie.com/text/2,后续页面依此类推。
对页面内容进行深入分析后发现,段子文本内容均包裹在<a>标签中。
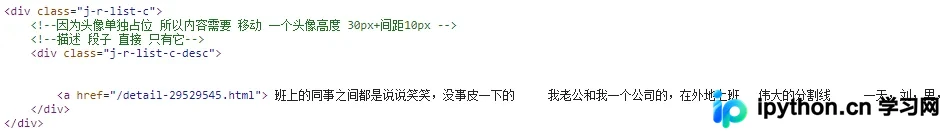
正则表达式的调试与优化
在编写正则表达式时遇到了一些问题,这是我最初编写的正则表达式:
content_list = re.findall(r'<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str)
随后发现该正则匹配到了部分推荐内容,导致结果不准确。最终调整正则表达式如下,经测试已无问题。关于正则表达式的具体语法此处不再赘述。
content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str)
当前目标是爬取前20页的段子数据并保存至本地。既然已经掌握了翻页规律和用于匹配内容的正则表达式,接下来即可编写具体代码。
具体代码如下,整体思路与之前的爬虫博客保持一致,采用面向对象的设计模式:
Python爬虫代码实现
import requests
import re
import json

class NeihanSpider(object):
  """内涵段子,百思不得其姐,正则爬取一页的数据"""
  def __init__(self):
    self.temp_url = 'http://www.budejie.com/text/{}' # 网站地址,给页码留个可替换的{}
    self.headers = {
      'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36',
    }

  def pass_url(self, url): # 发送请求,获取响应
    print(url)
    response = requests.get(url, headers=self.headers)
    return response.content.decode()

  def get_first_page_content_list(self, html_str): # 提取第一页的数据
    content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str) # 非贪婪匹配
    return content_list

  def save_content_list(self, content_list):
    with open('neihan.txt', 'a', encoding='utf-8') as f:
      for content in content_list:
        f.write(json.dumps(content, ensure_ascii=False))
        f.write('\n') # 换行
      print('成功保存一页!')

  def run(self): # 实现主要逻辑
    for i in range(20): # 只爬取前20页数据
      # 1. 构造url
      # 2. 发送请求,获取响应
      html_str = self.pass_url(self.temp_url.format(i+1))
      # 3. 提取数据
      content_list = self.get_first_page_content_list(html_str)
      # 4. 保存
      self.save_content_list(content_list)

if __name__ == '__main__':
  neihan = NeihanSpider()
  neihan.run()
以上即为本文的全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









