

Python爬取百度权重:从Excel读取到MySQL存储的完整实现

本文详细解析如何使用Python3批量查询网站百度权重。通过openpyxl读取Excel中的网址列表,利用Requests伪造请求获取seo.chinaz.com页面,并用BeautifulSoup提取权重数据。最终将结果写入MySQL数据库及Excel文件,提供完整的代码逻辑与配置说明。
脚本需求与数据结构设计
脚本需求分析
本方案旨在利用Python3自动查询指定网站的百度权重,并将结果持久化存储至本地MySQL数据库中。同时,程序需生成一份包含查询结果的Excel报表,以便直观查看数据。
数据存储采用MySQL数据库类型。
数据库中对应的数据表命名为website_weight。
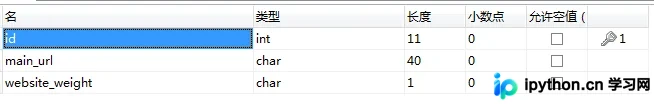
数据表结构设计如下:包含id主键、main_url字段用于存储待查询的网站域名,以及website_weight字段用于存储获取到的权重值。
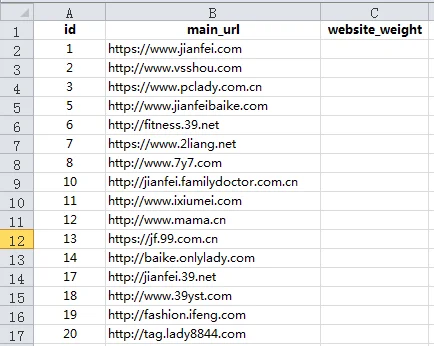
待查询的网站列表预先整理在Excel表格文件中。
核心功能实现逻辑
需求实现步骤
第一步,使用openpyxl模块解析Excel文件,遍历工作表并将所有需要查询的网址提取出来,保存为一个列表供后续处理。
# 解析excel文件,取出所有的url
def get_urls(file_path):
 wb = load_workbook(file_path)
 sheet = wb.active
 urls = []
 for cell in list(sheet.columns)[1]:
 if cell != sheet['B1']:
  urls.append(cell.value)
 return wb, urls
第二步,分析目标网站的请求机制,构造带有随机User-Agent和Referer的HTTP请求头以模拟浏览器访问,从而获取目标HTML页面源码。
# 伪造请求,取得html页面
def get_html(url):
 # 定义http的请求Header
 headers = {}
 # random.randint(1,99) 为了生成1到99之间的随机数,让UserAgent变的不同。
 headers[
 'User-Agent'] = "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537." + str(
 random.randint(1, 99))
 # Referer地址使用待查询的网址
 headers['Referer'] = "http://seo.chinaz.com/" + url + "/"
 html = ''
 try:
 html = requests.get("http://seo.chinaz.com/" + url + "/", headers=headers, timeout=5).text
 except Exception:
 pass
 return html
第三步,对获取的HTML页面进行解析,借助BeautifulSoup模块定位特定标签,提取出代表网站权重的关键数据。
# 利用BeautifulSoup模块从html页面中提取数据
def get_data(html, url):
 if not html:
 return url, 0
 soup = bs(html, "lxml")
 p_tag = soup.select("p.ReLImgCenter")[0]
 src = p_tag.img.attrs["src"]
 regexp = re.compile(r'^http:.*?(\d).gif')
 br = regexp.findall(src)[0]
 return url, br
第四步,配置MySQL数据库连接参数,建立连接并获取数据库游标,为数据写入做准备。
# 连接数据库
def get_connect():
 conn = pymysql.connect(
 host='127.0.0.1',
 port=3306,
 user='root',
 passwd='root',
 db='seotest',
 charset="utf8")
 # 获取游标对象
 cursor = conn.cursor()
 return conn, cursor
第五步,编写主程序逻辑,串联上述步骤,实现从读取、查询、解析到存储的全流程自动化。
if __name__ == "__main__":
 #命令行执行脚本文件,获取excel文件路径
 file_path = sys.argv[1]
 #获取URL列表和excle工作簿
 wb, urls = get_urls(file_path)
 #获取数据库连接和游标
 conn, cursor = get_connect()
 #获取工作簿当前工作sheet
 sheet = wb.active
 #数据库插入语句
 sql_insert = '''insert into website_weight(main_url, website_weight) values (%s, %s)'''

 for row, url in enumerate(urls):
 if not url: continue
 html = get_html(url)
 data = get_data(html, url)
 # 插入数据到数据库
 cursor.execute(sql_insert, data)
 # 插入数据到Excel表中
 cell = sheet.cell(row=row + 2, column=3)
 cell.value = data[1]
 # 终端打印插入的数据
 print(data)
 conn.commit()
 conn.close()
 wb.save(file_path)
 wb.close()

# cmd命令:python3 F:\算法与结构\网站权重.py F:\website.xlsx
运行环境与结果验证
脚本运行及结果验证
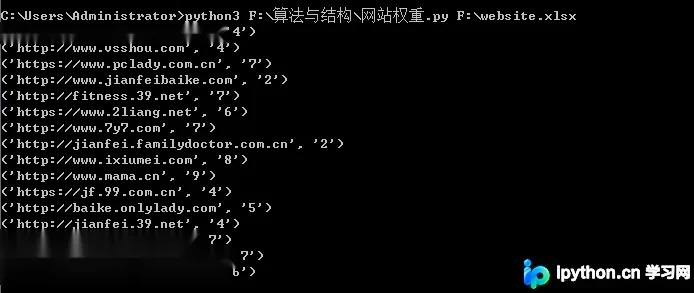
通过CMD命令行执行脚本文件,传入Excel文件路径作为参数。
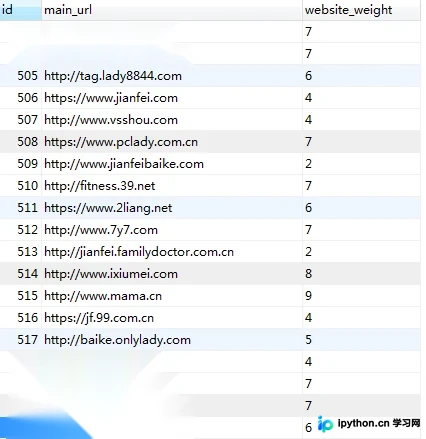
检查MySQL数据库,确认数据已成功插入website_weight表中。
查看生成的Excel文件,确认权重数据已正确写入对应单元格。
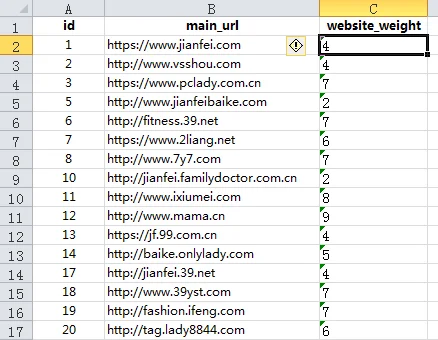
以上即为利用Python实现百度权重批量查询与存储的完整过程,希望能为相关技术学习提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









