Python爬虫处理验证码同步问题的三种方案及Selenium Cookie操作详解
本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
2026-10-13
8

本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
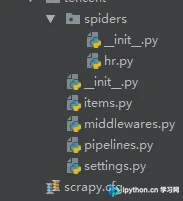
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
本文介绍如何使用Python库wxpy对接微信接口,实现自动化管理微信公众号及获取个人微信数据。通过调用itchat底层指令,可批量导出好友信息、自动归档聊天记录(含音视频图片)并建立本地数据库。文章提供了基于wxpy.register()实现自动回复、消息转发及特定对象互动的具体代码示例,适用于个人数据备份与基础公众号运营场景。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

本文详解如何使用Python编写有道在线翻译小程序。针对有道反爬机制,重点讲解User-Agent伪装、Referer设置及data参数构造(含salt与sign生成)。提供完整Python代码,涵盖urllib、json、time及hashlib模块的应用,并分析运行结果,帮助开发者解决旧版教程失效问题。
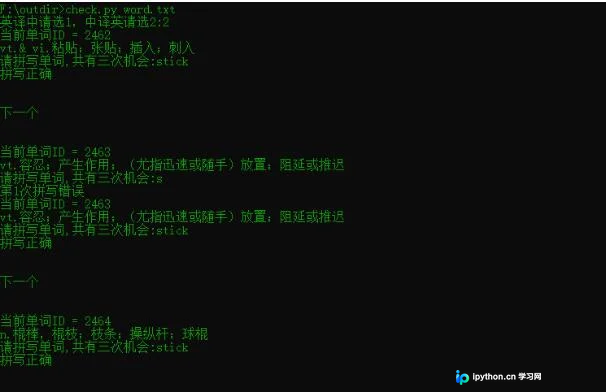
本文介绍使用Python构建个人单词词库的方法。通过爬取COCA两万单词表,利用requests和BeautifulSoup获取金山词霸的词性、释义及音频链接,并存储至SQLite数据库。程序支持自定义测试模式,包括中译英拼写与英译中选择释义,旨在提供灵活的背单词解决方案。
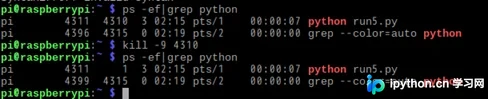
本文介绍如何利用Shell脚本监控Python程序,当程序意外中断时实现自动重启。通过while循环持续执行Python脚本,并结合nohup命令实现后台运行。此外,针对爬虫场景,提供了基于文件管理的断点续爬代码示例,确保中断后能从上次位置继续抓取数据。
本文介绍如何在Python爬虫项目中实现中断重连与断点续爬功能,以应对网站验证或IP封禁导致的程序中断。通过维护新URL与已爬取URL集合,并将数据持久化至文件,避免内存溢出。文中提供了基于文件操作的URL管理器类及获取最后一行数据的详细代码实现,帮助开发者快速集成该功能。
本文介绍如何在Python中使用requests库指定出口IP,适用于爬虫多IP轮询场景。通过安装requests_toolbelt模块,利用SourceAddressAdapter类绑定特定IP地址到Session对象,实现HTTP和HTTPS请求的出口IP控制。
本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
本文详细讲解在Python环境中安装Selenium库的完整步骤。内容涵盖通过pip命令安装selenium包、验证安装是否成功,以及关键的环境配置环节:下载与浏览器版本匹配的ChromeDriver,并将其路径加入系统环境变量。最后通过简单的Python代码测试浏览器调用,确保环境配置无误,适用于Python初学者进行Web自动化测试或爬虫开发前的环境准备。