

Python爬取智联招聘数据分析师岗位信息实战

发布时间:2026-10-13| 6人浏览过
本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
分析智联招聘网络请求接口
首先访问智联招聘官方网站,在搜索栏中输入关键词“数据分析师”并执行搜索。页面加载完成后,按下F12键打开浏览器开发者工具,随后切换到Network(网络)标签页。
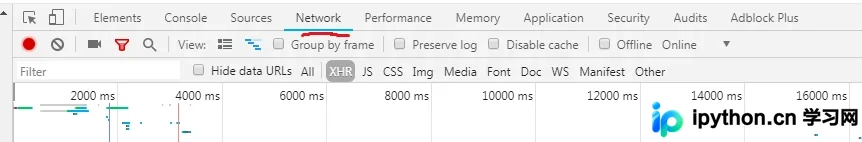
在Network面板中,筛选并选中XHR(XMLHttpRequest)选项,然后刷新当前网页以重新加载数据。
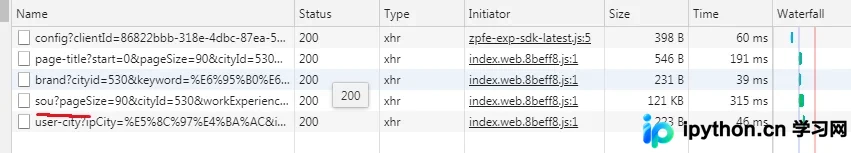
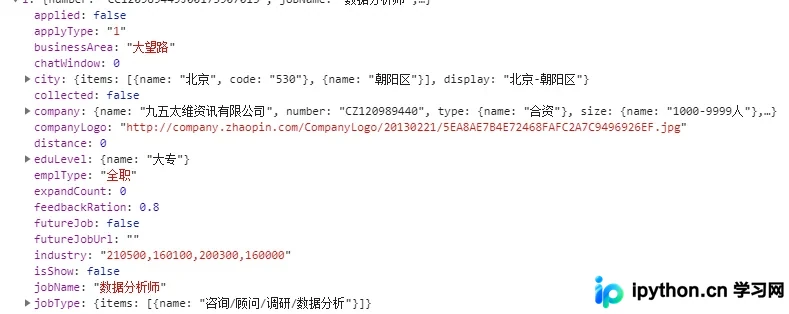
此时可以观察到一系列Ajax异步请求,找到被标记为关键请求的XHR文件(通常对应职位列表接口)。点击该文件,即可在右侧预览窗口中看到网页返回的具体数据内容。
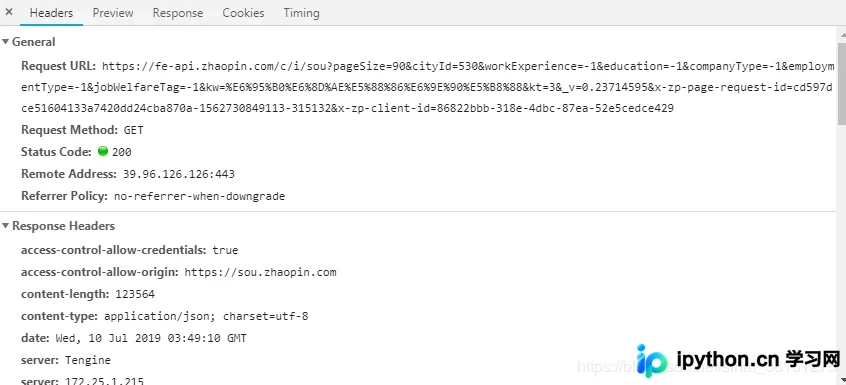
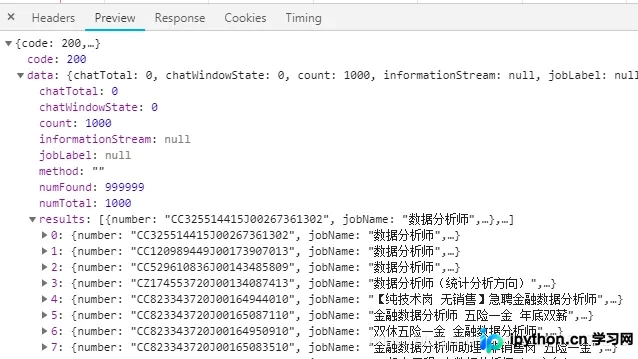
查看该请求的Header(标头)部分,定位其中的Request URL(请求地址)。我们需要分析该URL的结构特征,以便在代码中准确构造相同的请求网址。
切换到Preview(预览)标签页,可以发现所需的数据主要存储在result字段中。这些数据通常以JSON格式呈现,部分结构为列表形式,便于后续解析。
Python爬虫代码实现
接下来,我们将使用Python编写爬虫程序,自动抓取上述接口返回的数据。
具体的Python实现代码如下:
import requests
from urllib.parse import urlencode
import json
#from requests import codes
#import os
#from hashlib import md5
#from multiprocessing.pool import Pool
#import re


def get_page(offset):
  params = {
    'start': offset,
    'pageSize': '90',
    'cityId': '530',
    'salary': '0,0',
    'workExperience': '-1',
    'education': '-1',
    'companyType': '-1',
    'employmentType': '-1',
    'jobWelfareTag': '-1',
    'kw': '数据分析师',
    'kt': '3',
    '_v': '0.77091902',
    'x-zp-page-request-id': '8ff0aa73bf834b408f46324e44d89b84-1562722989022-210101',
    'x-zp-client-id': '2dc4c9a4-e80d-4488-84a3-03426dd69a1e'


  }
  base_url = 'https://fe-api.zhaopin.com/c/i/sou?'
  url = base_url + urlencode(params)
  try:
    resp = requests.get(url)
    print(url)
    if 200 == resp.status_code:
      print(resp.json())
      return resp.json()
  except requests.ConnectionError:
    return None


def get_information(json_page):
  if json_page.get('data'):
    results = json_page.get('data').get('results')
    for result in results:
       yield {
         'city': result.get('city').get('display'),
          'company': result.get('company').get('name'),
          #'welfare':result.get('welfare'),
          'workingExp':result.get('workingExp').get('name'),
          'salary':result.get('salary'),
          'eduLevel':result.get('eduLevel').get('name')
        }
print('succ')

def write_to_file(content):
   with open('result.txt','a',encoding='utf-8') as f:
      print(type(json.dumps(content)))
      f.write(json.dumps(content,ensure_ascii=False)+'\n')


def main(offset):
  json_page=get_page(offset)
  for content in get_information(json_page):
    write_to_file(content)

if __name__=='__main__':
   for i in range(10):
      main(offset=90*i)
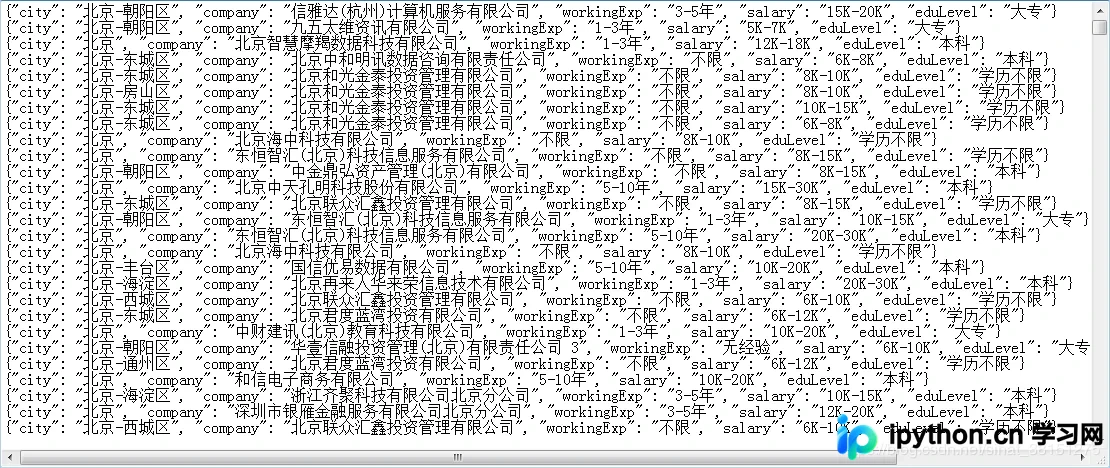
运行程序后,获取的爬取结果如下所示:
至此,本文介绍了使用Python爬取智联招聘数据分析师岗位信息的全过程,希望能为读者的学习和工作提供帮助。欢迎继续支持本站获取更多技术内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









