Python3 爬取酷狗TOP500音乐信息并存储至MongoDB
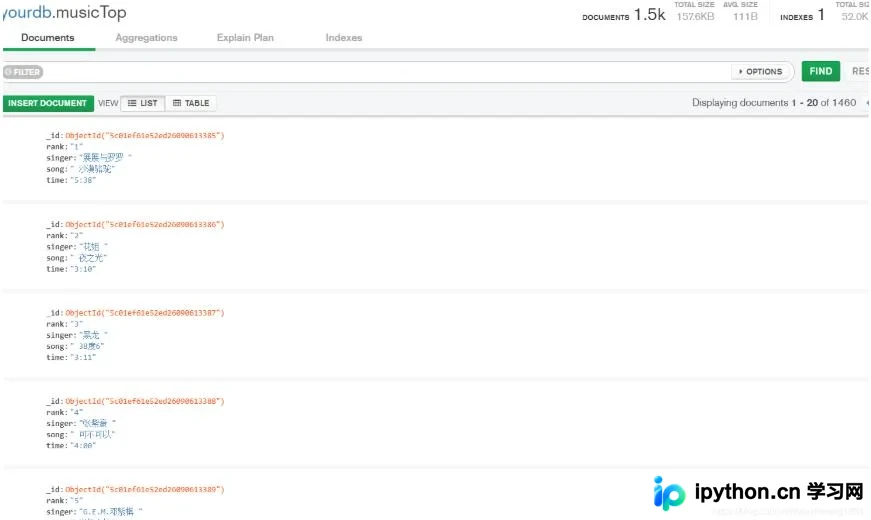
本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
2026-10-13
9

本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
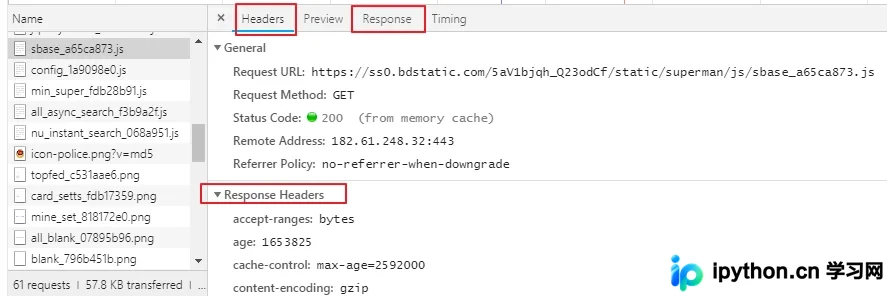
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
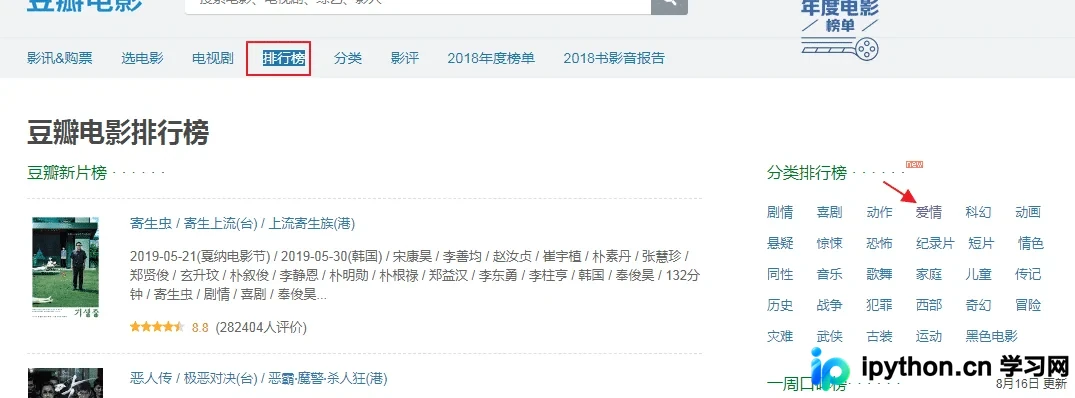
本文详解如何使用Python的Requests模块发起Ajax GET请求以爬取豆瓣电影分类排行榜数据。通过抓包工具定位异步加载的接口,解析返回的JSON字符串,并调整start和limit参数获取不同范围的电影详情,实现高效的数据抓取。
本文详解如何使用Python监控各类数字资产钱包余额。针对提供API的区块浏览器(如btc.com、etherscan.io),介绍直接调用接口及单位换算方法;针对无API的浏览器(如chainx.org),演示通过开发者工具抓取XHR请求进行数据解析。结合钉钉机器人实现余额变动实时提醒,涵盖BTC、ETH及ERC20代币的完整监控方案。
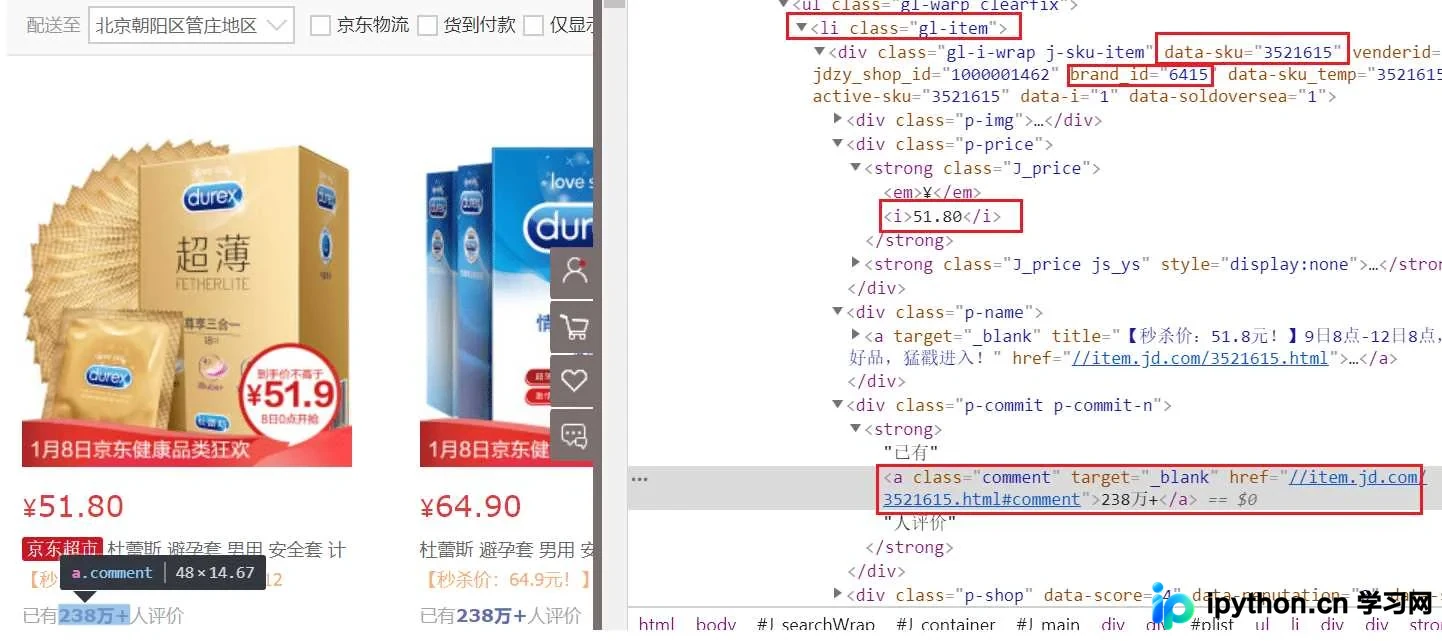
本文详解如何利用Selenium技术抓取京东平台成人用品的产品信息与评论数据,并存入MongoDB数据库。通过对8934款产品及17万条评论的分析,揭示了销量领先的品牌分布、热门产品特征及购物节对销量的显著影响,为电商数据分析提供实战参考。
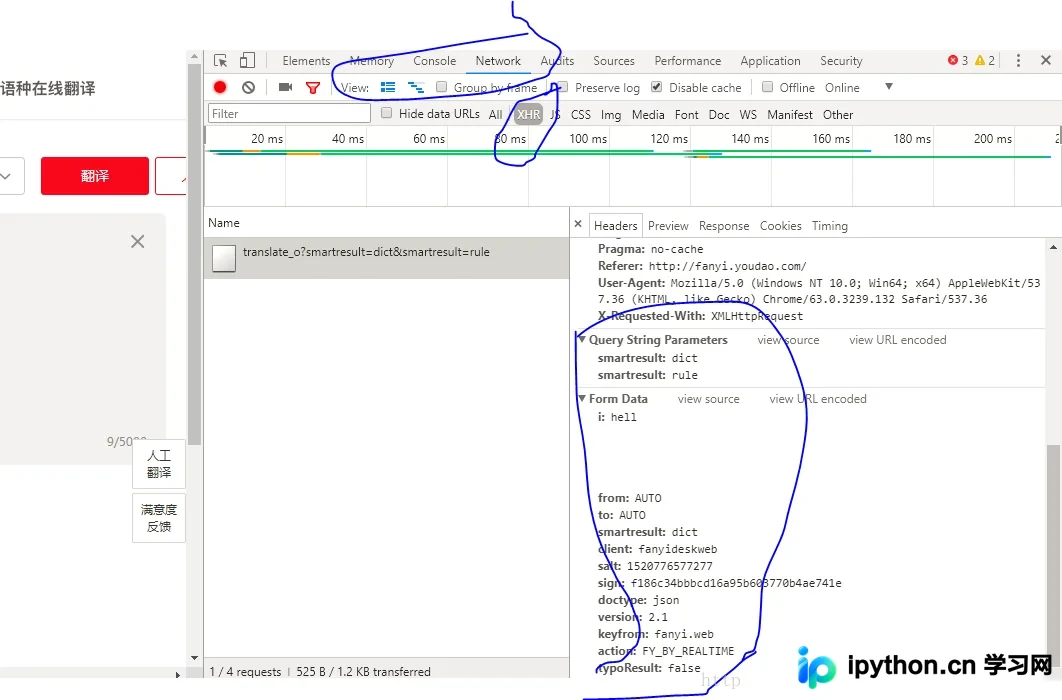
本文详细解析如何使用Python3的urllib库破解有道翻译接口的反爬虫机制。通过抓包分析定位加密参数,逆向JS源码获取sign生成算法(含salt、sign、client等变量),并模拟浏览器请求头(User-Agent、Referer、Cookie),最终实现成功调用接口获取翻译结果。
本文详解如何使用Python Scrapy框架爬取豆瓣电影Top250数据,并通过自定义Pipeline将结果持久化至MongoDB数据库。内容涵盖items定义、Spider编写、Pipeline配置及Settings设置,提供完整代码示例与测试步骤,帮助开发者掌握Web爬虫与数据库存储的结合应用。
本文介绍使用Python2编写脚本抓取百度贴吧指定关键字及楼主图片的完整流程。通过构造分页URL、解析帖子链接并提取图片地址,实现本地保存。重点解决因服务器返回数据差异导致的XPath匹配失败问题,建议采用IE浏览器User-Agent以提高兼容性。
本文介绍如何使用Python2结合Bs4库解析腾讯社招页面,提取职位名称、类别、人数、地点及发布时间等关键信息。重点解决Python列表直接写入Json文件时中文乱码问题,通过序列化及UTF-8编码确保数据正确存储,最终将结果保存为Json格式文件供后续使用。
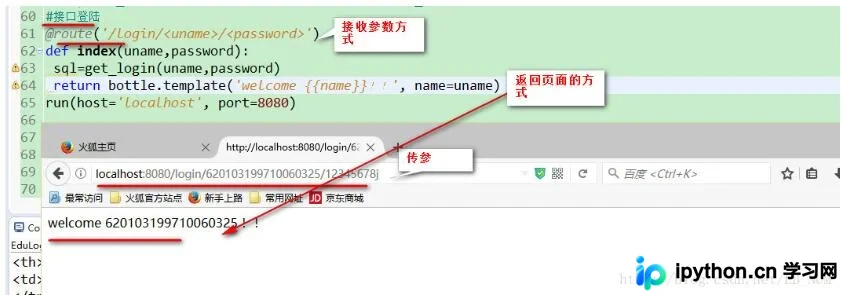
本文介绍如何利用 Python 自带的 unittest 和轻量级 Bottle 框架搭建一个简单的 Web 接口,供第三方或浏览器调用。内容涵盖环境准备、Bottle 服务代码编写及运行方法,并通过一个登录接口的具体示例展示了 URL 参数传递与模板渲染的实现过程。