Python爬虫实战:异常处理与BeautifulSoup标签过滤详解

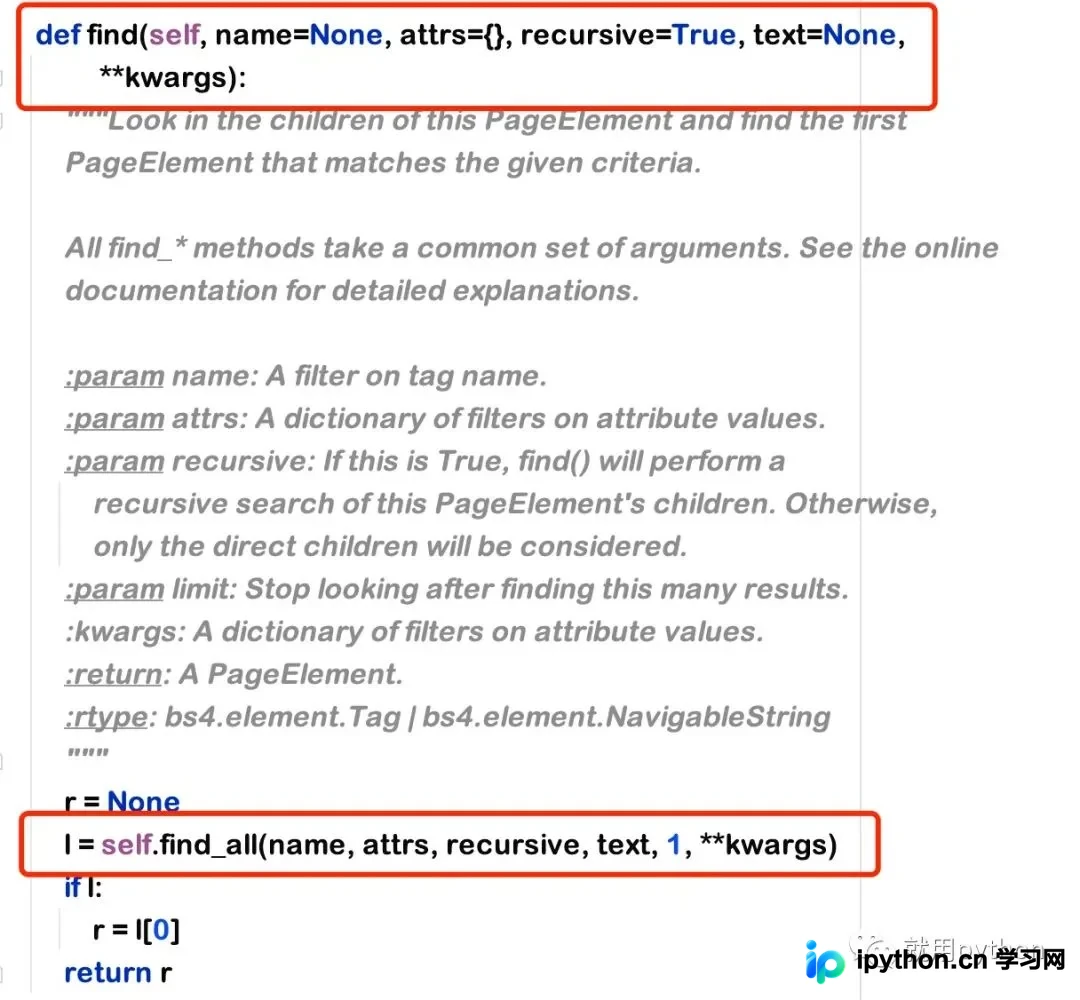
本文详细解析Python爬虫开发中的关键技巧,涵盖网络请求阶段的HTTPError与URLError异常处理,以及BeautifulSoup解析HTML时的NoneType错误防御。深入讲解find与find_all方法的区别、参数配置(如limit、recursive)及属性过滤技巧,通过豆瓣电影数据抓取实例,展示如何高效获取特定标签文本并处理常见编码问题,帮助开发者提升爬虫稳定性与数据提取精度。

Python爬虫实战:异常处理与BeautifulSoup标签过滤详解

Python执行JS代码的方法

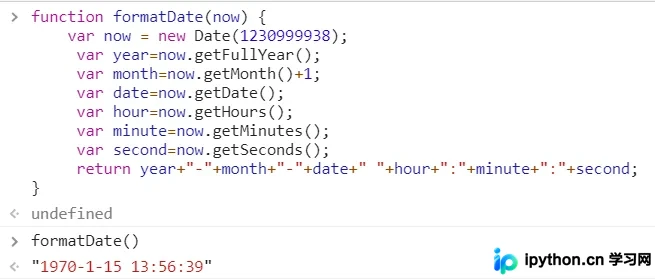
本文介绍如何在Python中执行JavaScript代码,重点解决爬虫场景中JS混淆导致逻辑难以解析的问题。通过安装node环境和PyExecJS库,演示了正常及混淆JS代码的执行过程,并探讨了window对象处理及Selenium替代方案。

Python执行JS代码的方法

Python异步爬虫实现原理与知识总结

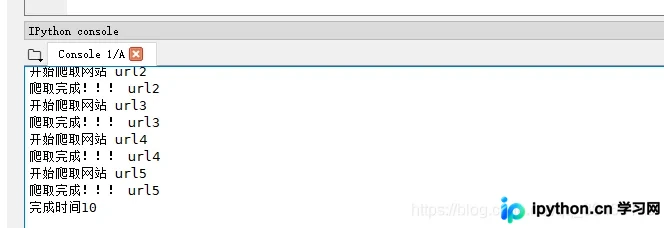
本文深入解析Python异步爬虫的实现原理,对比串行、多线程、多进程及协程四种模式的性能差异。重点讲解如何利用asyncio构建单线程异步爬虫,并引入aiohttp模块处理真实网络请求,解决同步阻塞问题,提供高效爬虫方案。

Python异步爬虫实现原理与知识总结

Python实现TapTap游戏截图自动抓取教程

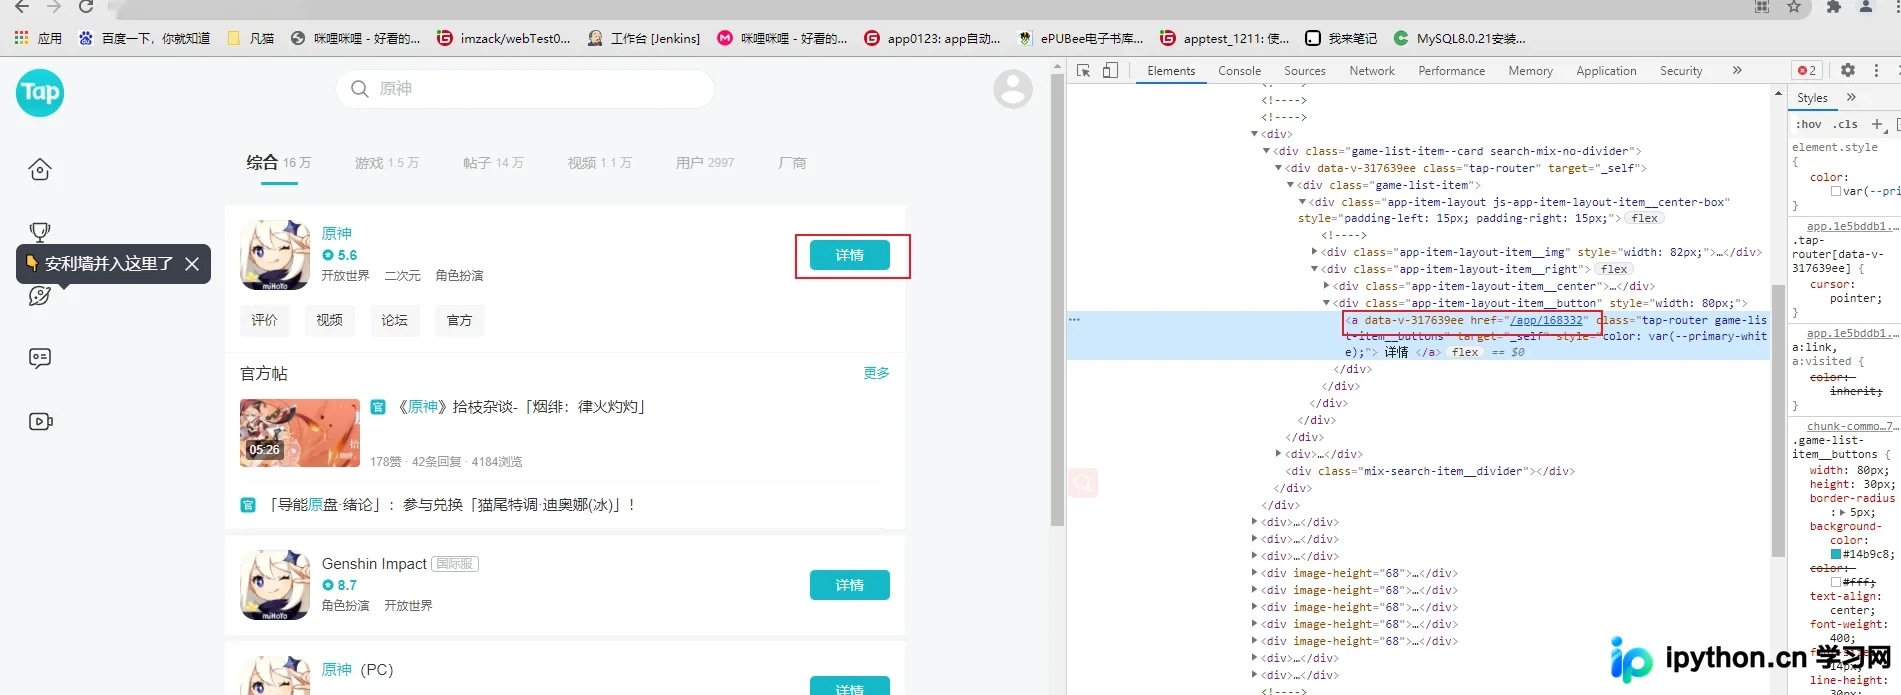
本文详细介绍如何利用Python编写爬虫程序,自动抓取TapTap平台上的游戏高清截图。通过解析搜索接口获取游戏ID,再调用详情API提取图片链接,最终实现批量下载保存。文中包含完整的代码示例及关键步骤解析,适合对网络爬虫感兴趣的开发者参考。

Python实现TapTap游戏截图自动抓取教程

Python爬虫必备:chardet库自动编码检测实战

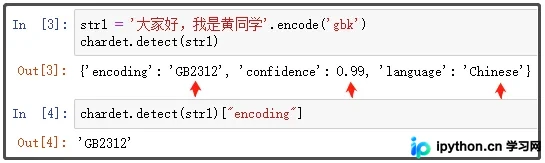
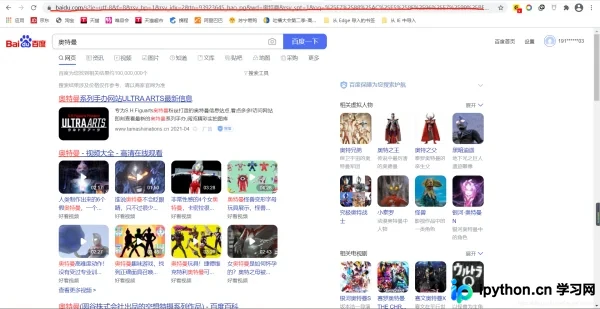
本文详细介绍Python中chardet库的安装方法及核心用法。针对爬虫中常见的网页编码不一致导致的乱码问题,讲解如何利用chardet.detect()函数自动检测字符串或网页源码的编码格式(如GBK、UTF-8等)。通过百度网页抓取实例,演示如何结合requests库动态设置编码,从而高效解决乱码难题,提升数据抓取成功率。

Python爬虫必备:chardet库自动编码检测实战

Python爬虫实战:破解百度翻译AJAX接口抓取方法

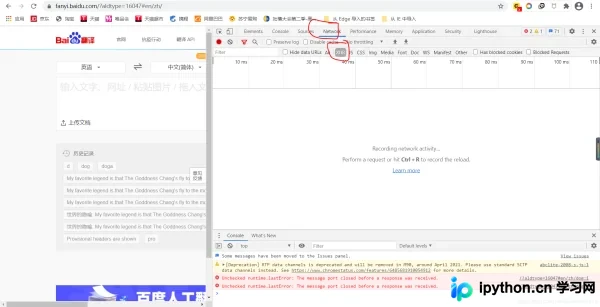
本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。

Python爬虫实战:破解百度翻译AJAX接口抓取方法

Python爬虫基础:解决反爬机制的UA伪装技巧

本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。

Python爬虫基础:解决反爬机制的UA伪装技巧

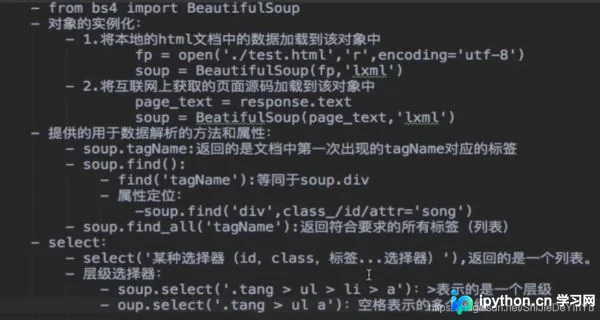
Python爬虫实战:使用Bs4与Lxml进行数据解析

本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。

Python爬虫实战:使用Bs4与Lxml进行数据解析

Django利用Cookie实现反爬虫的完整指南

本文详解Django中Cookie机制及其在反爬虫中的应用。通过解析request对象获取Cookie,利用set_cookie方法配置max_age、expires及path等关键参数,有效限制爬虫抓取频率并隐藏生成逻辑。结合代码示例,帮助开发者构建更安全的Web应用。