

Python爬虫必备:chardet库自动编码检测实战

本文详细介绍Python中chardet库的安装方法及核心用法。针对爬虫中常见的网页编码不一致导致的乱码问题,讲解如何利用chardet.detect()函数自动检测字符串或网页源码的编码格式(如GBK、UTF-8等)。通过百度网页抓取实例,演示如何结合requests库动态设置编码,从而高效解决乱码难题,提升数据抓取成功率。
一、chardet库的安装与介绍
在进行网络爬虫开发时,开发者常遇到返回数据出现乱码的现象。不同网页采用的编码格式各异,例如部分中文页面使用GBK或GB2312,而另一些则采用UTF-8。在抓取此类页面时,准确识别网页编码是确保数据正常显示的关键环节。
尽管HTML源码中通常包含charset标签,但该标签内容有时并不准确。此时,chardet库便发挥重要作用,它能够便捷地实现对字符串或文件编码的检测,帮助开发者快速定位正确的编码方式。
若已安装Anaconda环境,chardet库通常已内置,可直接调用。若仅安装了基础Python环境,则需通过命令行执行以下代码完成库的安装。
pip install chardet安装完成后,通过以下代码导入chardet库即可开始使用。
import chardet二、chardet库的使用
本节将分三个部分详细讲解chardet库的具体应用。
2.1 chardet.detect()函数
detect()函数接收一个非Unicode字符串作为参数,返回一个包含自动检测到的字符编码、可信度(0至1之间)及语言信息的字典。
- encoding:表示检测出的字符编码方式。
- confidence:表示检测结果的可信度评分。
- language:表示检测出的语言类型。
仅看上述说明可能较为抽象,下文将通过具体代码示例进行演示。
2.2 使用该函数分别检测gbk、utf-8和日语
首先,我们尝试检测使用GBK编码的中文内容。
str1 = '大家好,我是黄同学'.encode('gbk')
chardet.detect(str1)

chardet.detect(str1)["encoding"]
运行结果如下:
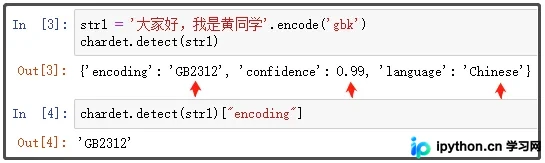
结果显示编码为GB2312。需注意,GBK是GB2312的超集,两者在编码处理上视为一致。检测可信度高达99%,且language字段标识为'Chinese',表明检测准确。
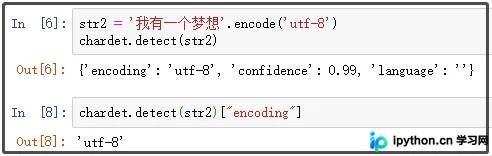
接下来,检测使用UTF-8编码的中文内容。
str2 = '我有一个梦想'.encode('utf-8')
chardet.detect(str2)

chardet.detect(str2)["encoding"]
运行结果如下:
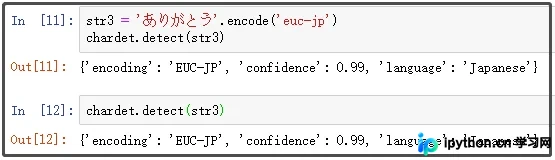
随后,我们尝试检测一段日文内容。
str3 = 'ありがとう'.encode('euc-jp')
chardet.detect(str3)

chardet.detect(str3)
运行结果如下:
2.3 如何在“爬虫”中使用chardet库呢?
以抓取百度网页为例进行说明。
我们需要确认该网页源代码使用的编码格式,查看源码可知:
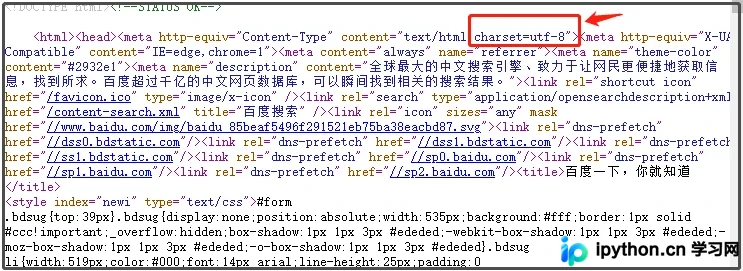
从源码中可见,该网页使用的是utf-8字符编码。
若不借助chardet库,在获取网页源码时通常需手动指定编码格式。
import chardet
import requests

headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
response = requests.get('https://www.baidu.com',headers=headers)
response.encoding = "utf-8"
response.text
运行结果如下:
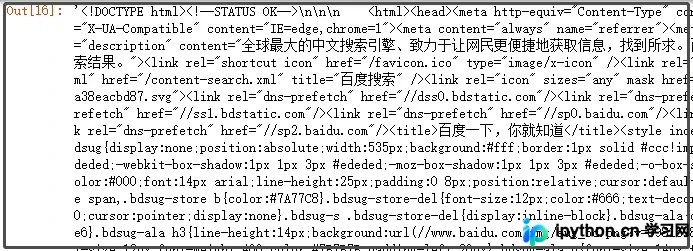
可以观察到,当正确指定编码后,页面内容无乱码。若将编码强制改为gbk,则会出现乱码现象。
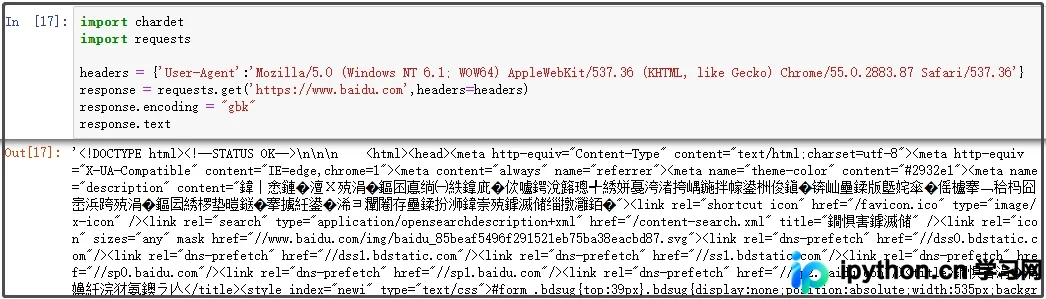
引入chardet库后,获取网页源码时可自动指定编码,操作更为简便。
import chardet
import requests

headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
response = requests.get('https://www.baidu.com',headers=headers)

# 注意下面这行代码,是怎么写的?
response.encoding = chardet.detect(response.content)['encoding']
response.text
运行结果如下:
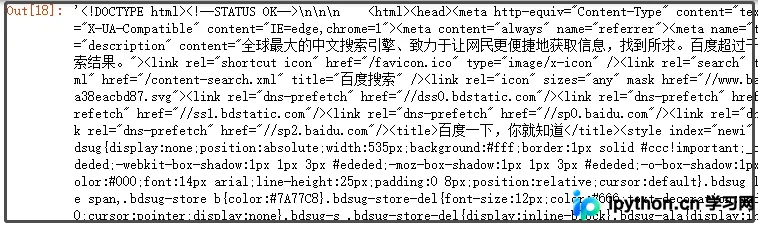
无需手动查找或猜测编码,直接交由chardet库判断,不仅简化流程,且准确率较高。
至此,关于Python爬虫中chardet库的应用介绍完毕。如需了解更多Python及chardet库相关内容,可查阅本站过往文章或继续浏览后续教程,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









