

Python异步爬虫实现原理与知识总结

发布时间:2026-10-14| 5人浏览过
本文深入解析Python异步爬虫的实现原理,对比串行、多线程、多进程及协程四种模式的性能差异。重点讲解如何利用asyncio构建单线程异步爬虫,并引入aiohttp模块处理真实网络请求,解决同步阻塞问题,提供高效爬虫方案。
一、背景
默认情况下,使用get请求时会出现阻塞现象,需要耗费大量时间等待响应。当面对大量URL请求时,串行执行会导致速度极慢,因为必须等待当前URL请求完全结束后,才能发起下一个请求。为提升爬虫效率,一种自然的思路是引入异步机制。通过构建线程池或进程池实现异步爬虫,即利用多线程或多进程并行处理多个请求,从而在某个线程或进程阻塞时,其他线程或进程仍可继续执行任务。
import time
#串形

def getPage(url):
    print("开始爬取网站",url)
    time.sleep(2)#阻塞
    print("爬取完成!!!",url)


urls = ['url1','url2','url3','url4','url5']

beginTime = time.time()#开始计时

for url in urls:
    getPage(url)

endTime= time.time()#结束计时
print("完成时间%d"%(endTime - beginTime))
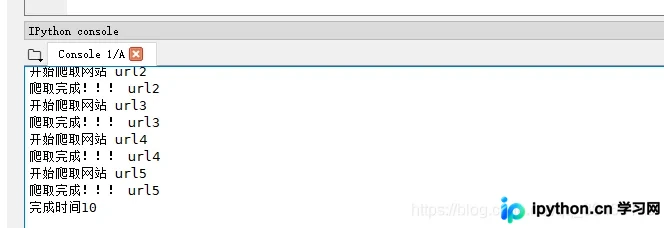
接下来,通过模拟爬取网站的过程,深入理解多线程、多进程以及协程的具体实现方式。
二、多线程实现
import time
#使用线程池对象
from multiprocessing.dummy import Pool

def getPage(url):
    print("开始爬取网站",url)
    time.sleep(2)#阻塞
    print("爬取完成!!!",url)


urls = ['url1','url2','url3','url4','url5']

beginTime = time.time()#开始计时

#准备开启5个线程,并示例化对象
pool = Pool(5)
pool.map(getPage, urls)#urls是可迭代对象,里面每个参数都会给getPage方法处理

endTime= time.time()#结束计时
print("完成时间%d"%(endTime - beginTime))
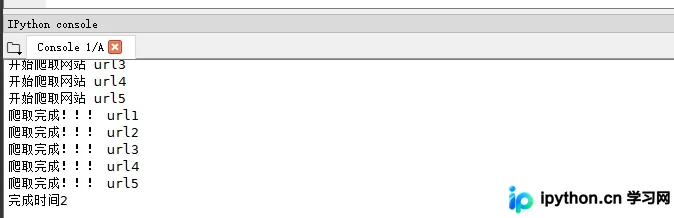
采用多线程方案后,完成所有任务的时间仅需2秒。
线程池的使用原则:适用于处理耗时且涉及阻塞操作的任务场景。
三、协程实现
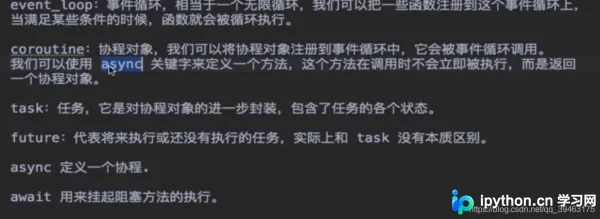
单线程配合异步协程是目前强烈推荐且流行的实现方式。
相关概念解析:
#%%
import time
#使用协程
import asyncio


async def getPage(url):  #定义了一个协程对象,python中函数也是对象
    print("开始爬取网站",url)
    time.sleep(2)#阻塞
    print("爬取完成!!!",url)

#async修饰的函数返回的对象
c = getPage(11)

#创建事件对象
loop_event = asyncio.get_event_loop()
#注册并启动looP
loop_event.run_until_complete(c)

#task对象使用,封装协程对象c
'''
loop_event = asyncio.get_event_loop()
task = loop_event.create_task(c)
loop_event.run_until_complete(task)
'''

#Future对象使用,封装协程对象c            用法和task差不多
'''
loop_event = asyncio.get_event_loop()
task       = asyncio.ensure_future(c)
loop_event.run_until_complete(task)
'''

#绑定回调使用

async def getPage2(url):  #定义了一个协程对象,python中函数也是对象
    print("开始爬取网站",url)
    time.sleep(2)#阻塞
    print("爬取完成!!!",url)
    return url

#async修饰的函数返回的对象
c2 = getPage2(2)

def callback_func(task):
    print(task.result()) #task.result()返回任务对象中封装的协程对象对应函数的返回值


#绑定回调
loop_event = asyncio.get_event_loop()
task       = asyncio.ensure_future(c2)

task.add_done_callback(callback_func)  #真正绑定,
loop_event.run_until_complete(task)
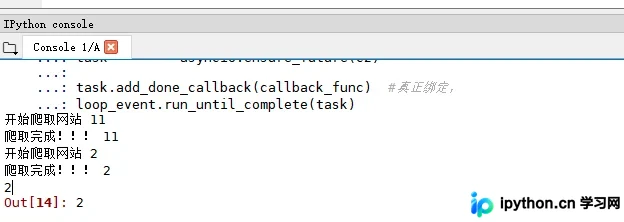
输出结果示例:
四、多任务协程实现
import time
#使用多任务协程
import asyncio


urls = ['url1','url2','url3','url4','url5']


async def getPage(url):  #定义了一个协程对象,python中函数也是对象
    print("开始爬取网站",url)
    #在异步协程中如果出现同步模块相关的代码,那么无法实现异步
    #time.sleep(2)#阻塞
    await asyncio.sleep(2)#遇到阻塞操作必须手动挂起
    print("爬取完成!!!",url)
    return url


beginTime = time.time()


#任务列表,有多个任务
tasks = []

for url in urls:
    c = getPage(url)
    task = asyncio.ensure_future(c)#创建任务对象
    tasks.append(task)
loop = asyncio.get_event_loop()
loop.run_until_complete(asyncio.wait(tasks))#不能直接放task,需要封装进入asyncio,wait()方法中

endTime = time.time()
print("完成时间%d"%(endTime - beginTime))
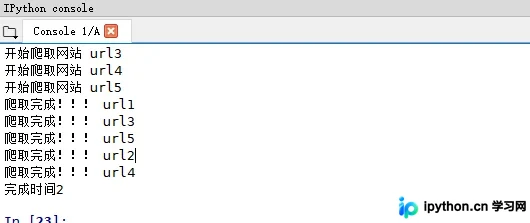
注意,此时若使用time.sleep(2)会导致阻塞,总耗时仍为10秒,无法体现异步优势。
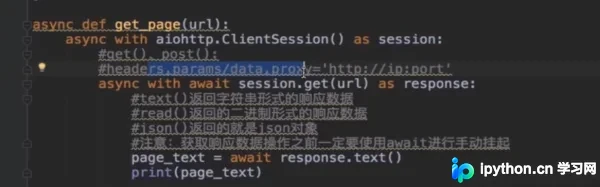
在真实的爬取过程中,例如在getPage()方法中调用requests.get(url)时,由于该模块基于同步方式实现,会造成阻塞。因此,应当使用异步网络请求模块aiohttp来替代。
参考以下代码实现:
async def getPage(url):  #定义了一个协程对象,python中函数也是对象
    print("开始爬取网站",url)
    #在异步协程中如果出现同步模块相关的代码,那么无法实现异步
    #requests.get(url)#阻塞
    async with aiohttp.ClintSession() as session:

                     async with await  session.get(url) as response: #手动挂起

                                       page_text =  await response.text() #.text()返回字符串,read()返回二进制数据,注意不是content
    print("爬取完成!!!",url)
    return page_text
到此,关于Python异步爬虫实现原理与知识总结的介绍已结束。如需了解更多Python异步爬虫相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









