

Python 爬取 Google Trends 数据实战:代理配置与代码实现
本文介绍使用 Python 爬取 Google Trends 数据的完整流程。核心思路是通过解析前端接口获取 token 和 req 参数,构造 URL 请求 JSON 数据。文章重点讲解了如何配置 SOCKS5 代理以解决网络访问问题,并提供了包含完整请求头、代理设置及数据处理逻辑的 Python 代码示例,帮助开发者实现趋势数据的自动化采集。
2026-10-14
6

本文介绍使用 Python 爬取 Google Trends 数据的完整流程。核心思路是通过解析前端接口获取 token 和 req 参数,构造 URL 请求 JSON 数据。文章重点讲解了如何配置 SOCKS5 代理以解决网络访问问题,并提供了包含完整请求头、代理设置及数据处理逻辑的 Python 代码示例,帮助开发者实现趋势数据的自动化采集。
本文介绍如何在Scrapy项目中配置多个爬虫同时运行。通过自定义commands模块,修改crawlall.py以遍历并启动所有spider,并在settings.py中指定模块路径。最后通过命令行验证命令可用性并执行启动,实现多爬虫并行抓取。
本文介绍使用Python的Selenium和Requests库批量获取B站直播主播头像并保存的方法。提供两种实现路径:一是通过官方API接口直接获取数据,二是利用Selenium定位HTML元素提取图片链接。代码包含环境安装、请求处理及文件保存逻辑,帮助开发者掌握网络爬虫基础技巧。
本文详细介绍Python中Shapely与Geopandas模块在地理数据处理中的应用。通过Shapely处理Point、LineString及Polygon等几何对象,实现距离计算、轨迹插值与Douglas-Pucker算法简化;利用Geopandas进行世界地图绘制、海洋数据预处理及GeoHash编码,结合3-sigma算法处理异常值,提升地理数据爬取与分析效率。
本文介绍了如何使用Python实现简单的索引排序与搜索功能。通过具体的代码示例和运行结果,展示了从数据抓取到索引构建及搜索的全过程。代码中包含详细注释,帮助读者理解实现逻辑。
本文详解Python获取网络数据的多种方法。从底层Socket通信原理出发,介绍利用urllib库简化HTTP请求的操作,并深入讲解如何使用ElementTree解析XML数据,以及利用json库高效处理JSON格式数据,为网络爬虫和数据抓取提供实用指南。
本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
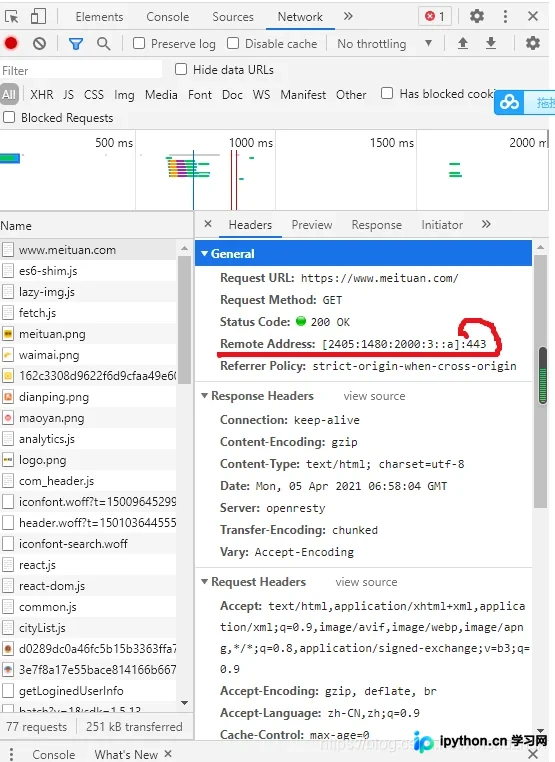
本文详细介绍Python爬虫开发前的核心基础知识,涵盖HTTP与HTTPS协议的区别、常见请求方式(GET与POST)及其应用场景。重点解析HTTP请求头参数、状态码含义,并演示如何利用浏览器开发者工具(Elements、Network、Console等)进行网站结构分析与数据抓取调试,帮助初学者快速掌握爬虫必备技能。
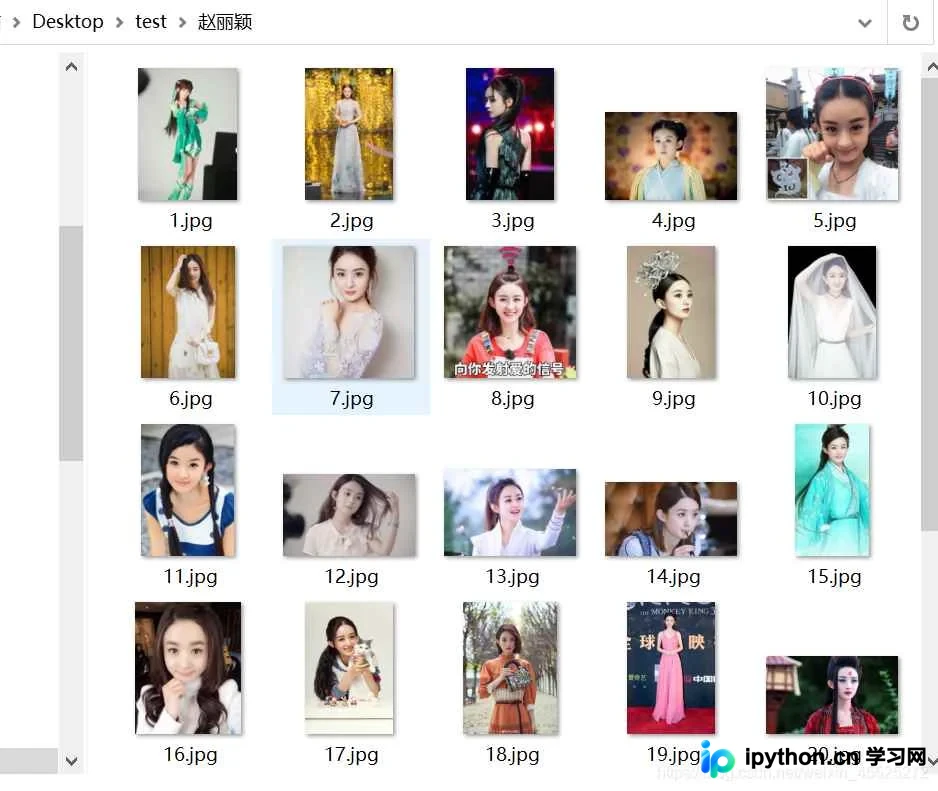
本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
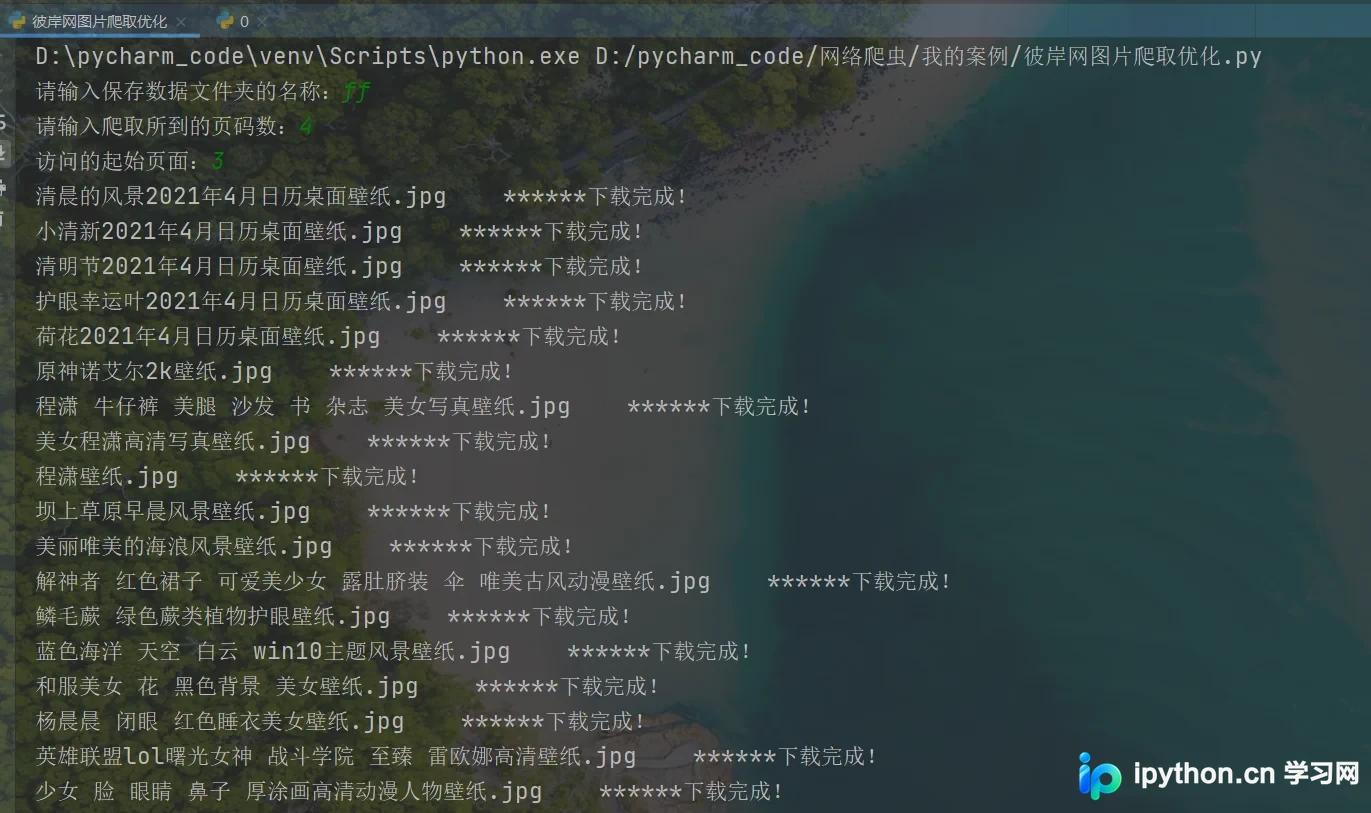
本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。
本文介绍使用Python进行Web站点邮箱扫描的完整流程。通过解析URL、利用requests获取网页内容,并结合正则表达式提取邮箱地址。脚本支持递归遍历超链接,实现批量收集目标站点的邮箱信息,为后续的安全测试或钓鱼攻击提供数据基础。
本文详细介绍如何使用Python的Pyppeteer库配合OpenCV实现京东登录滑块验证码的自动破解。通过解析滑块缺口距离并结合模拟鼠标拖动轨迹,提供完整的异步代码示例,帮助开发者掌握Web自动化中的反爬应对技巧。