

Python爬虫实战:异常处理与BeautifulSoup标签过滤详解

本文详细解析Python爬虫开发中的关键技巧,涵盖网络请求阶段的HTTPError与URLError异常处理,以及BeautifulSoup解析HTML时的NoneType错误防御。深入讲解find与find_all方法的区别、参数配置(如limit、recursive)及属性过滤技巧,通过豆瓣电影数据抓取实例,展示如何高效获取特定标签文本并处理常见编码问题,帮助开发者提升爬虫稳定性与数据提取精度。
Python爬虫异常捕获机制
在编写爬虫程序时,引入完善的异常捕获机制至关重要。这不仅能防止程序因意外错误而崩溃,还能帮助开发者快速定位问题所在,明确是网络请求失败还是页面解析出错,从而更有针对性地解决问题。
import ssl
import urllib.request
from bs4 import BeautifulSoup
from urllib.error import HTTPError, URLError


def get_data(url):
    headers = {"user-agent":
                   "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36"
               }
    ssl._create_default_https_context = ssl._create_unverified_context

    """
    urlopen处增加两个异常捕获:
            1、如果页面出现错误或者服务器不存在时,会抛HTTP错误代码
            2、如果url写错了或者是链接打不开时,会抛URLError错误
    """
    try:
        url_obj = urllib.request.Request(url, headers=headers)
        response = urllib.request.urlopen(url_obj)
        html = response.read().decode('utf8')
    except (HTTPError, URLError)as e:
        raise e

    """
    BeautifulSoup处增加异常捕获是因为BeautifulSoup对象中有时候标签实际不存在时,会返回None值;
    因为不知道,所以调用了就会导致抛出AttributeError: 'NoneType' object has no xxxxxxx。
    """
    try:
        bs = BeautifulSoup(html, "html.parser")
        results = bs.body
    except AttributeError as e:
        return None

    return results


if __name__ == '__main__':
    print(get_data("https://movie.douban.com/chart"))
对HTML内容进行解析后,能够更清晰地展示数据结构,便于后续的数据提取与展示。通过解析,我们可以将非结构化的网页代码转化为易于操作的对象模型。
- get_text():用于从BeautifulSoup标签对象中提取纯文本内容,去除HTML标签本身,仅保留文字信息。
# 此处代码同上面打开url代码一致,故此处省略......

html = response.read().decode('utf8')
bs = BeautifulSoup(html, "html.parser")
data = bs.find('span', {'class': 'pl'})
print(f'电影评价数:{data}')
print(f'电影评价数:{data.get_text()}')
运行上述代码后,控制台输出结果如下所示:
电影评价数:<span class="pl">(38054人评价)</span>
电影评价数:(38054人评价)- find() 方法用于在HTML文档中过滤标签,查找并返回第一个匹配指定条件的单个标签对象。
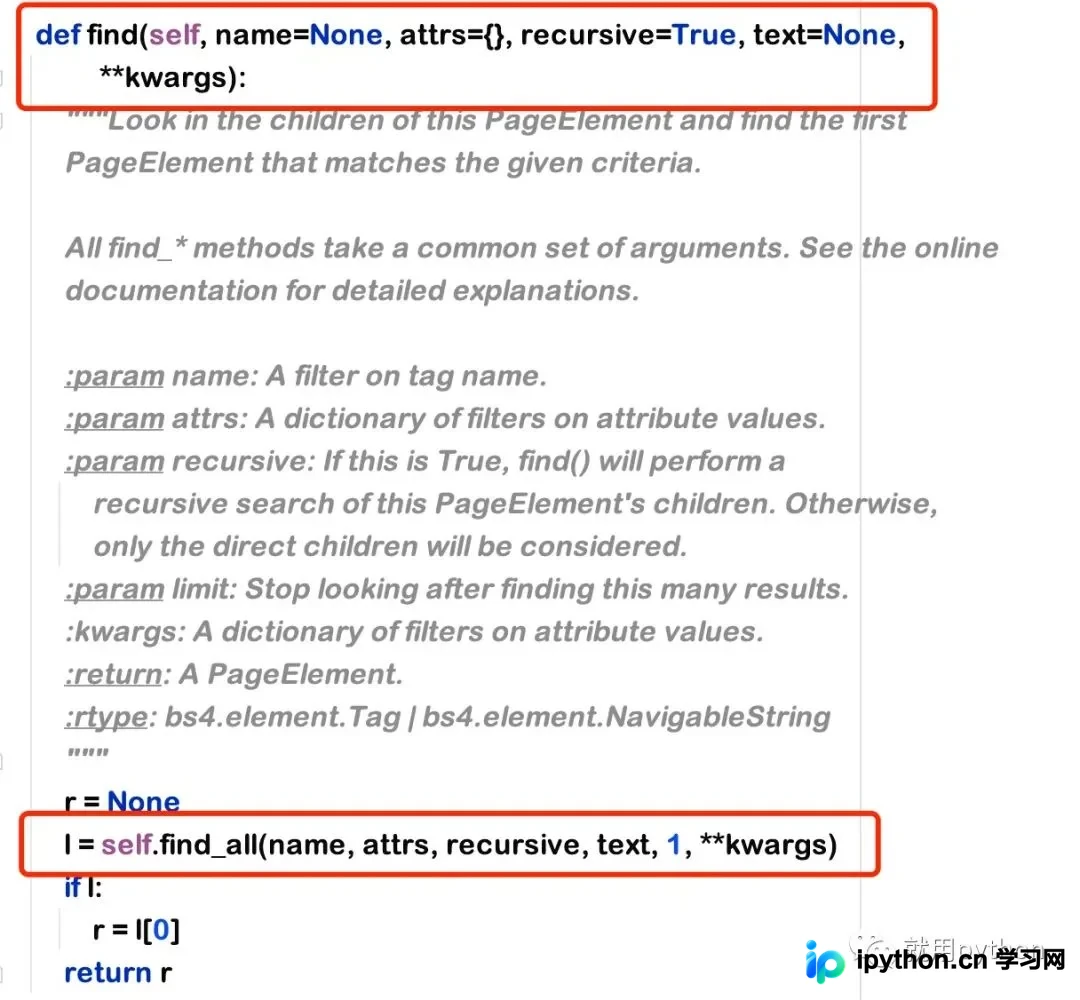
BeautifulSoup标签过滤详解
实际上,find方法的底层实现调用了find_all方法,并将limit参数设置为1,从而只获取匹配结果中的第一个标签。
1.name:表示当前标签元素的名称,例如div、span等,可直接理解为标签类型。
2.attrs:以字典格式存储标签的所有属性及其对应的值,例如 {"class": "indent"} 表示该标签具有class属性且值为indent。
3.recursive:布尔型递归参数。当设为True时,BeautifulSoup会递归查询子标签;若为False,则只搜索直接子节点。
4.text:用于匹配标签内的文本内容。注意区分标签本身的文本内容与标签属性,text参数专门用于筛选包含特定字符串的标签节点。
- find_all() 方法同样用于过滤HTML标签,但其功能是查找并返回所有匹配指定条件的标签列表。
其基本用法与find方法一致,主要区别在于find_all支持额外的limit参数,用于限制返回结果的数量,从而实现更灵活的数据筛选。
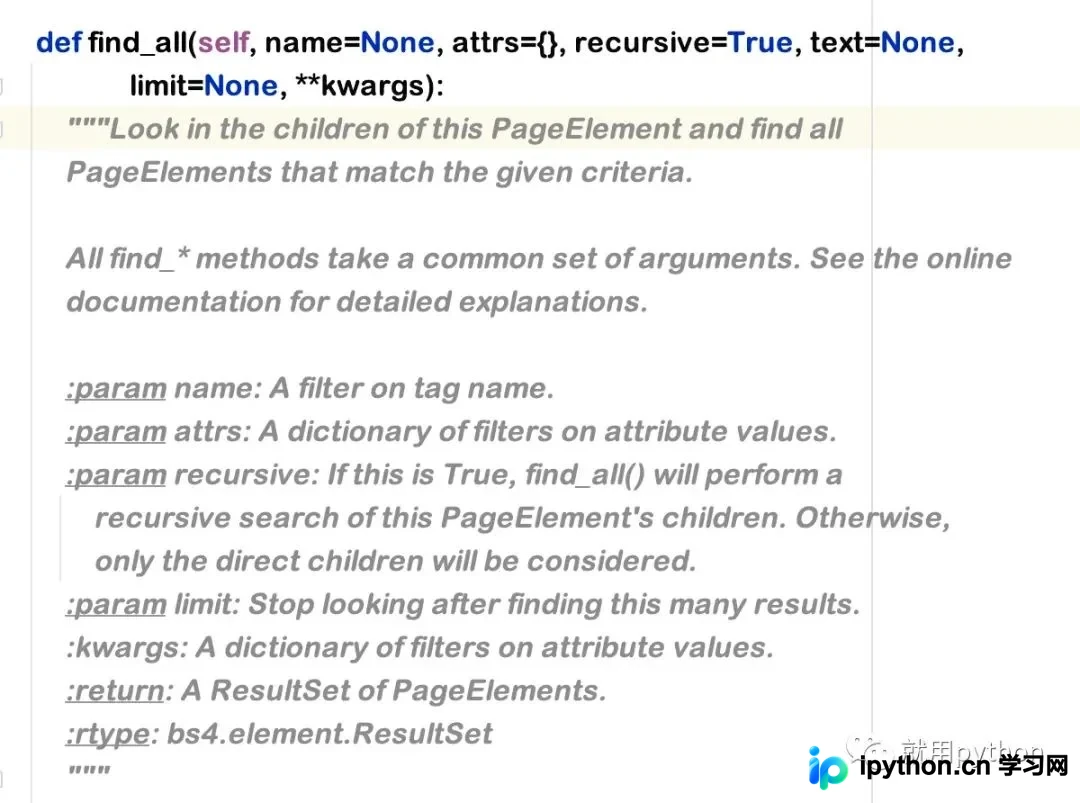
find_all方法使用注意事项
在实际使用中,必须注意以下关键细节:
#   下面两种写法,实际是一样的功能,都是查询id为text的属性值
bs.find_all(id="text")
bs.find_all(' ', {"id": "text"})
#   如果是class的就不能class="x x x"了,因为class是python中类的关键字
bs.find_all(class_="text")
bs.find_all(' ', {"class": "text"})
本文介绍了Python爬虫中异常捕获及标签过滤的核心技术。更多相关Python异常处理及标签过滤的高级技巧,欢迎查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









