

Python爬虫入门:requests模块安装与基础实战

发布时间:2026-10-14| 6人浏览过
本文介绍Python爬虫的基础流程,包括指定URL、发送请求及数据存储三步。详细讲解requests外部库的安装方法,并通过完整代码示例演示如何爬取搜狗首页并保存为HTML文件,帮助初学者快速掌握网络数据抓取的基本操作。
一、爬虫的流程
在开始学习爬虫技术之前,理解其基本流程框架至关重要。无论目标数据是什么类型,爬虫的核心逻辑通常可以归纳为以下三个步骤:
1. 确定目标URL,即指定需要抓取数据的网页地址。
2. 发送网络请求。使用requests模块时,主要涉及GET和POST两种请求方式。
3. 获取并存储爬取到的数据。
二、requests模块的导入
由于requests属于第三方外部库,并非Python内置模块,因此需要用户自行安装导入。
具体的安装步骤如下:
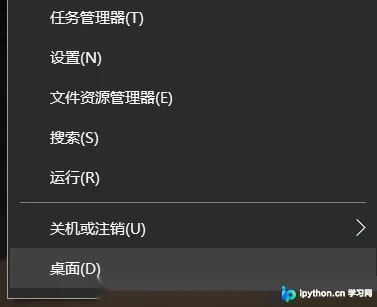
1. 右键点击Windows系统图标。
2. 在弹出的菜单中选择“运行”。
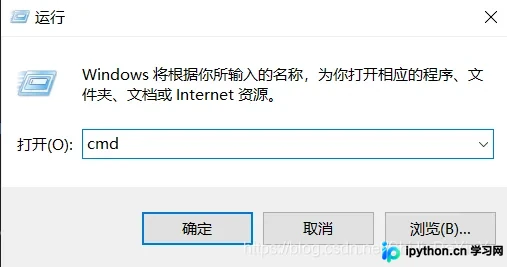
3. 在输入框中键入“cmd”以打开命令提示符窗口。
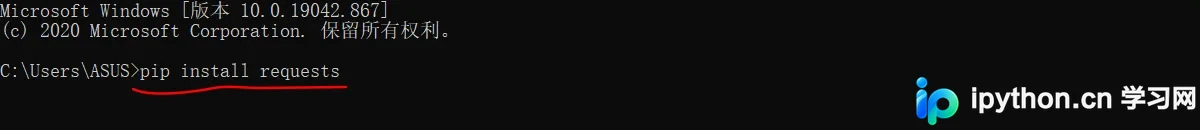
4. 在命令行中输入“pip install requests”并回车,等待下载及安装完成。
如图:
若安装过程中遇到失败情况,建议通过搜索引擎查询具体报错原因(注:作者水平有限,仅供参考)。
安装成功后,我们可以尝试编写一个简单的脚本,爬取搜狗网站的首页内容。
三、完整代码
import requests

if __name__ == "__main__":
    # 指定url
    url = "https://www.sougou.com/"

    # 发起请求
    # get方法会返回一个响应数据
    response = requests.get(url)

    # 获取响应数据
    page_txt = response.text # text返回一个字符串的响应数据
    # print(page_txt)

    # 存储
    with open("./sougou.html", "w", encoding = "utf-8") as fp:
        fp.write(page_txt)

    print("爬取数据结束!!!")
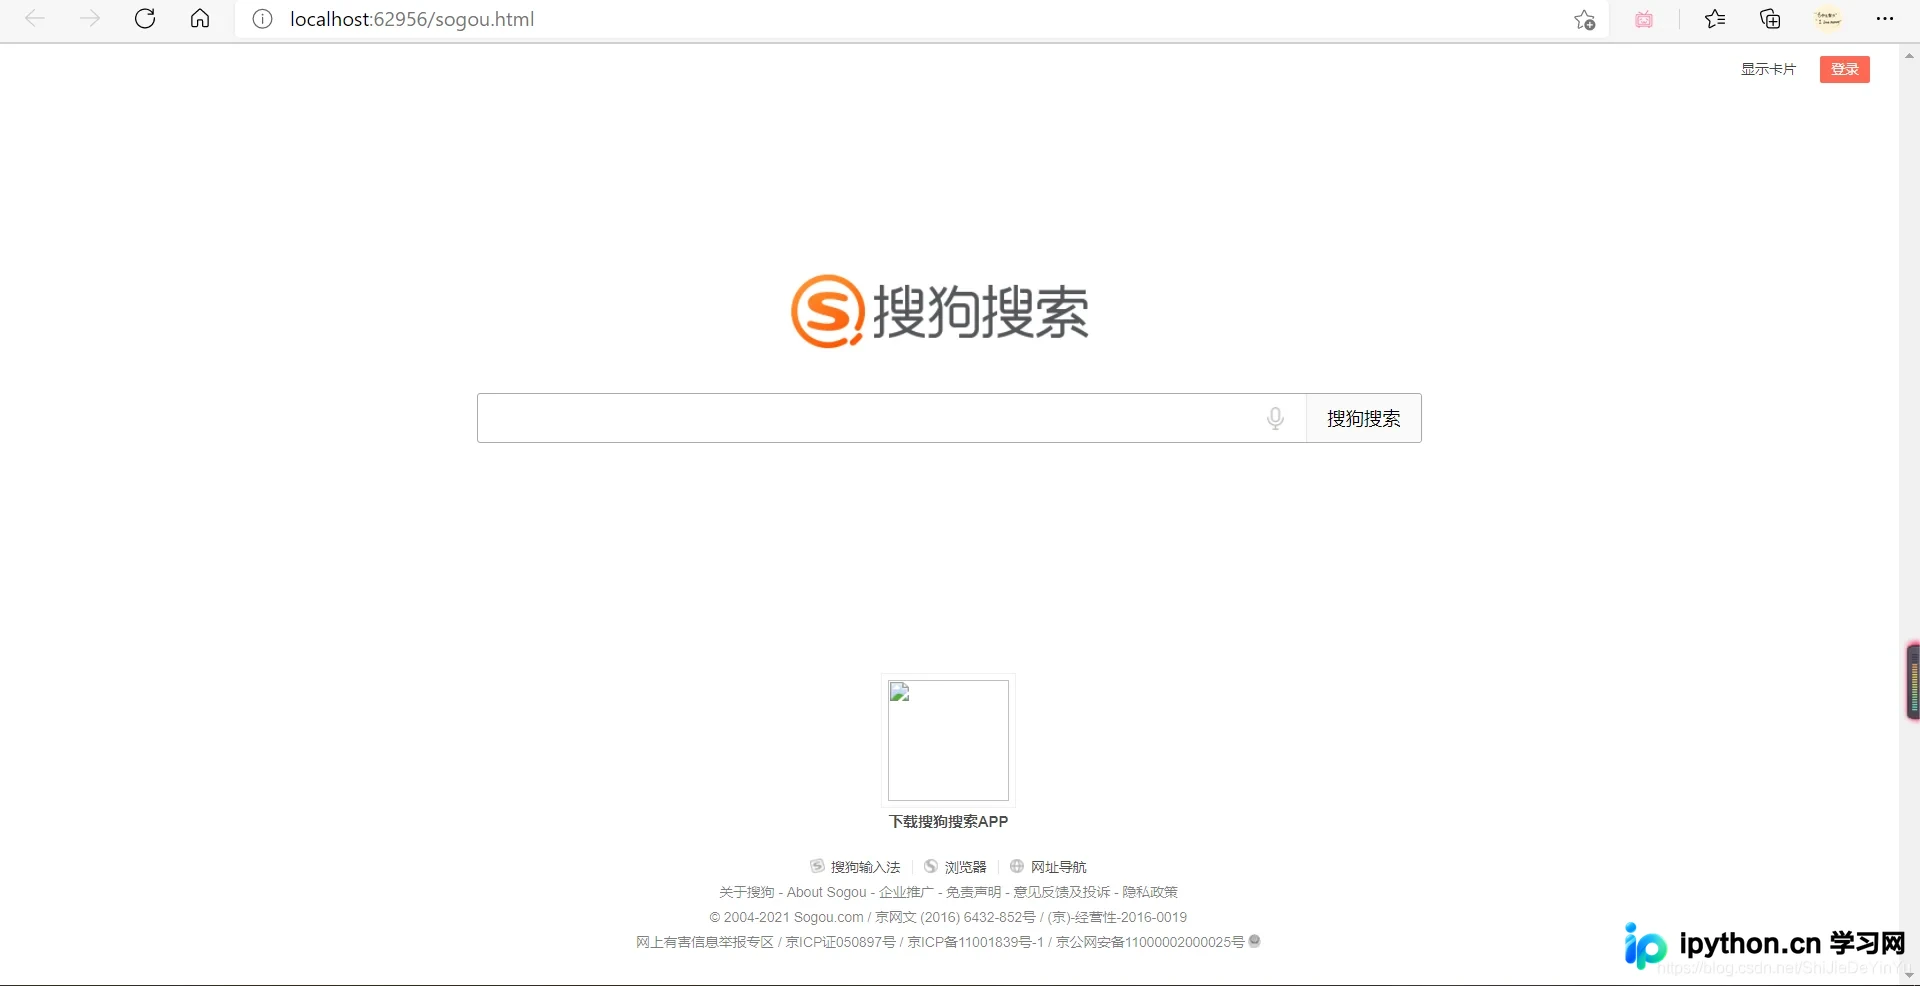
运行上述代码后,保存生成的文件,效果如图。
这就是最基础的网页爬取示例。如果读者已掌握此方法,可以尝试进一步挑战爬取B站首页。
至此,关于Python爬虫基础及requests模块的介绍到此结束。如需了解更多Python requests相关内容,请搜索本站往期文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









