

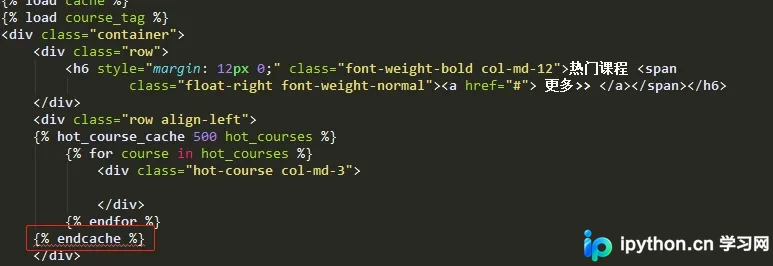
Django模板碎片缓存优化:自定义标签实现按需加载
本文深入探讨Django模板碎片缓存的性能瓶颈,指出常规方式需视图层预取数据导致冗余。通过实现自定义模板标签,引入回调函数机制,实现缓存数据的按需获取与渲染解耦。该方法避免了视图层重复代码,提升了内存利用率,并提供了完整的代码实现示例及IDE兼容性说明。
2026-10-13
6

本文深入探讨Django模板碎片缓存的性能瓶颈,指出常规方式需视图层预取数据导致冗余。通过实现自定义模板标签,引入回调函数机制,实现缓存数据的按需获取与渲染解耦。该方法避免了视图层重复代码,提升了内存利用率,并提供了完整的代码实现示例及IDE兼容性说明。
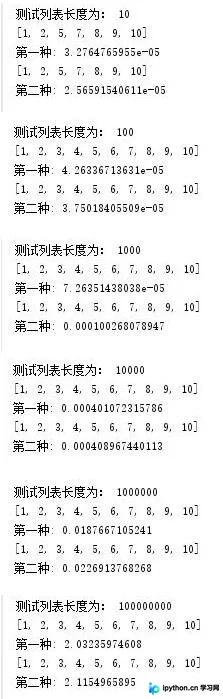
本文对比了Python中两种常见的列表去重方式:set()与{}.fromkeys().keys()。测试表明,在列表长度较短(小于1000)时,fromkeys方法速度更快;而当列表长度超过1000时,set()方法优势显著。文章提供了具体的测试代码与结果分析,并针对大规模数据处理给出了工具选择建议。
本文介绍Python读取千万行大表时避免内存溢出的方案。通过MySQLdb.cursors.SSCursor流式游标,逐行返回数据而不缓存全量结果,结合fetchone迭代处理,显著降低内存占用。需注意SSCursor期间连接独占及60秒超时限制,建议快速处理数据或调整NET_WRITE_TIMEOUT参数。
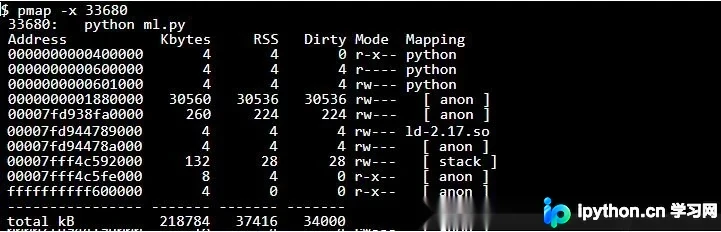
本文记录Python程序内存持续增长的排查过程。通过psutil监控进程内存,利用pmap分析堆内存,结合gc.collect强制垃圾回收,并使用memory_profiler定位高消耗代码行。最后借助guppy库深入分析对象占用,发现95%内存被列表占用,为定位逻辑导致的内存泄漏提供完整解决方案。
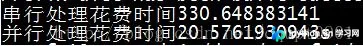
本文介绍利用Python multiprocessing模块的Pool进程池,结合jieba库对海量文本进行高效关键词提取的方法。通过对比单进程与多进程处理581行、7MB语料的耗时,验证了多进程异步处理的性能优势,并指出移除模拟延迟可显著缩短运行时间,为大规模文本分析提供实用参考。
本文详细介绍Python系统监控模块psutil的功能与经典用法。psutil是一个跨平台库,支持Linux、Windows、OS X等系统,可获取CPU、内存、磁盘、网络及进程信息。文章涵盖安装方法及CPU时间、内存使用、磁盘IO、网络统计和进程管理等核心代码示例,帮助开发者快速实现系统资源监控。
本文详解如何使用 joblib 库为 pandas 的 apply 函数实现多进程处理,以去停用词为例对比单进程与多进程的性能差异。通过 groupby 分组并行执行,展示了在大数据量下多进程的优势及小任务下的开销陷阱,帮助开发者合理选择并行策略。
本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
本文深入解析Python中二维数据的两种主要实现方式:内置list与NumPy的array。通过代码实例对比两者在索引操作上的差异,重点展示numpy.array支持的多元组索引与切片功能,并分析list存储对象指针带来的内存开销。旨在帮助开发者根据场景选择合适的数据结构,提升数据处理效率。
针对Pandas处理亿行级大文件时内存溢出的问题,本文介绍了一种通过String中间格式降低内存占用的策略。虽然Pandas官方提供了to_string方法,但未直接提供反向转换。通过利用StringIO将字符串数据封装为文件对象,再配合read_csv函数,即可高效地将String还原为DataFrame,从而规避pickle保存时的额外内存开销。
本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
本文探讨在Python中处理百万级对象实例时的内存优化方案。通过解析__dict__机制对内存的占用,介绍使用__slots__声明固定属性列表的方法。该方法能禁用动态属性添加,从而显著降低单个实例的内存消耗,适用于游戏服务器等高性能场景。