Python逐行读取文件的高效方法与原理
本文介绍使用Python逐行分析文本文件的最佳实践。通过示例代码展示如何利用while循环结合readline()方法,实现低内存占用和高处理速度的文件读取。该方法特别适用于CGI脚本或处理海量数据场景,确保程序稳定运行且不影响系统性能。
2026-10-13
6

本文介绍使用Python逐行分析文本文件的最佳实践。通过示例代码展示如何利用while循环结合readline()方法,实现低内存占用和高处理速度的文件读取。该方法特别适用于CGI脚本或处理海量数据场景,确保程序稳定运行且不影响系统性能。
本文通过实际测试对比Django中ForeignKey反向查询的两种常用方式:使用_set.all()与objects.filter()。实验结果显示,在10000次查询下,filter方法耗时略少,效率更高。文章提供了完整的模型定义、数据构造及timeit测试代码,帮助开发者在SEO和性能敏感场景下做出更优选择。
本文深入对比Python与C++在运行效率和开发效率上的差异。C++凭借编译执行和底层优化,在运行速度上显著优于Python;而Python凭借简洁语法和解释器,大幅提升了开发效率。文章通过字符串操作和JSON解析等实例,说明两者在不同场景下的适用性,帮助开发者根据项目需求做出合理选择。
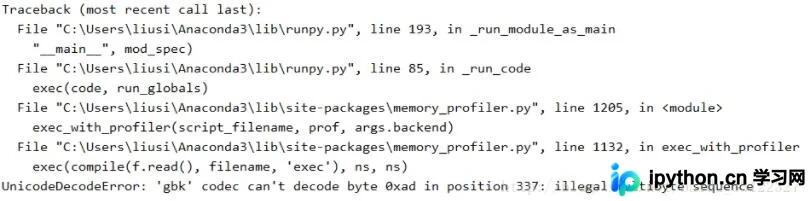
本文介绍如何使用memory_profiler及其mprof命令监测Python函数的最大内存消耗。通过安装memory_profiler和psutil,在命令行执行mprof run生成.dat数据文件,并利用mprof plot绘制内存随时间变化的统计图。同时提供了解决GBK解码错误的代码修改方案及@profile装饰器的使用注意事项。
本文介绍如何在 pandas 中高效处理非标准日期格式。通过对比两种处理方式,展示使用 to_datetime 函数时指定 format 参数对提升处理速度的关键作用。示例显示,对于300万条数据,明确指定格式可将处理时间从10分钟缩短至10秒。
本文深入解析Numpy中的向量式三目运算符np.where,通过对比纯Python列表推导式与np.where的运算结果,验证两者在数值上的一致性。重点展示np.where在处理条件筛选时如何利用向量化计算显著加速运算过程,适用于需要高效数据筛选的场景。
本文深入探讨Python中列表切片[:]和[::]在复制列表时的异同。在Python 3中,两者生成的字节码完全一致,无性能差异;但在Python 2.x中,[:]因指令更少而略高效。文章通过dis模块分析字节码,并指出该特性适用于所有序列类型,建议开发者根据版本选择写法。
本文介绍Python Tkinter中ScrolledText组件批量插入数据的优化方法。通过对比逐行插入与一次性拼接字符串后插入两种方式,演示如何利用字符串join操作将写入效率提升百倍,有效解决大量数据输出时的界面卡顿问题。
本文介绍Python中判断字典key存在的两种常用方法:使用has_key()函数和使用in运算符。虽然has_key()在Python 2.2之前可用,但推荐优先使用in方法,因其执行速度更快且符合现代Python编程规范。同时补充了not in用于判断key不存在的用法。
本文介绍在TensorFlow中如何利用tf.tile函数结合矩阵乘法,将低效的Python for循环转换为高效的批量矩阵运算。通过示例对比,展示了使用tf.tile扩展维度并执行reduce_sum或matmul操作,从而显著提升模型推理速度,避免显式循环带来的性能瓶颈。
本文介绍使用NumPy对矩阵进行归一化的具体实现方法。核心在于将均值、最大值和最小值的计算结果预先存储为变量,避免在循环中重复计算,从而显著提升处理速度。文章提供了简洁的五行代码示例及关键注意事项,适用于需要高效数据预处理的Python开发场景。
本文详解使用Python Pillow库将文本转换为便签图片的全过程。重点解决长文本自动换行、背景图动态生成及字体渲染问题,并通过对比Python 2与3的性能差异,提出减小图片尺寸、调整字体及利用内网上传等优化方案,显著提升生成效率。