

Python机器学习项目实战:8个提升代码质量与效率的实用建议
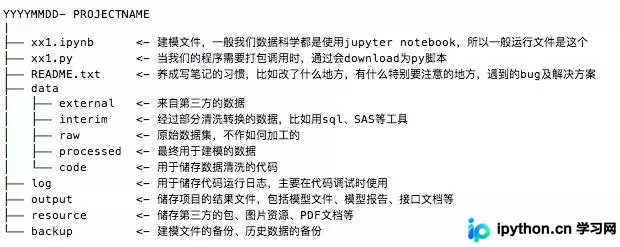
本文总结了Python机器学习项目中的8个关键实践,涵盖从项目归档、源数据备份、路径配置到代码注释、循环加速、进度可视化、高效调试及异常处理的完整工作流。通过引入Git、Rsync等工具及PySnooper、tqdm等库,帮助开发者规避常见陷阱,提升代码的可维护性与执行效率,适合Python入门及进阶开发者参考。
2026-10-13
6

本文总结了Python机器学习项目中的8个关键实践,涵盖从项目归档、源数据备份、路径配置到代码注释、循环加速、进度可视化、高效调试及异常处理的完整工作流。通过引入Git、Rsync等工具及PySnooper、tqdm等库,帮助开发者规避常见陷阱,提升代码的可维护性与执行效率,适合Python入门及进阶开发者参考。
本文详细解析Python的内存管理机制,涵盖引用计数原理、垃圾回收(GC)处理循环引用的策略,以及针对小块内存申请的内存池优化。通过理解对象创建、销毁时的引用变化及pymalloc分配器,有助于提升Python程序的性能与内存使用效率。
本文介绍利用Python进行接口并发压力测试的方法,涵盖并发数、响应时间、吞吐量及性能计数器等核心指标。通过示例脚本演示如何构建多线程压测工具,计算QPS与错误率,并解析Linux系统资源监控命令,帮助开发者掌握接口性能评估的关键技术。
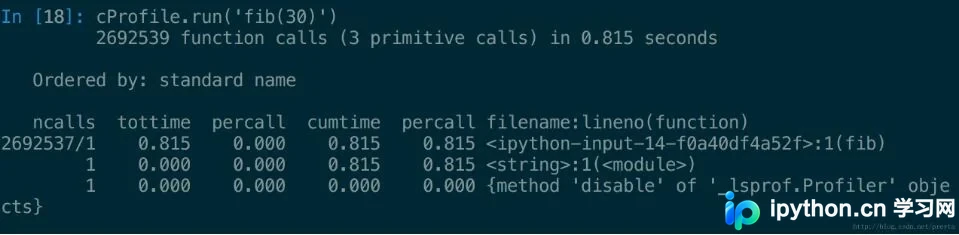
本文详细介绍Python标准库中用于性能测试的cProfile和pProfile模块,重点讲解cProfile.run()与runctx()用法及输出字段含义。通过fib函数示例,演示如何利用lru_cache缓存与迭代法优化递归性能,并展示pstats对测试结果的聚合、排序与过滤功能,帮助开发者高效定位性能瓶颈。
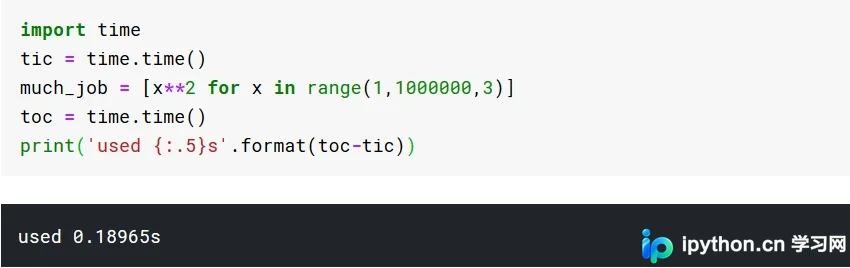
本文系统整理了24个Python性能优化技巧,涵盖代码计时、查找与循环加速、函数优化、标准库与高阶函数应用、NumPy向量化、Pandas及Dask数据处理,以及多线程多进程并行计算。通过对比低速与高速实现方案,帮助开发者显著提升代码执行效率。
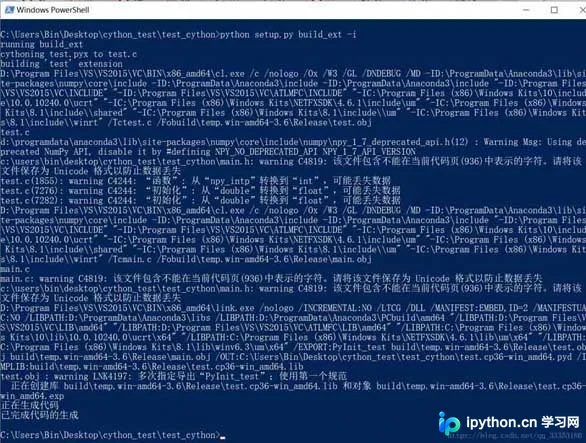
本文详细介绍如何利用Cython将C语言代码编译为Python扩展库,以实现高性能计算。通过一个Numpy矩阵运算示例,演示了从C头文件编写、Cython接口定义到setup.py配置及编译运行的完整流程。重点解析了二维数组降维传递、类型声明及内存访问技巧,展示了将循环置于C层以提升执行效率的方法。
本文深入解析Python递归函数的执行机制,包括栈帧创建与销毁过程。详细阐述递归的边界条件、退出条件及深度限制(CPython 1000层),并通过斐波那契数列示例对比递归与循环的性能差异,提供避免栈溢出的实用建议。
本文介绍使用Python实现多进程拷贝文件夹并实时显示百分比进度的方法。通过对比单进程与多进程在1核CPU环境下的执行耗时,分析任务切换开销对性能的影响,并提供基于shutil模块的完整代码示例供参考。
本文系统梳理Python中字符串拼接的七种方式,包括%、format()、f-string等。重点解析CPython常数折叠机制对短字符串拼接的性能影响(长度限制20),并对比各方法在可读性、灵活性与执行效率上的差异,为不同场景下的字符串处理提供选型建议。
本文通过Python代码对比字符串拼接中+运算符与join方法的性能差异。由于字符串不可变性,频繁使用+号会导致大量临时对象创建,内存消耗随数据量增加而显著上升。测试数据显示,在处理百万级及以上数据时,join方法结合列表追加的方式耗时远低于直接拼接,建议大数据量场景优先使用join。
本文介绍使用Python逐行分析文本文件的最佳实践。通过示例代码展示如何利用while循环结合readline()方法,实现低内存占用和高处理速度的文件读取。该方法特别适用于CGI脚本或处理海量数据场景,确保程序稳定运行且不影响系统性能。
本文通过实际测试对比Django中ForeignKey反向查询的两种常用方式:使用_set.all()与objects.filter()。实验结果显示,在10000次查询下,filter方法耗时略少,效率更高。文章提供了完整的模型定义、数据构造及timeit测试代码,帮助开发者在SEO和性能敏感场景下做出更优选择。