

使用 Numba 加速 Python 科学计算实例
本文介绍如何使用 Numba 库通过即时编译(JIT)技术显著提升 Python 代码的执行速度。重点讲解 @jit 装饰器的用法、nopython 模式的优势,以及针对 NumPy 数组和循环密集型计算的优化策略,帮助开发者在科学计算场景中实现接近 C 语言的运行效率。
2026-10-11
6

本文介绍如何使用 Numba 库通过即时编译(JIT)技术显著提升 Python 代码的执行速度。重点讲解 @jit 装饰器的用法、nopython 模式的优势,以及针对 NumPy 数组和循环密集型计算的优化策略,帮助开发者在科学计算场景中实现接近 C 语言的运行效率。
本文深入解析PyPy如何通过JIT编译和优化的垃圾回收机制显著提升Python代码执行速度。通过对比CPython,展示在长时间运行脚本中的性能优势,并明确指出C扩展模块和短脚本场景下的局限性,帮助开发者合理选择解释器。
本文介绍Python中两种常用的性能分析工具:%timeit与Line_profiler。通过示例演示如何使用%timeit进行单行或多行代码的性能测试,包括自定义运行次数与循环次数。同时,详细讲解如何安装、加载Line_profiler,并利用%lprun命令进行逐行性能分析,帮助开发者快速定位代码瓶颈。
本文深入解析Python程序加速运行的核心方法。从基础层面探讨将代码封装为函数、利用局部变量优势、预绑定方法以及使用内置容器等技巧,有效减少属性查找开销。进阶部分介绍PyPy的JIT编译与Numba的LLVM加速技术,并强调在追求性能前确保逻辑正确性的重要性。
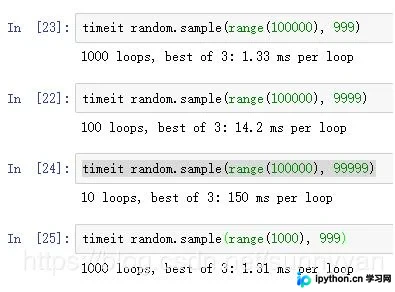
针对Python中random.sample()在大规模数据下执行缓慢的问题,本文介绍了使用numpy.random.choice作为高效替代方案。通过设置replace=False确保无放回抽样,并结合权重参数(weights/cum_weights)实现复杂场景下的随机抽取,显著提升处理效率。
本文深入探讨Python中列表去重的多种实现方式,涵盖新建列表、原地删除、利用Set和Dict结构以及NumPy库等近20种方法。通过具体代码示例与时间复杂度分析,对比各方案在Python 2.7及更高版本中的执行效率与适用场景,帮助开发者根据实际需求选择最优的去重策略。
本文详细介绍如何在Django项目中引入SQLAlchemy构建数据库连接池,以解决高负载下频繁创建销毁连接的性能瓶颈。文章提供了两种修改Django源码的方法,重点解析了处理kwargs中字典类型导致的unhashable错误的关键代码修改,并附带了适用于Django 1.7与Python 2.7环境的配置示例。
本文探讨在Python中计算列表中连续相同元素最大个数的两种方法:使用itertools.groupby和手动遍历。通过100万条数据的基准测试,对比发现手动实现方法在性能上显著优于itertools方案,适合对效率有严格要求的场景。
本文介绍在Python 2.7.13环境中,通过遍历locals()字典并手动删除局部变量,配合gc.collect()强制垃圾回收,以释放函数执行后占用的内存。该方法适用于需要显式控制资源释放的场景,但需注意其适用性与潜在风险。
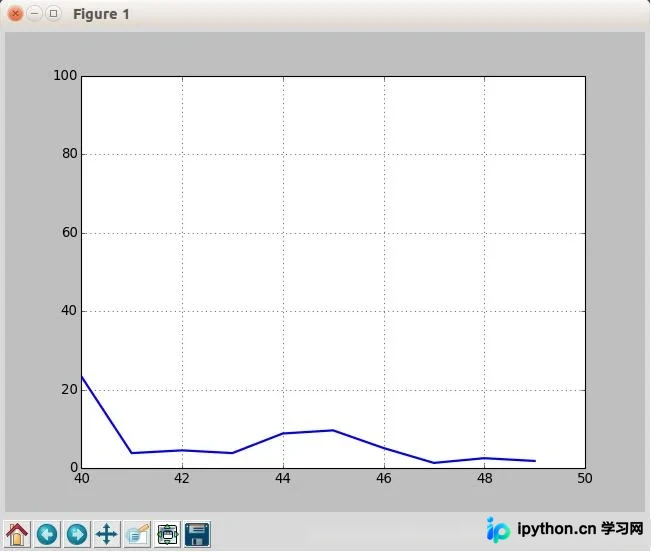
本文介绍如何使用Python的matplotlib和psutil库实现动态CPU性能监控。通过编写自定义脚本,实时获取CPU使用率并绘制动态图表,帮助开发者直观掌握系统资源使用情况。
本文介绍在 Python 中如何高效地对数据进行转换和聚合处理。通过生成器表达式作为函数参数,可以避免创建临时列表,从而节省内存并提升执行效率。文章涵盖平方和计算、文件筛选、元组转 CSV 及字典列表最小值查找等具体场景,展示优雅且高性能的代码实现方式。
本文深入解析Pandas中高性能函数eval和query的使用。通过对比NumPy和Pandas内置运算,展示eval在复杂表达式计算中的性能优势,并结合numexpr库说明其底层原理。文章提供具体代码示例,演示如何利用eval和query优化大规模数据集的处理效率,帮助开发者提升数据分析性能。