Python二元赋值性能优化解析
本文深入解析Python中二元赋值(如a += 3)与一元赋值(如a = a + 3)的性能差异。重点探讨在可变对象操作中,二元赋值如何通过原地修改避免内存拷贝和对象重建,从而提升效率。文章通过代码示例对比了不同赋值方式在列表操作中的表现,指出虽然引用拷贝开销微小,但表达式评估次数和内存分配策略仍是关键影响因素。
2026-10-13
6

本文深入解析Python中二元赋值(如a += 3)与一元赋值(如a = a + 3)的性能差异。重点探讨在可变对象操作中,二元赋值如何通过原地修改避免内存拷贝和对象重建,从而提升效率。文章通过代码示例对比了不同赋值方式在列表操作中的表现,指出虽然引用拷贝开销微小,但表达式评估次数和内存分配策略仍是关键影响因素。
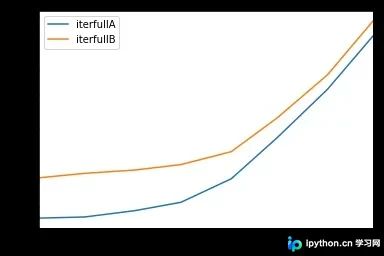
本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
本文详解如何利用Django、Celery和Nginx构建高性能网站架构。通过Celery异步生成静态首页,减轻数据库查询压力;配置Nginx直接提供静态文件服务,实现动静分离。同时介绍在Admin后台数据变更时自动触发静态页面重新生成的机制,有效提升网站访问速度与系统稳定性。
本文详解 Python 中处理复杂文本过滤与清理的多种方案。涵盖使用 str.translate() 进行字符映射、利用 unicodedata 处理 Unicode 组合字符与重音符号,以及通过 encode/decode 剥离非 ASCII 字符。重点对比 str.replace() 与 translate() 的性能差异,提供针对空格、控制字符及数字转换的高效代码示例,帮助开发者在保持数据纯净的同时优化运行效率。
本文通过具体代码实例,对比了Python原生列表循环累加与NumPy数组向量化运算在向量相加任务中的执行效率。测试结果显示,当处理1000个元素的向量时,Python原生实现耗时约1000微秒,而NumPy实现耗时为0微秒。文章详细展示了两种方法的代码实现及运行结果,揭示了NumPy在数值计算方面的显著性能优势。
本文深入解析Python中自定义可迭代类的实现原理。通过对比列表与迭代器的内存消耗差异,阐明迭代器按需加载的优势。详细讲解__iter__和__next__特殊方法的定义与调用机制,并结合直角三角形与斐波那契数列两个代码实例,展示如何构建无限迭代器及控制迭代边界,帮助开发者优化大数据处理性能。
本文介绍如何在Python中利用pathos.multiprocessing库结合tqdm实现多进程并行计算及进度条显示。针对标准multiprocessing库仅支持单参数输入的局限,pathos可处理多参数函数。通过示例展示了如何定义迭代函数、配置超参数数组,并监控进程执行进度,有效加速高复杂度计算任务。
本文分析Python处理大文件时速度逐渐变慢的现象,排查了GC和Git同步等干扰因素,最终定位到使用in dict.keys()进行键存在性检查导致的性能瓶颈。通过对比测试,推荐使用in dict直接判断或has_key()方法,显著提升处理效率,并解释了Python3中has_key()被移除的背景。
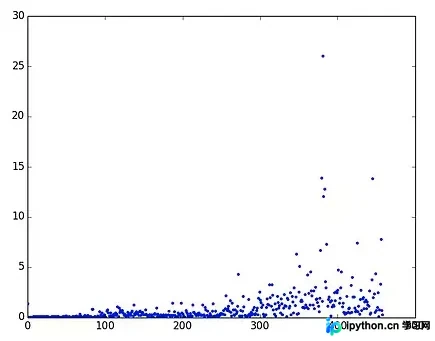
本文深入解析Python中多线程与多进程的实现机制,重点剖析GIL(全局解释器锁)对CPU密集型任务的影响。通过对比实验展示线程与进程在运算耗时上的显著差异,明确多线程适用于IO密集型场景,而多进程更适合CPU密集型任务,为开发者提供清晰的并发编程选型依据。
本文详解Python中两款内存监控工具memory_profiler和guppy的使用。针对Python2.7内存池机制导致的内存膨胀问题,通过逐行监控和变量占比分析,定位并解决py-faster-rcnn中图像推理时的内存持续增长现象,提供具体的代码修改建议。
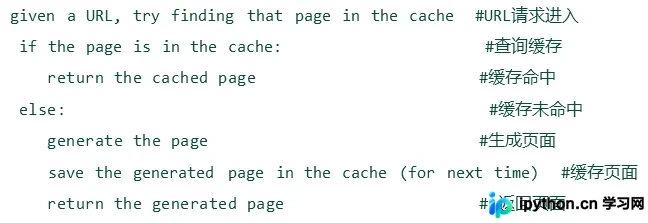
本文深入解析Django的缓存机制,涵盖缓存目的、类型及粒度。详细演示Memcached后端配置(TCP/Unix Socket/集群),并通过代码示例展示Django Cache API的具体用法,包括连接管理、数据读写及过期处理,帮助开发者提升系统性能。
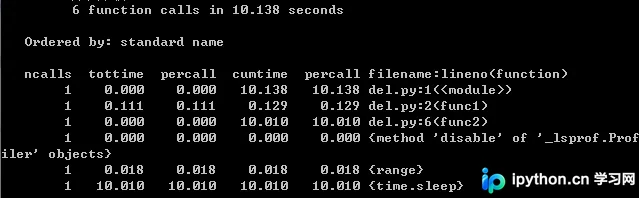
本文详细介绍Python内置的cProfile性能分析工具。通过具体代码示例,演示如何使用命令行直接运行cProfile以及保存结果文件进行后续分析。重点讲解pstats模块的sort_stats参数,包括按时间排序等常用选项,帮助开发者快速定位性能瓶颈。