

Python实现斐波那契数列:递归、尾递归与循环的性能深度对比
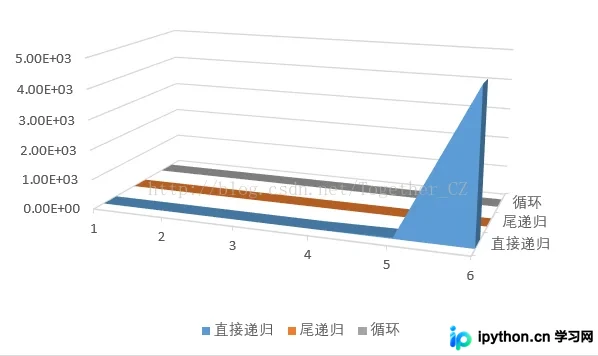
本文深入解析Python中斐波那契数列的三种实现方式:直接递归、尾递归及循环。通过代码示例与实测数据对比,揭示直接递归在数值增大时呈指数级增长的时间消耗,而尾递归与循环则保持极低的耗时。文章指出循环性能略优于尾递归,建议在实际开发中优先使用循环或尾递归以规避栈溢出风险并提升执行效率。
2026-10-13
6

本文深入解析Python中斐波那契数列的三种实现方式:直接递归、尾递归及循环。通过代码示例与实测数据对比,揭示直接递归在数值增大时呈指数级增长的时间消耗,而尾递归与循环则保持极低的耗时。文章指出循环性能略优于尾递归,建议在实际开发中优先使用循环或尾递归以规避栈溢出风险并提升执行效率。
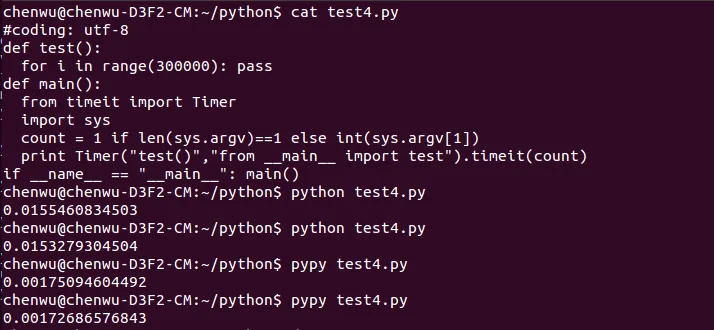
本文深入解析PyPy架构,阐述其由RPython实现的解释器与支持多后端的编译器两部分组成。通过对比CPython、Pyston与PyPy的性能测试数据,展示PyPy在纯Python代码中的显著速度优势。同时分析PyPy在C/C++混合编程场景下的局限性,介绍ctypes与cffi两种扩展方式,并指出当前PyPy在C扩展兼容性方面仍存在的挑战。
本文介绍在Python数据挖掘场景中,如何通过封装方法并利用[[wp:a1]]中的cached_property实现结果的缓存与延迟加载。通过示例展示,该方法确保复杂计算仅执行一次,后续调用直接返回缓存值,从而显著提升重复调用时的性能与资源利用率。
本文探讨Python中处理大文件解压与读取的常见问题,重点解决因编码格式不一致导致的解压失败。通过引入'ignore'参数规避严格编码检查,并对比不同读取方式的性能,验证了逐行读取处理百万级数据行的可行性与效率,为大数据文件操作提供参考。
本文介绍在Python中使用re模块时,通过compile函数将正则表达式预编译为RegexObject对象的方法。相比每次调用模块级函数,预编译能复用编译结果,避免重复解析开销,从而显著提升多次匹配场景下的搜索效率。
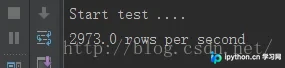
本文通过实测分析Python标准库logging模块在机械磁盘上的写入性能,发现单进程每秒约写入2800-3000行日志,此时磁盘IO已饱和。针对多进程场景,提出按PID分离日志文件并合并的方案,指出多进程无法突破IO瓶颈,高性能场景需引入缓存或分布式日志系统。
本文针对2.9G大文件逐行读取场景,对比Python四种常见读取方式。测试环境为i7-6820HQ及32G内存。结果显示:readlines()内存飙升但速度较快;readline()内存稳定但耗时最长;直接迭代fh最快且内存低;fileinput模块最慢。推荐大文件处理使用直接迭代方式,兼顾效率与内存安全。
本文深入探讨 Python 性能优化的多种技术路径,涵盖 Cython、IPython.parallel、numexpr、multiprocessing、Numba 及 NumbaPro 等工具的应用场景。通过对比列表推导、迭代器、eval、生成器及 map 函数的执行效率,并结合 NumPy 数组的 C 与 Fortran 内存布局测试,揭示不同实现方式在时间与空间复杂度上的显著差异,为开发者提供具体的性能调优参考。
本文详解Python中列表去重的三种实现方式。首先介绍利用内置set类型快速去重但丢失顺序的方法;其次展示不使用set的遍历判断法,分析其在大数据量下的性能瓶颈;最后推荐结合set与列表的混合方案,利用哈希查找优势在保持顺序的同时大幅提升大列表处理效率,并附带相关代码示例与性能对比数据。
本文详细解析Python中字符串连接的三种常用方法:加号(+)、join()及字符串格式化。通过Python 2.7在CentOS环境下的实测数据,对比了不同数量字符串连接时的性能差异。结果显示,连接少量字符串时加号效率更高,而大量字符串拼接则join方法优势明显,为开发者提供选型依据。
本文深入解析Python中二分查找算法的原理与实现,对比递归与循环方式的性能差异。重点介绍bisect模块如何高效维护有序列表,并详细对比其与numpy.searchsorted在普通列表与大型数组场景下的执行效率,为开发者提供实用的性能优化建议。
本文通过实验揭示Python中del语句并不真正释放内存,而是归还给内存池。只有通过显式调用gc.collect()才能强制回收对象。文章对比了不同环境下的内存消耗峰值与实时状态,指出在多线程或特定场景下gc的触发时机可能受系统可用内存影响,建议结合del与gc.collect()以优化脚本内存表现。