

Django模板碎片缓存优化:自定义标签实现按需加载

本文深入探讨Django模板碎片缓存的性能瓶颈,指出常规方式需视图层预取数据导致冗余。通过实现自定义模板标签,引入回调函数机制,实现缓存数据的按需获取与渲染解耦。该方法避免了视图层重复代码,提升了内存利用率,并提供了完整的代码实现示例及IDE兼容性说明。
前言
本文主要介绍如何优化Django中的模板碎片缓存机制。对于Django模板碎片缓存的基础用法,读者可参考相关文档。接下来将直接进入核心内容的详细解析。
起步
Django的缓存框架内置了模板片段缓存功能,其基本语法如下:
{% load cache %}
{% cache 500 sidebar %}
 .. sidebar ..
{% endcache %}
然而,使用这种模板缓存机制时,必须确保每次渲染都将所需的变量(如sidebar)传递给模板。否则,当缓存过期后,该片段将呈现为空白状态。因此,通常需要在视图函数中预先获取这些数据:
def test_view(request):
 # code...
 sidebar = get_data()
 return render(reqeust, 'test_view.html', {'sidebar': sidebar})
如果数据获取过程耗时较长,这种碎片缓存的效果将大打折扣,几乎形同虚设。
低级缓存
采用低级缓存API可以有效解决数据获取耗时的问题,实现方式如下:
from django.core.cache import cache
def get_data():
 key = 'hot-course'
 result = cache.get(key)
 if result:
 return result
 # 比较耗时的数据获取
 result = Course.objects.filter().order_by('-fav_num')[:10]
 cache.set(key, result, 600) # 保存至缓存
 return result
这种方式通常能解决数据来源耗时的痛点。一旦使用了低级缓存,往往不再需要模板碎片缓存,因为内存中会同时存在原始数据和渲染后的HTML代码两份缓存,造成资源浪费。内存资源应集中用于关键场景,同时维护两套缓存机制也显得不够优雅。
即便使用这种底层API,仍需将数据传递至视图层。若该数据属于公共部分(如轮播图模块),并被其他模板通过include引入,则其他视图函数也必须各自获取一次数据并传递给模板。这将导致大量重复代码。
是否存在一种更优的解决方案来处理这种情况?
优雅的改进碎片缓存
改进后的碎片缓存应具备按需获取数据的能力,最好无需视图层介入。这一需求可通过自定义标签实现。在实现自定义缓存标签之前,需要构建一个通用的缓存工具,允许传入数据获取函数作为回调。这部分逻辑与Django源码中的django.templatetags.CacheNode类类似,此处仅展示差异部分:
class UserCacheNode(Node):
 """
 优雅的自定义模板碎片缓存
 """
 def __init__(self, nodelist, expire_time_var, fragment_name, vary_on, cache_name, fun=None):
 # ...
 self.fun = fun # 用于数据获取的回调函数

 def render(self, context:dict):
 # ...
 if value is None:
  if self.fun: # 实行回调
  context.update(self.fun(*vary_on))
  value = self.nodelist.render(context)
  fragment_cache.set(cache_key, value, expire_time) # 保存至缓存
 return value
接下来制作自定义标签:
def get_hot_course():
 # 做会调用,函数返回字典
 print("call hot course")
 hot_courses = Course.objects.filter().order_by('stu_nums')[:5]
 return locals()

@register.tag('hot_course_cache') # 自定义的标签名称
def hot_course_cache(parser, token):
 nodelist = parser.parse(('endcache',))
 parser.delete_first_token()
 tokens = token.split_contents()
 cache_name = None

 return UserCacheNode(
 nodelist, parser.compile_filter(tokens[1]),
 tokens[2], # fragment_name can't be a variable.
 [parser.compile_filter(t) for t in tokens[3:]],
 cache_name,
 fun=get_hot_course, # 回调函数
 )
在模板中即可按如下方式使用:
{% load course_tag %}
{% hot_course_cache 500 hot_courses %}
 ...hot_courses...
{% endcache %}
通过自定义标签方式,无需视图层参与,其使用方式与Django内置的cache标签相似。由于是自定义标签,部分IDE可能会发出警告,例如我的开发环境所示:
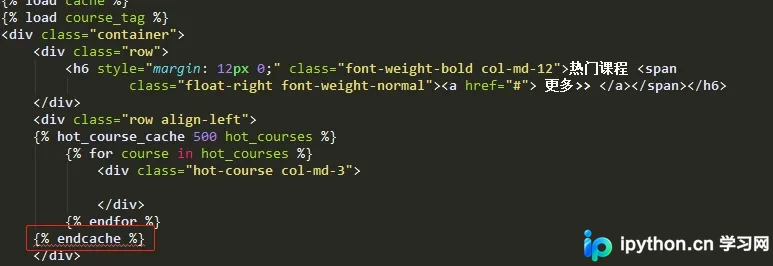
尽管IDE存在警告,但实际运行并无问题。这可能是因为当前IDE对自定义标签的支持度尚不完善。
参考
Django's cache framework
Custom template tags and filters
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









