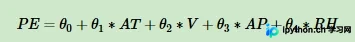Python Pandas中iloc、loc与icol选取特定列及行切片的详细用法
本文详解Python Pandas库中利用iloc、loc及icol选取特定列与行的方法。通过对比标签索引与位置索引的区别,解析切片操作后返回Series与DataFrame类型的差异,并演示多列数值计算的注意事项,帮助开发者避免常见类型错误。
2026-10-13
7

本文详解Python Pandas库中利用iloc、loc及icol选取特定列与行的方法。通过对比标签索引与位置索引的区别,解析切片操作后返回Series与DataFrame类型的差异,并演示多列数值计算的注意事项,帮助开发者避免常见类型错误。
本文详细介绍如何使用 pandas 的 drop 函数删除 DataFrame 中的指定行或列。通过设置 axis 参数区分操作对象,并重点讲解 inplace 参数在原地修改数据时的应用,同时提及不同 pandas 版本中参数用法的差异及注意事项。
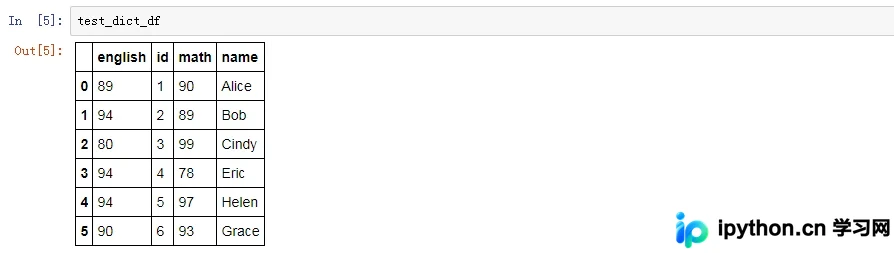
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文详解在pandas中读取CSV文件时如何查看和修改各列的数据类型。通过对比Numpy的dtype与Pandas的dtypes,介绍使用astype、to_numeric及infer_objects等方法进行类型转换的技巧,包括处理无效值和批量转换多列的实用方案。
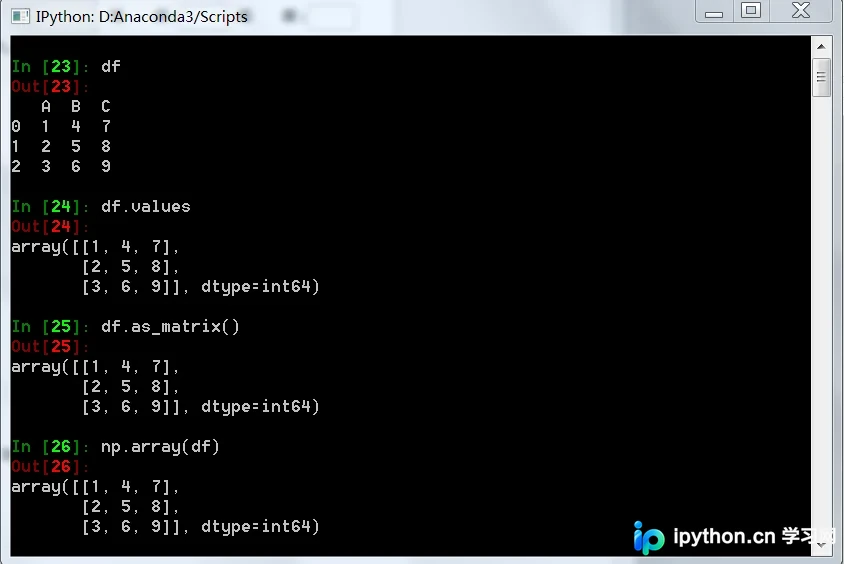
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
本文深入解析pandas中的Series数据类型,涵盖由列表、NumPy数组及字典创建Series的多种方法。详细阐述Series的索引机制、与数组的区别,以及shape、index、values等核心属性。同时介绍非空值过滤、name属性设置及isnull/notnull等常用操作,帮助开发者高效掌握Series数据结构。
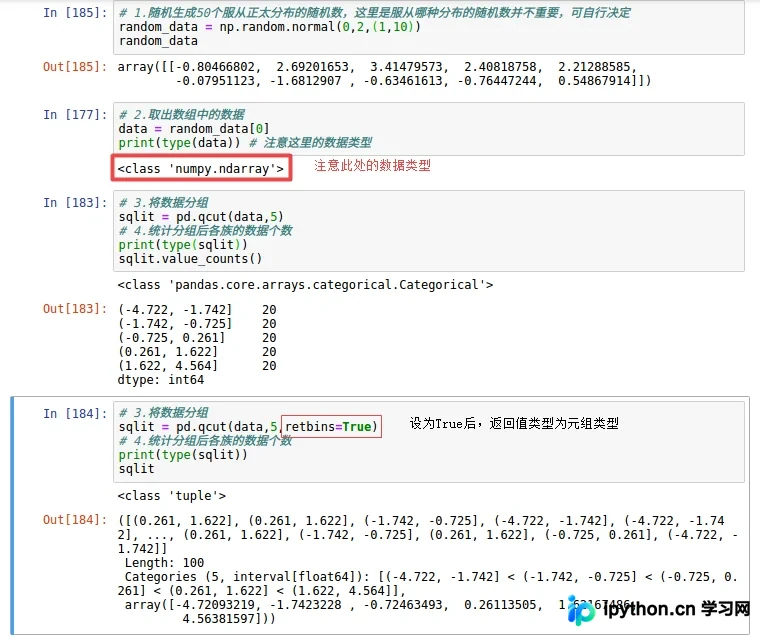
本文详细介绍pandas库中qcut()函数的用法,包括如何按分位数对数据进行分组、自定义标签及处理边界情况。同时对比qcut与cut的核心区别:qcut按组数自动计算区间,cut需指定具体区间边界。
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
本文介绍如何使用Python的Pandas库生成指定范围内的日期列表。通过pd.date_range函数,可以灵活设置起始与结束日期,并自定义频率参数(如天、月等)。示例展示了如何将日期对象转换为字符串格式,适用于数据分析和时间序列处理场景。
本文介绍如何使用Python pandas库创建DataFrame,并通过指定列名列表调整列的显示顺序。同时演示如何将默认从0开始的索引(index)修改为从1开始,适用于需要特定数据展示格式的场景。
本文通过UCI循环发电厂数据集,演示如何使用pandas读取数据,并利用scikit-learn进行线性回归建模。内容涵盖数据预处理、特征选择、训练集与测试集划分、模型拟合、系数获取,以及通过MSE和RMSE评估模型性能,最后结合交叉验证与可视化分析优化模型效果。