

Python Pandas交叉表(crosstab)与分组汇总实战
本文详细介绍Python中Pandas库的交叉表(crosstab)功能,涵盖其语法参数、默认频数统计及自定义聚合。同时深入解析如何利用groupby结合apply和cut函数,手动构建复杂的交叉分组表,适用于离散数据的统计汇总场景。
2026-10-14
7

本文详细介绍Python中Pandas库的交叉表(crosstab)功能,涵盖其语法参数、默认频数统计及自定义聚合。同时深入解析如何利用groupby结合apply和cut函数,手动构建复杂的交叉分组表,适用于离散数据的统计汇总场景。
本文详细介绍如何使用Python通过pymysql库连接MySQL数据库。内容涵盖环境安装、连接参数配置、利用pandas read_sql及游标cursor两种方式读取数据,以及插入、更新、删除等事务处理与结果获取方法,帮助开发者快速实现数据库交互。
本文介绍pandas中常用的参数设置方法,包括通过pd.set_option()控制最大显示行数、列数及列宽,利用chop_threshold隐藏小数值,以及浮点数格式化和精度调整。同时讲解如何使用option_context进行临时参数修改,帮助开发者灵活优化数据展示效果。
本文详解如何在Python中将Excel导入的数字日期转换为标准日期格式。通过实验确定Excel日期基准日为1899-12-30,利用pandas读取数据并修改列名,结合datetime库计算偏移量。提供完整代码示例,解决Excel时间戳导致的日期显示异常问题,适用于数据清洗与自动化处理场景。
本文详细介绍pandas库中DataFrame.drop_duplicates函数的使用方法,重点解析subset、keep和inplace三个核心参数的具体含义与配置选项。通过实际代码示例,演示如何指定列进行去重、保留首尾重复项或完全删除重复数据,帮助开发者高效处理数据清洗中的重复值问题。
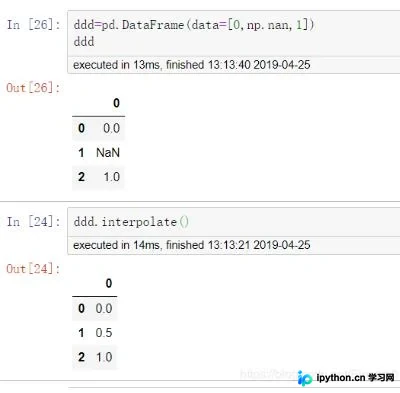
本文介绍如何利用Python的Pandas库处理数据中的缺失值。通过df.interpolate()函数实现线性插值,根据前后已知数值按比例填充中间的空缺,例如在0和1之间填充0.5或0.33、0.67,从而保持数据趋势的连续性。
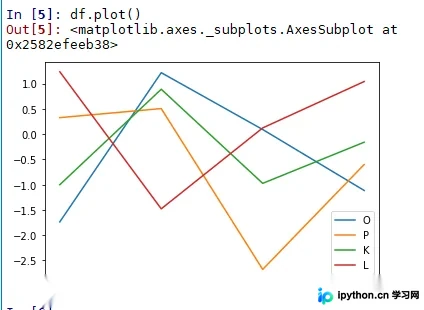
本文深入解析 pandas 库中 DataFrame.plot() 函数的核心参数与用法。详细讲解如何配置图形类型(折线、条形、散点等)、子图布局及坐标轴设置,并指出散点图需传入双Y列的关键细节。同时提供在 Jupyter Notebook 与脚本环境中创建画布、子图及显示图形的标准流程,帮助开发者高效实现数据可视化。
本文介绍了如何使用Python的pymysql库连接MySQL数据库,并通过pandas库将查询结果转换为DataFrame对象。文章提供了完整的代码示例,展示了从建立连接、执行SQL查询到关闭连接的完整流程,以及如何遍历和访问DataFrame中的元素。
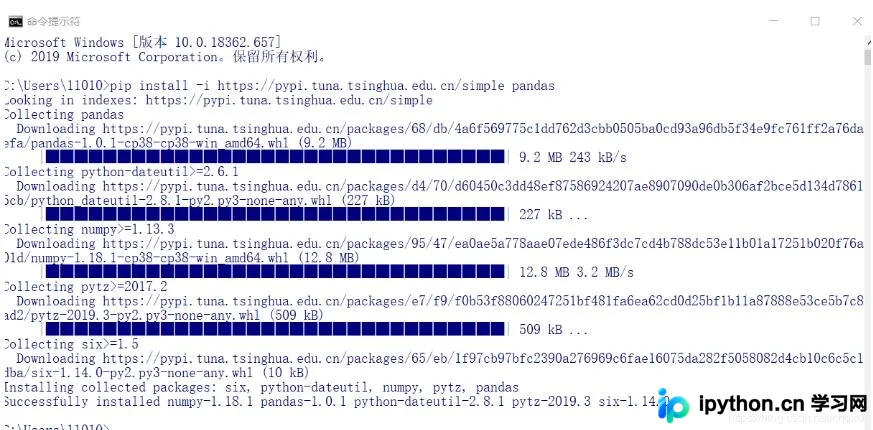
本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
本文详细介绍如何使用Python的pandas库读取CSV文件,通过指定列条件筛选特定数据行,并将结果保存为新的CSV文件。教程涵盖从导入库、读取文件、处理DataFrame结构到执行筛选逻辑及导出文件的完整步骤,适合初学者参考。
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。