

使用scikit-learn和pandas实现线性回归的完整教程

本文通过UCI循环发电厂数据集,演示如何使用pandas读取数据,并利用scikit-learn进行线性回归建模。内容涵盖数据预处理、特征选择、训练集与测试集划分、模型拟合、系数获取,以及通过MSE和RMSE评估模型性能,最后结合交叉验证与可视化分析优化模型效果。
线性回归实战概述
对于希望深入理解线性回归原理与应用的读者,本文提供了一个完整的实战案例。通过完整学习本例,您将掌握使用scikit-learn运行线性回归模型及其评估方法的核心流程。
数据获取与问题定义
1. 获取数据,定义问题
机器学习研究离不开数据支撑。本例采用UCI大学公开库中的机器学习数据集进行线性回归分析。
数据集的具体介绍可参考:http://archive.ics.uci.edu/ml/datasets/Combined+Cycle+Power+Plant
数据下载链接为:http://archive.ics.uci.edu/ml/machine-learning-databases/00294/
该数据集包含一个循环发电场的运行数据,共计9568个样本。每个样本包含5列数据,分别为:AT(温度)、V(压力)、AP(湿度)、RH(压强)以及PE(输出电力)。在初步分析阶段,无需过度纠结于各变量的物理含义。
我们的目标是建立PE(样本输出)与AT、V、AP、RH这4个特征之间的线性关系。机器学习的核心任务即构建线性回归模型,其数学表达为:
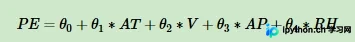
PE=θ 0 +θ 1 ∗AT+θ 2 ∗V+θ 3 ∗AP+θ 4 ∗RH 需要学习的参数即为\(\theta_0, \theta_1, \theta_2, \theta_3, \theta_4\)这5个系数。
数据整理与预处理
2. 整理数据
下载后的数据为压缩文件,解压后可见一个xlsx文件。首先使用Excel打开该文件,选择“另存为”并保存为csv格式,后续将使用此csv文件进行线性回归运算。
检查该csv文件可知,数据已整理完毕,无非法值,因此无需进行额外的数据清洗或预处理。尽管数据未进行归一化(即未转化为均值0、方差1的格式),但scikit-learn在线性回归计算过程中会自动处理归一化步骤,无需手动操作。
准备好csv格式的数据后,即可开始后续的建模工作。
使用pandas读取数据
3.用pandas来读取数据
建议打开ipython notebook并新建一个notebook文件。虽然可以直接在Python交互式命令行中操作,但使用notebook更为推荐。以下示例及输出均在notebook环境中运行。
首先声明需要导入的库:
import matplotlib.pyplot as plt
%matplotlib inline
import numpy as np
import pandas as pd
from sklearn import datasets, linear_model
随后使用pandas库读取数据:
# read_csv里面的参数是csv在你电脑上的路径,此处csv文件放在notebook运行目录下面的CCPP目录里
data = pd.read_csv('.\CCPP\ccpp.csv')
验证数据读取是否成功:
#读取前五行数据,如果是最后五行,用data.tail()
data.head()
运行结果应显示如下数据,若看到该输出,说明pandas读取数据成功:
| AT | V | AP | RH | PE | |
|---|---|---|---|---|---|
| 0 | 8.34 | 40.77 | 1010.84 | 90.01 | 480.48 |
| 1 | 23.64 | 58.49 | 1011.40 | 74.20 | 445.75 |
| 2 | 29.74 | 56.90 | 1007.15 | 41.91 | 438.76 |
| 3 | 19.07 | 49.69 | 1007.22 | 76.79 | 453.09 |
| 4 | 11.80 | 40.66 | 1017.13 | 97.20 | 464.43 |
特征与目标变量准备
4.准备运行算法的数据
查看数据的维度信息:
data.shape结果显示为(9568, 5),表明共有9568个样本,每个样本包含5列数据。
接下来准备样本特征X,选取AT、V、AP和RH这4列作为特征变量。
X = data[['AT', 'V', 'AP', 'RH']]
X.head()
查看X的前五条输出如下:
| AT | V | AP | RH | |
|---|---|---|---|---|
| 0 | 8.34 | 40.77 | 1010.84 | 90.01 |
| 1 | 23.64 | 58.49 | 1011.40 | 74.20 |
| 2 | 29.74 | 56.90 | 1007.15 | 41.91 |
| 3 | 19.07 | 49.69 | 1007.22 | 76.79 |
| 4 | 11.80 | 40.66 | 1017.13 | 97.20 |
接着准备样本输出y,选取PE作为目标变量。
y = data[['PE']]
y.head()
查看y的前五条输出如下:
| PE | |
|---|---|
| 0 | 480.48 |
| 1 | 445.75 |
| 2 | 438.76 |
| 3 | 453.09 |
| 4 | 464.43 |
训练集与测试集划分
5. 划分训练集和测试集
将X和y的样本组合划分为两部分:训练集和测试集,具体代码如下:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=1)
查看训练集和测试集的维度:
print X_train.shape
print y_train.shape
print X_test.shape
print y_test.shape
运行结果如下:
(7176, 4) (7176, 1) (2392, 4) (2392, 1)
结果显示,75%的样本数据被用作训练集,25%的样本被用作测试集。
线性模型拟合与系数求解
6. 运行scikit-learn的线性模型
最后一步,使用scikit-learn的线性模型对问题进行拟合。scikit-learn的线性回归算法基于最小二乘法实现,代码如下:
from sklearn.linear_model import LinearRegression
linreg = LinearRegression()
linreg.fit(X_train, y_train)
拟合完成后,查看模型所需的系数结果:
print linreg.intercept_
print linreg.coef_
输出结果如下:
[ 447.06297099] [[-1.97376045 -0.23229086 0.0693515 -0.15806957]]
至此,我们获得了步骤1中需要求解的5个值。PE与其他4个变量的关系表达式如下:

模型评估与特征对比
7. 模型评价
评估线性回归模型的好坏,通常使用测试集上的均方差(Mean Squared Error, MSE)或均方根差(Root Mean Squared Error, RMSE)作为评价指标。
查看模型的MSE和RMSE,代码如下:
#模型拟合测试集
y_pred = linreg.predict(X_test)
from sklearn import metrics
# 用scikit-learn计算MSE
print "MSE:",metrics.mean_squared_error(y_test, y_pred)
# 用scikit-learn计算RMSE
print "RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred))
输出结果如下:
MSE: 20.0804012021 RMSE: 4.48111606657
获得MSE或RMSE后,若通过其他方法得到不同的系数,在模型选择时,应优先选择MSE较小值对应的参数。
例如,本次尝试仅使用AT、V、AP这3列作为样本特征,不再包含RH,输出仍为PE。代码如下:
X = data[['AT', 'V', 'AP']]
y = data[['PE']]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=1)
from sklearn.linear_model import LinearRegression
linreg = LinearRegression()
linreg.fit(X_train, y_train)
#模型拟合测试集
y_pred = linreg.predict(X_test)
from sklearn import metrics
# 用scikit-learn计算MSE
print "MSE:",metrics.mean_squared_error(y_test, y_pred)
# 用scikit-learn计算RMSE
print "RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred))
输出结果如下:
MSE: 23.2089074701 RMSE: 4.81756239919
可以看出,去掉RH后,模型拟合效果不如包含RH时好,MSE数值变大。
交叉验证与可视化分析
8. 交叉验证
可以通过交叉验证持续优化模型,代码如下。我们采用10折交叉验证,即cross_val_predict中的cv参数设置为10:
X = data[['AT', 'V', 'AP', 'RH']]
y = data[['PE']]
from sklearn.model_selection import cross_val_predict
predicted = cross_val_predict(linreg, X, y, cv=10)
# 用scikit-learn计算MSE
print "MSE:",metrics.mean_squared_error(y, predicted)
# 用scikit-learn计算RMSE
print "RMSE:",np.sqrt(metrics.mean_squared_error(y, predicted))
输出结果如下:
MSE: 20.7955974619 RMSE: 4.56021901469
可以看出,采用交叉验证模型的MSE比第6节的大,主要原因是这里对所有折的样本做测试集对应的预测值的MSE,而第6节仅仅对25%的测试集做了MSE。两者的先决条件并不同。
9. 画图观察结果
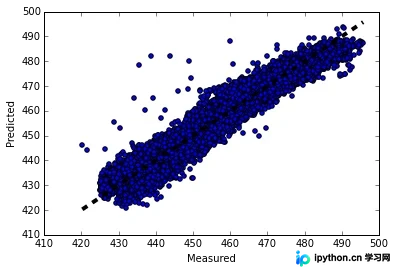
此处绘制真实值和预测值的变化关系图,离中间的直线y=x越近的点代表预测损失越低。代码如下:
fig, ax = plt.subplots()
ax.scatter(y, predicted)
ax.plot([y.min(), y.max()], [y.min(), y.max()], 'k--', lw=4)
ax.set_xlabel('Measured')
ax.set_ylabel('Predicted')
plt.show()
输出的图像如下:
完整的jupyter-notebook代码参看我的Github。
以上就是用scikit-learn和pandas学习线性回归的过程,希望可以对初学者有所帮助。也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









