

Python 3.x 使用 PyMySQL 连接 MySQL 数据库及 Pandas 读取方案
Python 3.x 已不再支持 MySQLdb,推荐使用 PyMySQL 库进行数据库交互。本文介绍了通过 pip3 install PyMySQL 安装库的方法,并展示了利用 pymysql 建立连接、执行 SQL 查询并将结果转换为 Pandas DataFrame 的完整代码示例,解决 No module named 'MySQLdb' 报错问题。
2026-10-13
7

Python 3.x 已不再支持 MySQLdb,推荐使用 PyMySQL 库进行数据库交互。本文介绍了通过 pip3 install PyMySQL 安装库的方法,并展示了利用 pymysql 建立连接、执行 SQL 查询并将结果转换为 Pandas DataFrame 的完整代码示例,解决 No module named 'MySQLdb' 报错问题。
本文详解Python中离散变量One-Hot编码的两种主流实现方式。通过对比pandas的get_dummies与sklearn的LabelEncoder结合OneHotEncoder,解析字符串与数值型变量的处理差异。文章包含具体代码示例,展示从数据导入、特征查看到编码生成的完整流程,帮助开发者根据数据类型选择合适方案。
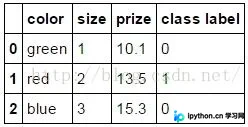
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。
本文介绍了如何使用pandas库将numpy数组高效转换为DataFrame并保存为CSV文件。通过示例代码展示了从迭代处理数据、构建numpy数组到最终调用to_csv方法保存文件的完整流程,适用于需要批量导出结构化数据的Python开发场景。
本文详解Python Pandas库中DataFrame的drop函数,用于删除指定的行或列。通过axis参数控制删除方向(0为行,1为列),并解释inplace参数对原数据的影响。提供代码示例展示如何删除指定索引的行或特定列,帮助开发者高效处理数据。
本文对比了Python中两种计算词频的方法。首先分析了通过自定义cut_word和union_dict函数结合Pandas apply与reduce进行字典合并的传统实现,指出其代码冗余问题。随后引入NLTK库的FreqDist方法,展示如何利用jieba分词后直接生成频率字典。通过去重拼接字符串的技巧,实现了更简洁高效的词频统计方案,适用于各类文本处理场景。
本文总结Pandas读取CSV文件时常见的OSError错误,主要原因为文件路径包含中文导致无法正确加载。提供两种解决方案:修改为全英文路径或在文件名前添加u前缀,推荐优先使用第一种方案以彻底避免编码问题。
本文详细介绍 Python 中 Pandas 库 DataFrame 对象的基础操作方法。内容涵盖如何基于列表、数组和字典创建 DataFrame,以及如何执行索引访问、行列求和、元素变换等常用计算。此外,文章还演示了通过 append 方法扩充行与列的具体步骤,并深入解析了使用 join 函数进行内连接、外连接等多种数据合并策略,帮助开发者高效掌握数据处理核心技能。
本文介绍如何使用pandas.DataFrame.to_json方法将数据框转换为JSON格式。重点讲解orient参数,特别是records选项如何实现按行转换,生成[{column -> value}, ...]格式的列表,适用于前端展示等场景。
本文介绍在PyCharm中使用pandas的plot()方法时无法显示图像的问题。通过添加plt.show()语句,可以正常渲染图表。该方法适用于Series和DataFrame对象的可视化操作,帮助开发者解决IDE环境下的绘图兼容性问题。
本文详细介绍如何使用Python结合cx_Oracle和Pandas库实现Oracle数据库的查询与插入操作,并解决编码乱码问题。同时提供基于exp命令和线程调度的数据库定时备份脚本示例,涵盖连接配置、SQL执行及异常处理等关键步骤。
本文介绍在pandas中选取特定索引行的方法。重点区分loc与iloc的使用场景:loc基于标签索引,适合按自定义索引值筛选;iloc基于整数位置,从0开始计数。通过示例演示如何避免常见错误,确保数据准确提取。