

pandas.qcut()方法详解与cut对比

本文详细介绍pandas库中qcut()函数的用法,包括如何按分位数对数据进行分组、自定义标签及处理边界情况。同时对比qcut与cut的核心区别:qcut按组数自动计算区间,cut需指定具体区间边界。
qcut()函数基本用法
pandas.qcut()函数可将数值型数据按分位数划分为指定数量的区间。
data = pd.Series([0,8,1,5,3,7,2,6,10,4,9])例如,将数据划分为两组,较小值标记为'small number',较大值标记为'large number'。
print(pd.qcut(data,[0,0.5,1],labels=['small number','large number']))
small numbers
  large numbers
  small numbers
  small numbers
  small numbers
  large numbers
  small numbers
  large numbers
  large numbers
  small numbers
  large numbers
dtype: category
Categories (2, object): [small numbers < large numbers]
qcut()函数的第二个参数用于定义区间的分割比例。若将数据分为两组,分割点为[0, 0.5, 1];若分为四组,分割点为[0, 0.25, 0.5, 0.75, 1]。分割点不必均匀分布,如[0, 0.1, 0.2, 0.3, 1]表示按1:1:1:7的比例分布。
data = pd.Series([0,8,1,5,3,7,2,6,10,4,9])
print(pd.qcut(data,[0, 0.1, 0.2, 0.3, 1],labels=['first 10%','second 10%','third 10%','70%']))
first 10%
      70%
   first 10%
      70%
   third 10%
      70%
  second 10%
      70%
      70%
      70%
     70%
dtype: category Categories
(4, object): [first 10% < second 10% < third 10% < 70%]
由于数据包含11个元素,无法完全按照1:1:1:7的比例精确分配,因此部分值(如0和1)被归入'first10%'类别。
qcut()函数的第三个参数用于指定替换后的标签值,其顺序需与区间定义保持一致。标签数量必须与区间数量严格相等,不能多也不能少。
qcut与cut的区别
qcut与cut的主要区别在于分组依据:
qcut:传入参数为组数,即数据被划分为多少组,具体的区间边界由算法自动计算得出。
cut:传入参数为具体的区间边界(bins),即分组依据是预先定义的数值范围。
qcut参数详解
qcut方法参考链接:http://pandas.pydata.org/pandas-docs/stable/generated/pandas.qcut.html
1).参数:pandas.qcut(x,q,labels=None,retbins=False,precision=3,duplicates='raise')
>>>x:待分组的数据,数据类型为一维数组或Series对象。
>>>q:组数,即将数据划分为几组,后续示例将详细说明。
>>>labels:组标签,注意标签的数量必须与组数相等。
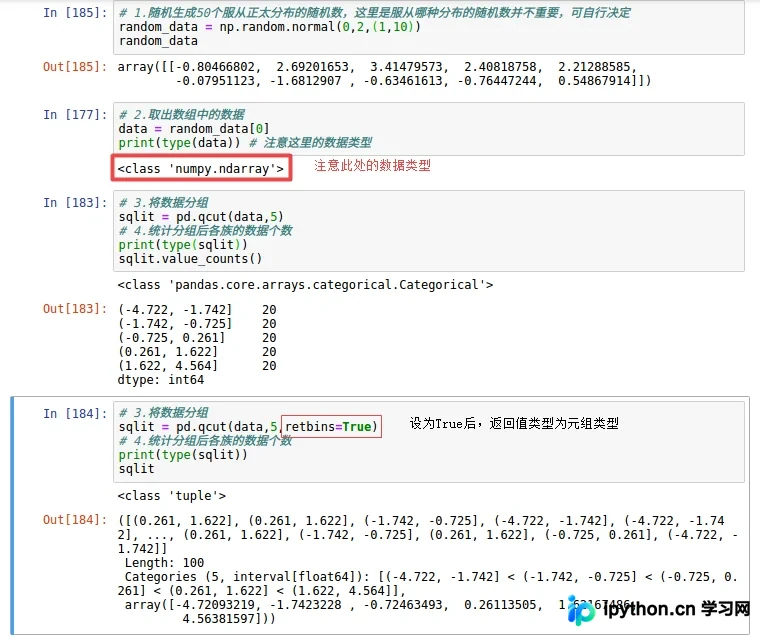
>>>retbins:默认为False,此时返回值为Categorical类型(支持value_counts()方法);若设为True,返回值则为元组。
2).示例
cut方法参数说明
2.cut方法,官网链接:http://pandas.pydata.org/pandas-docs/stable/generated/pandas.cut.html
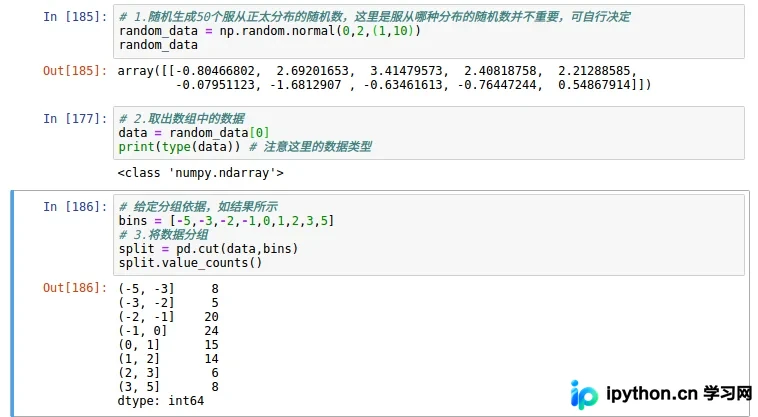
1).参数:pandas.cut(x,bins,right=True,labels=None,retbins=False,precision=3,include_lowest=False,duplicates='raise')
2).示例
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









