

Python 3.7 结合 Excel 与 Pandas 实现二维码文件自动归类
本文介绍如何使用 Python 3.7 版本,结合 os 和 shutil 库进行文件操作,利用 Pandas 读取 Excel 中的门店与大区对应关系。通过 VLOOKUP 匹配逻辑,程序自动将二维码图片文件按所属小区名称分类并移动至指定文件夹,实现批量自动化管理。
2026-10-13
7

本文介绍如何使用 Python 3.7 版本,结合 os 和 shutil 库进行文件操作,利用 Pandas 读取 Excel 中的门店与大区对应关系。通过 VLOOKUP 匹配逻辑,程序自动将二维码图片文件按所属小区名称分类并移动至指定文件夹,实现批量自动化管理。
本文详细介绍如何使用Python连接MongoDB数据库,涵盖建立连接、基础查询、条件过滤(AND/OR)、字段选择、排序、分页、去重及结果导出至Excel等核心操作。通过具体代码示例,帮助开发者快速掌握MongoDB在Python环境下的基本应用技巧。
本文详解如何使用Python和Pandas库构建基于Item的简易推荐系统。通过加载MovieLens数据集,利用pivot_table生成用户-电影评分矩阵,并计算电影间的Pearson相关系数。文章涵盖数据清洗、阈值设定以过滤低评分数量电影,以及通过计算相似度进行电影推荐的具体代码实现与结果分析。
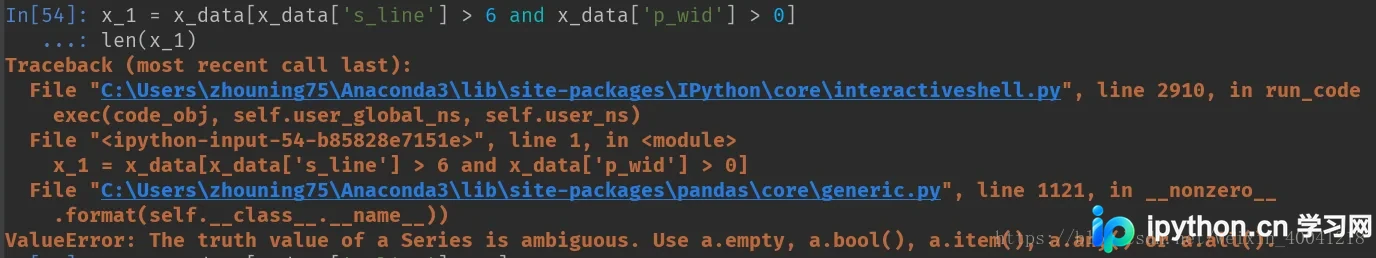
本文详解Python中(&, |)与(and, or)两组运算符的区别。数值变量下,前者执行位运算,后者依据非零值返回结果;逻辑变量下两者行为一致。重点指出在Pandas DataFrame多条件筛选时,必须使用&和|进行元素级逻辑运算,若误用and/or会引发ValueError。
本文详解Python Pandas库中利用iloc、loc及icol选取特定列与行的方法。通过对比标签索引与位置索引的区别,解析切片操作后返回Series与DataFrame类型的差异,并演示多列数值计算的注意事项,帮助开发者避免常见类型错误。
本文详细介绍如何使用 pandas 的 drop 函数删除 DataFrame 中的指定行或列。通过设置 axis 参数区分操作对象,并重点讲解 inplace 参数在原地修改数据时的应用,同时提及不同 pandas 版本中参数用法的差异及注意事项。
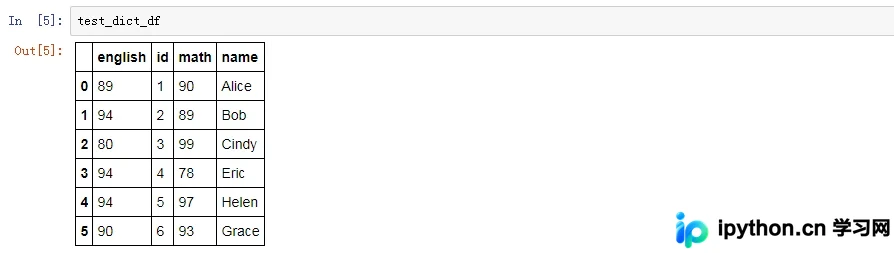
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文详解在pandas中读取CSV文件时如何查看和修改各列的数据类型。通过对比Numpy的dtype与Pandas的dtypes,介绍使用astype、to_numeric及infer_objects等方法进行类型转换的技巧,包括处理无效值和批量转换多列的实用方案。
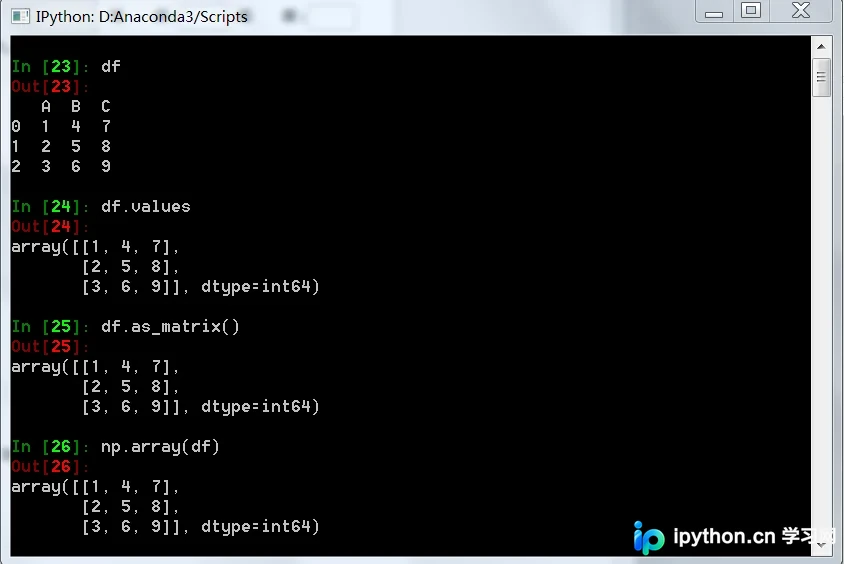
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
本文深入解析pandas中的Series数据类型,涵盖由列表、NumPy数组及字典创建Series的多种方法。详细阐述Series的索引机制、与数组的区别,以及shape、index、values等核心属性。同时介绍非空值过滤、name属性设置及isnull/notnull等常用操作,帮助开发者高效掌握Series数据结构。
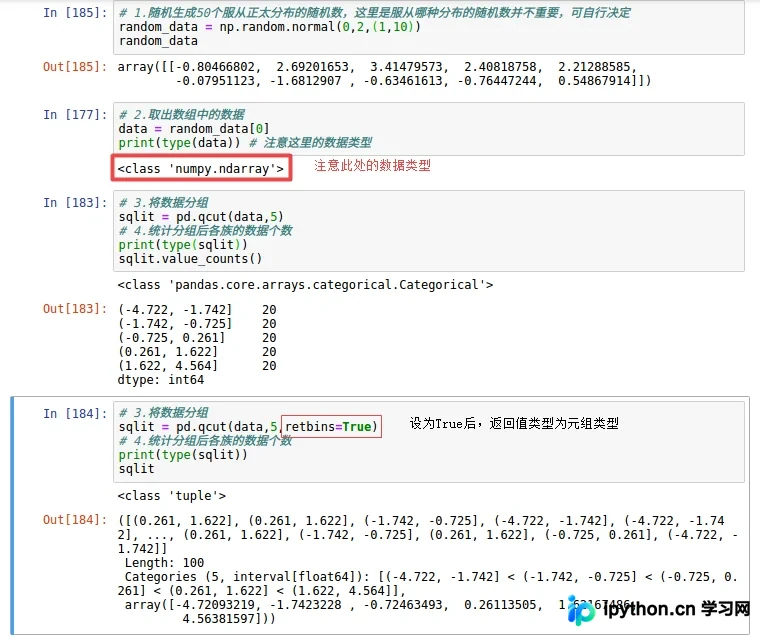
本文详细介绍pandas库中qcut()函数的用法,包括如何按分位数对数据进行分组、自定义标签及处理边界情况。同时对比qcut与cut的核心区别:qcut按组数自动计算区间,cut需指定具体区间边界。
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。