PyCharm调试技巧:利用断点与__main__高效排查Python代码
本文介绍如何在PyCharm中高效使用调试功能。通过创建包含算法模块的KNN.py及主程序main.py,重点讲解在main.py中利用__name__ == '__main__'构建测试入口,并在KNN.py中设置断点。启动Debug模式后,程序将自动进入断点,支持单步执行以观察具体运行步骤,从而快速定位并解决代码问题。
2026-10-13
6

本文介绍如何在PyCharm中高效使用调试功能。通过创建包含算法模块的KNN.py及主程序main.py,重点讲解在main.py中利用__name__ == '__main__'构建测试入口,并在KNN.py中设置断点。启动Debug模式后,程序将自动进入断点,支持单步执行以观察具体运行步骤,从而快速定位并解决代码问题。
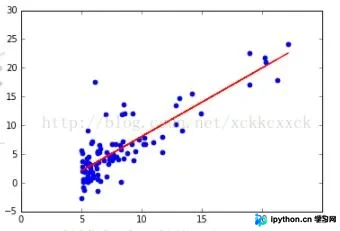
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。
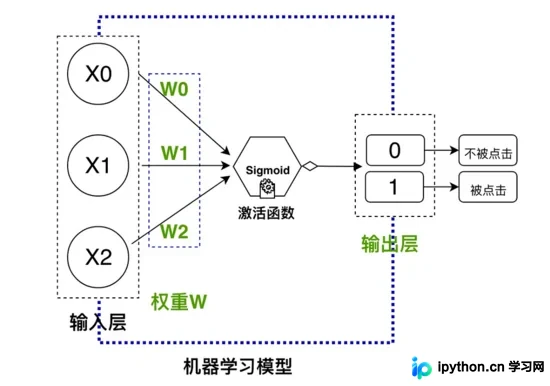
本文从零开始,仅使用Python基础库NumPy构建一个极简的前馈神经网络(即单层逻辑回归),用于解决微博点击率预估问题。通过解析数据预处理、Sigmoid激活函数、前向传播及反向传播权重更新等核心步骤,帮助初学者深入理解监督学习中分类模型的训练原理与代码实现。
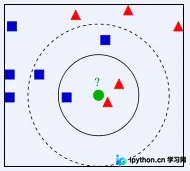
本文深入解析Python中KNN(K近邻)分类算法的核心原理,包括距离计算、K值选择及K-D Tree与Ball-Tree优化策略。通过身高体重数据集的完整代码示例,展示如何使用scikit-learn实现分类,并详细解读准确率、混淆矩阵及决策边界可视化结果,帮助开发者掌握该基础且强大的分类模型。
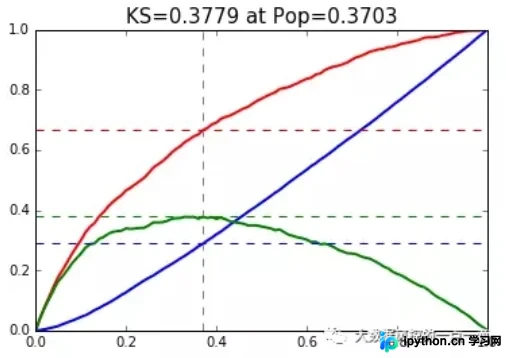
本文详细介绍如何使用Python绘制KS曲线以评估模型区分能力。通过提供完整的PlotKS函数代码,展示如何根据预测分数和标签计算累计分布,并生成包含KS值的可视化图表。该方法适用于信用评分及二分类模型的性能分析,帮助开发者直观理解模型表现。
本文详解Python中sklearn库的One-Hot编码技术。阐述将离散特征映射至欧式空间以优化距离计算的原理,并通过具体代码示例解析OneHotEncoder的使用,包括fit与transform方法的输出结果及维度分析,帮助开发者掌握特征预处理技巧。
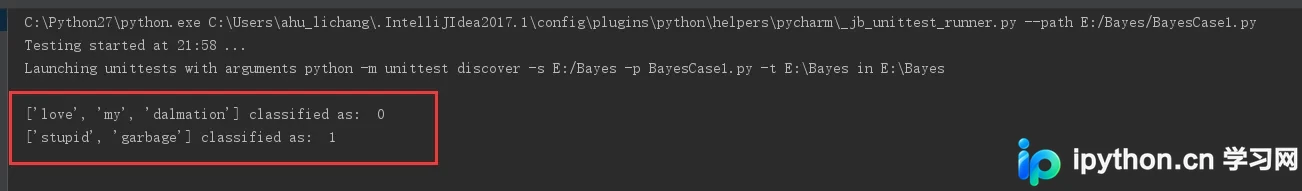
本文详细解析了朴素贝叶斯分类器的数学原理及Python实现方法。从贝叶斯定理出发,推导先验概率、后验概率与似然度的关系,并介绍算法流程。通过具体示例演示如何计算条件概率,最后提供完整的Python类封装代码及Matlab实现对比,帮助开发者掌握该算法的核心逻辑与应用。
本文深入解析朴素贝叶斯分类算法的核心原理,包括条件概率独立性假设与贝叶斯公式应用。通过电商评论情感分析案例,演示从特征提取到概率计算的完整流程,并提供Python代码实现,帮助开发者掌握该算法在文本分类中的实际使用方法。
本文详细介绍Python决策树中基于信息增益的特征选择方法。通过计算数据集的信息熵与条件熵,量化特征划分带来的信息增益,从而筛选最优特征。文中包含熵与信息增益的定义、具体计算流程,以及基于海洋生物数据的完整Python代码示例和运行结果分析,帮助开发者理解并应用该核心算法。
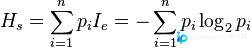
本文详细介绍Python机器学习库scikit-learn的安装步骤及基础应用。涵盖NumPy、SciPy等依赖配置,演示数据加载、归一化、特征选择与提取流程,并实战朴素贝叶斯、k近邻及决策树算法,帮助开发者快速上手数据挖掘与分析。
本文解析Python中利用for循环结合列表推导式创建列表的语法。通过机器学习实战中的featList与classList生成示例,详细说明了如何从数据集中提取特定元素(如第i列或最后一列)并构建新列表。同时提供了基础的平方数生成案例,展示该语法在简化代码、提升效率方面的实际应用价值。
本文深入解析Python数据分析的八大核心第三方库。涵盖Pandas的高效数据处理、Numpy的底层数组运算、Matplotlib的可视化绘图,以及SciPy、Scikit-Learn、Keras、Scrapy和Gensim在科学计算、机器学习、爬虫和自然语言处理中的应用,助您构建完整的数据分析技术栈。