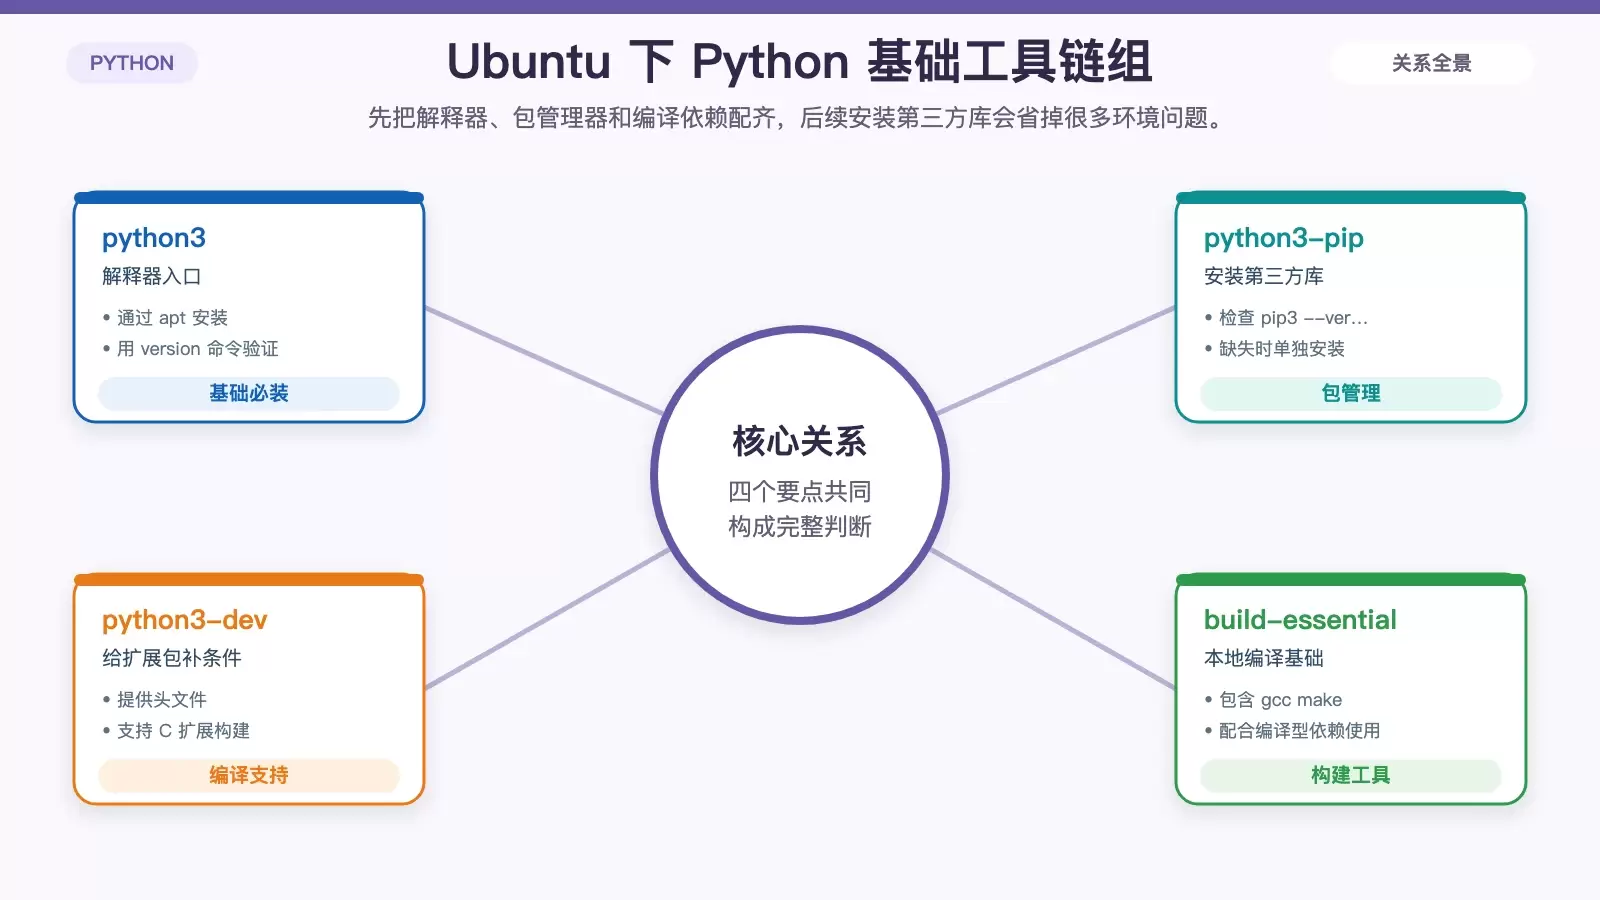
Ubuntu 下如何安装 Python 开发工具:从基础环境到多版本管理
在 Ubuntu 上做 Python 开发,关键不是只装上解释器,而是把编译工具、虚拟环境和依赖管理一起配齐。本文按“基础安装、环境隔离、常用库、依赖复现、多版本管理”五步整理,适合从零搭建,也适合检查现有环境是否完整。
2026-08-24
160

在 Ubuntu 上做 Python 开发,关键不是只装上解释器,而是把编译工具、虚拟环境和依赖管理一起配齐。本文按“基础安装、环境隔离、常用库、依赖复现、多版本管理”五步整理,适合从零搭建,也适合检查现有环境是否完整。
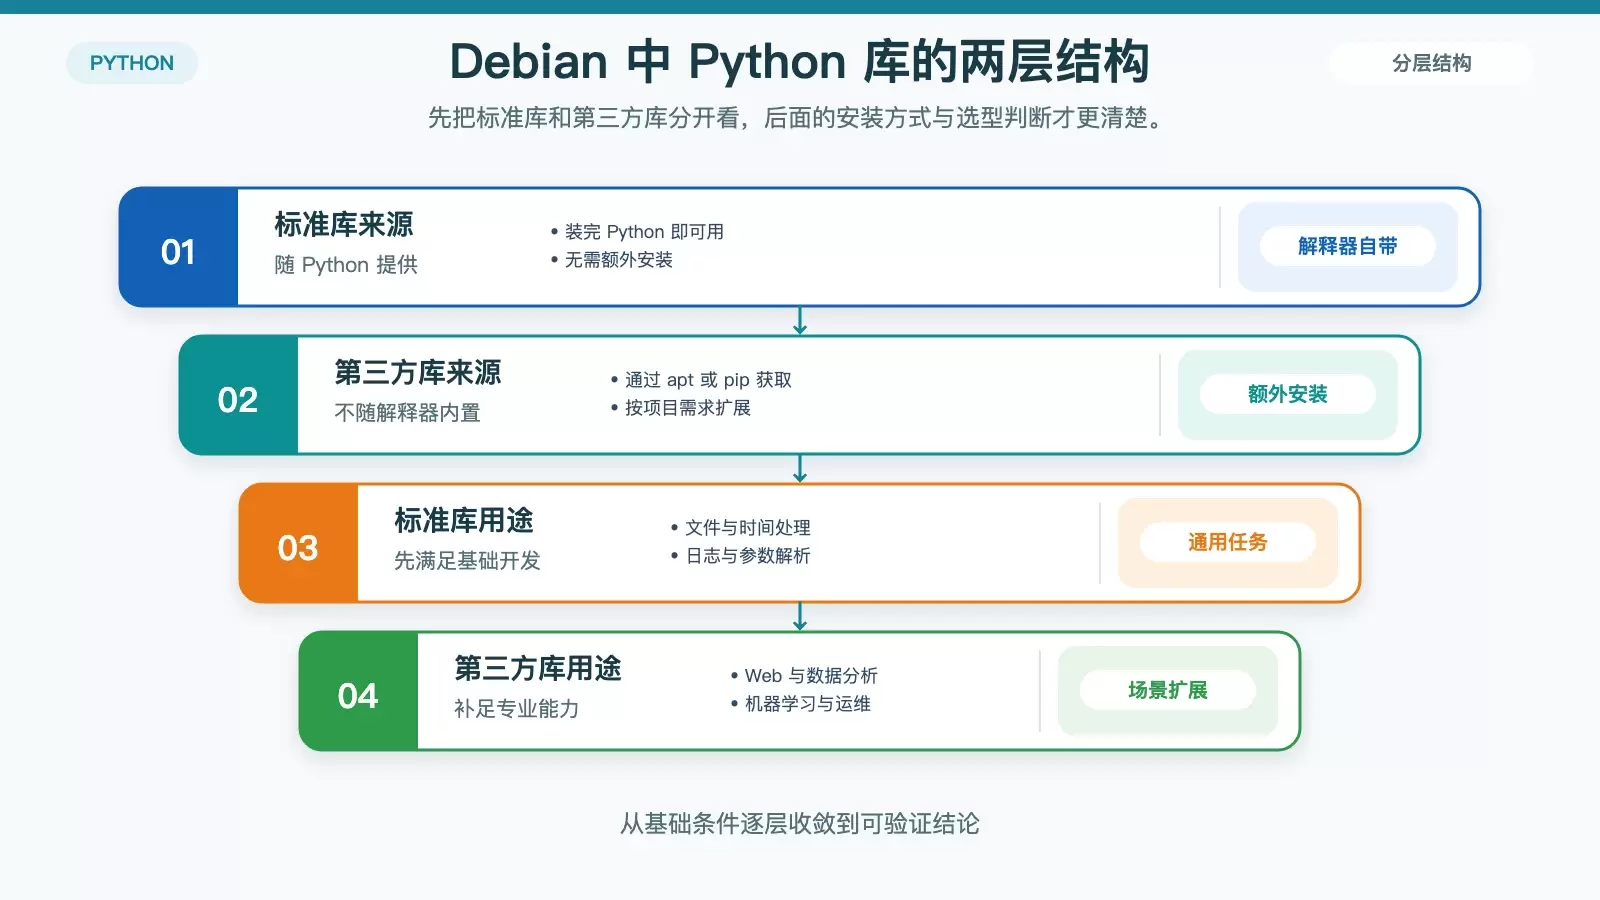
Debian 里的 Python 库大致分为两类:安装 Python 后即可使用的标准库,以及通过 apt 或 pip 额外安装的第三方库。理解两者的边界、适用场景和安装方式,能帮助你在开发、运维和数据处理时更稳妥地选库与管理环境。
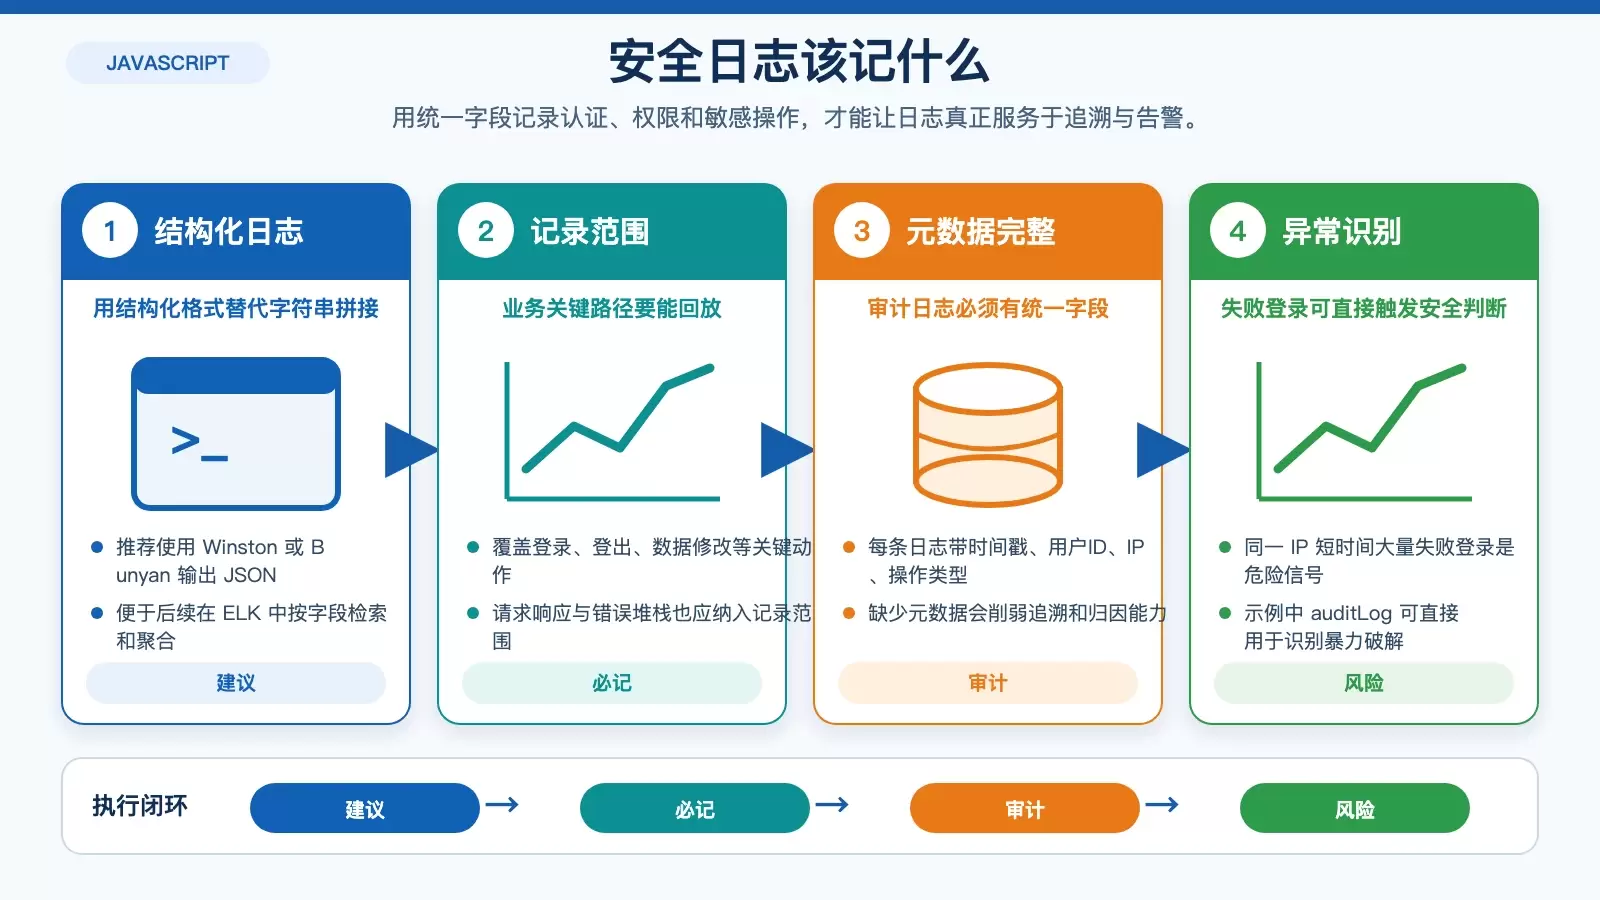
这篇文章围绕 Debian 上的 Node.js 应用日志安全展开,梳理了 8 个可直接落地的方向:从结构化记录、关键事件审计,到轮转清理、集中分析、实时告警和权限保护。重点不是“多记日志”,而是让日志真正具备溯源、预警和配合防护策略的能力。
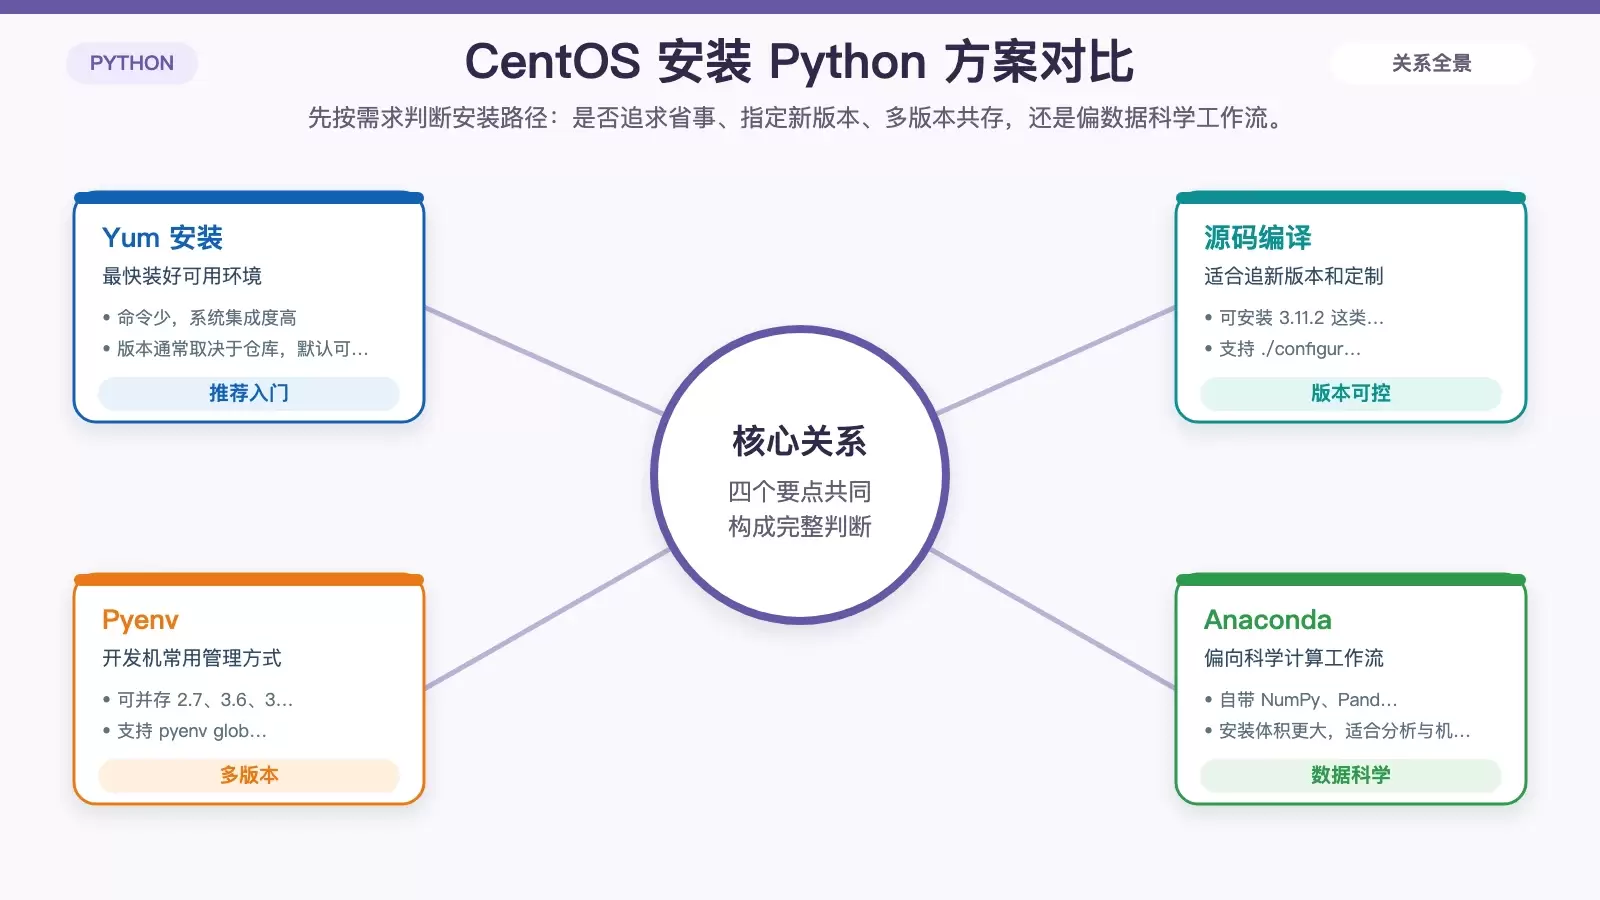
在 CentOS 上安装 Python 不只是一条路。用 Yum 最省事,源码编译适合追新版本,Pyenv 适合多版本共存,Anaconda 则更偏数据科学。关键不在“能不能装上”,而在于选对方法并避免覆盖系统自带 Python。 CentOS 上安装 Python 不只是执行一条命令那么简单,选错方式可能会遇到版本受限、多环境冲突,甚至误伤系统自带解释器。
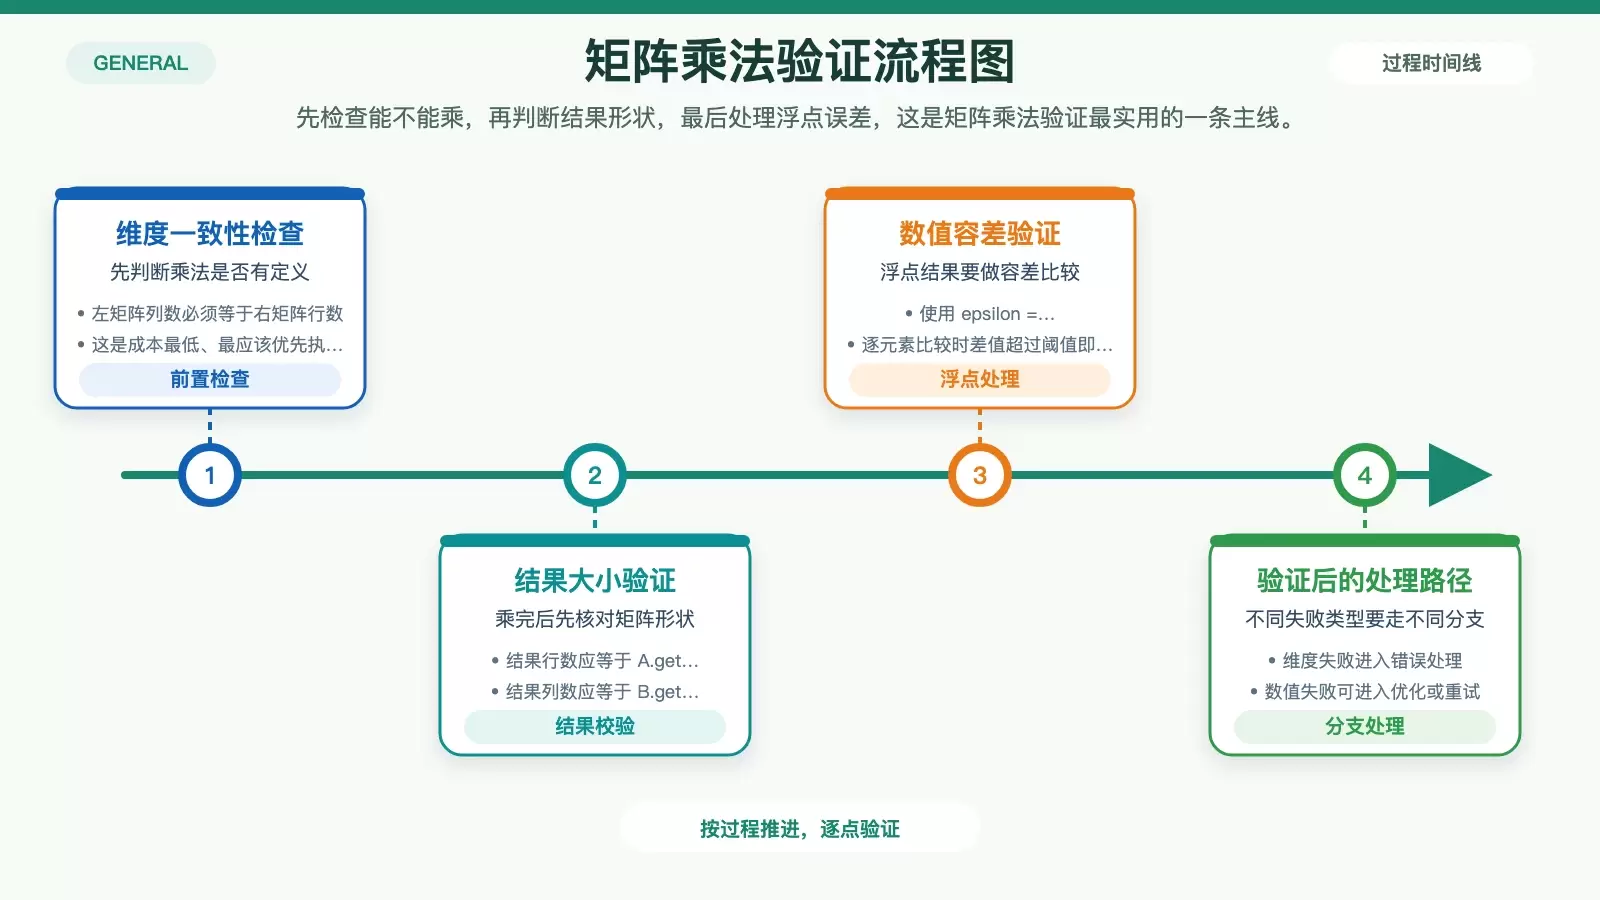
本文围绕“怎样确认矩阵乘法结果是对的”展开,梳理了 C++ 中常见的验证思路:先做维度检查,再核对结果尺寸,最后用数值容差处理浮点误差。同时结合基础实现、模板优化与 OpenMP 并行写法,说明验证逻辑应放在哪些环节。
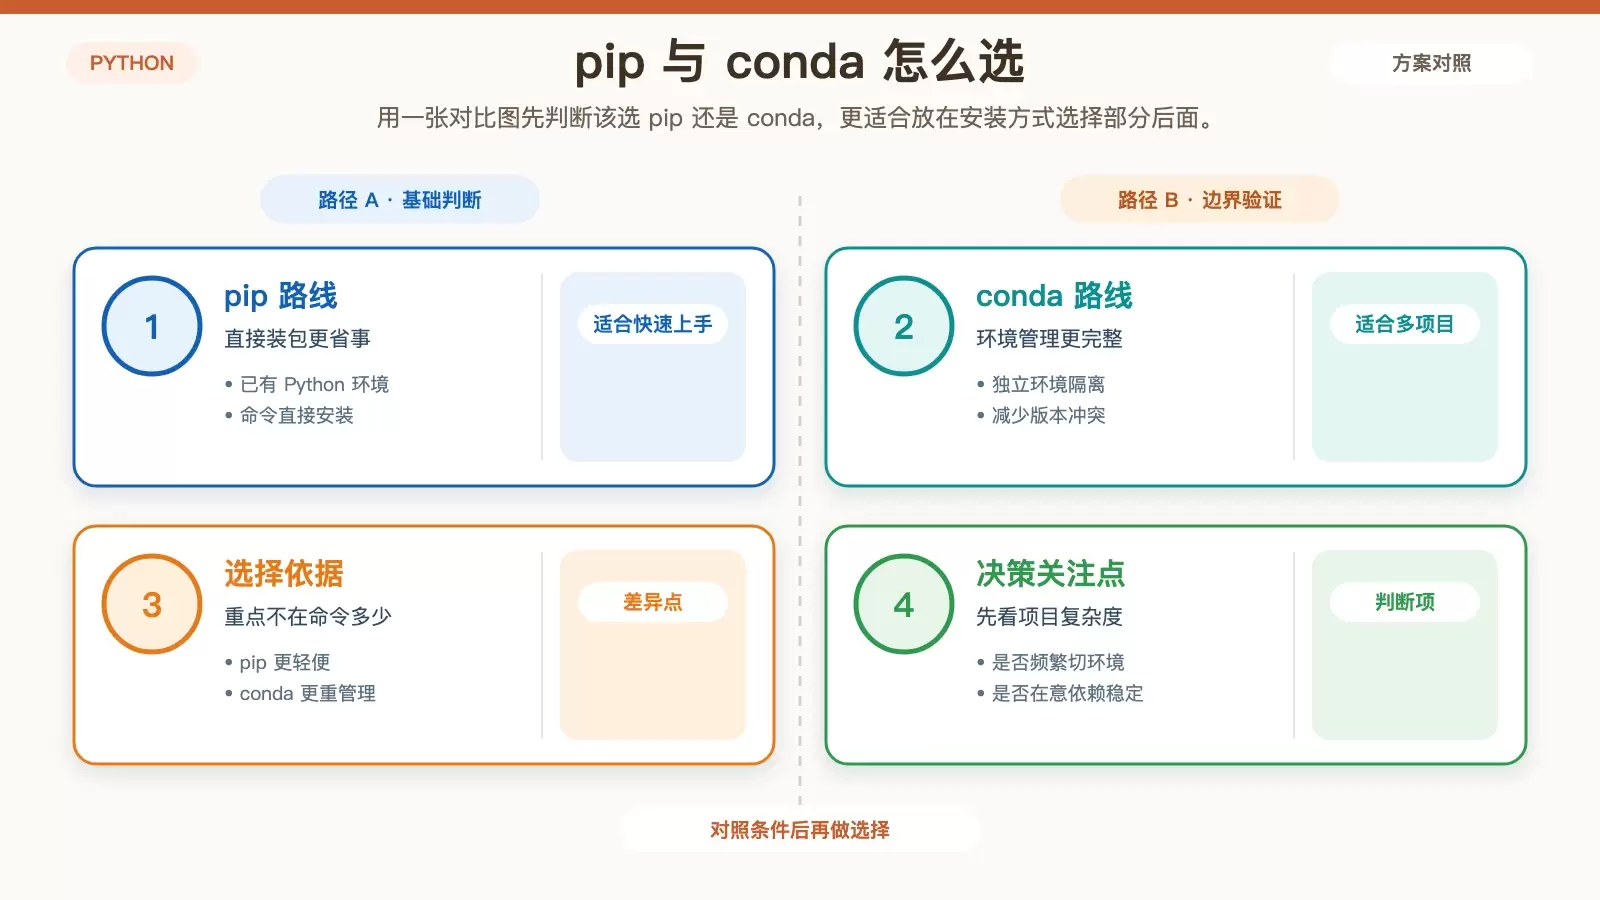
在 Debian 上安装 Python 机器学习库,核心通常就是选 `pip` 还是 `conda`。前者轻便直接,适合已有 Python 环境的用户;后者更强调环境隔离,适合需要控制依赖版本的项目。本文按两条安装路径整理常用命令,并补上 CUDA、权限和基础依赖等关键注意点。
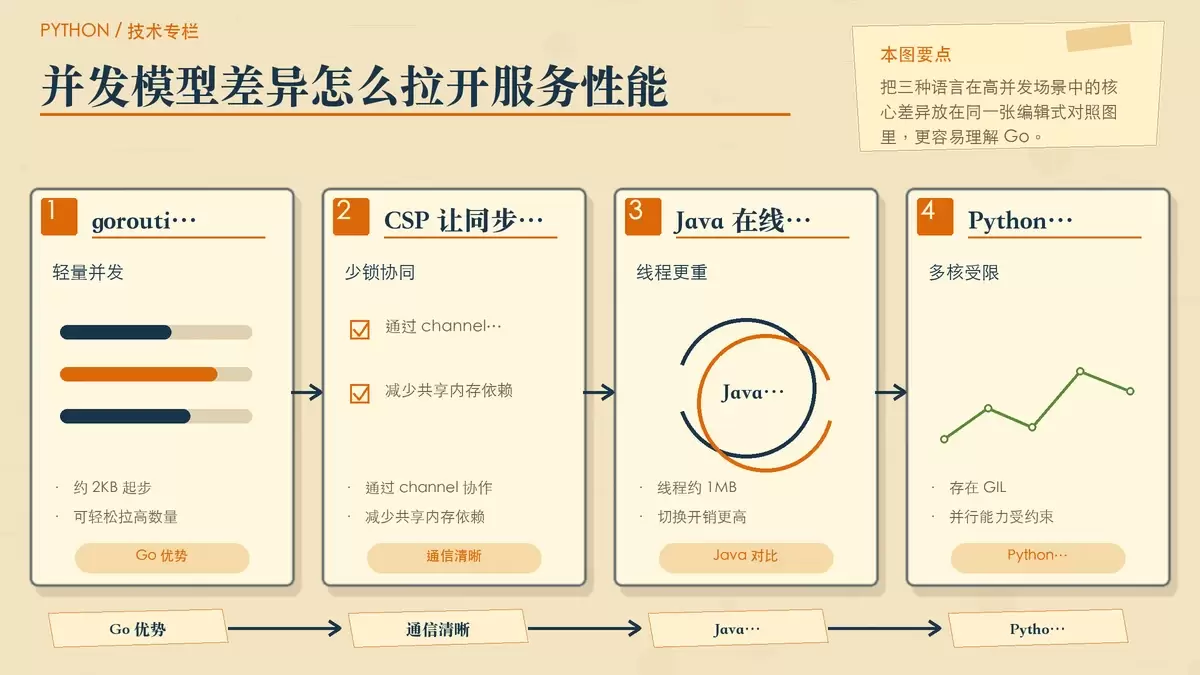
Go 在分布式系统里的优势,不只是“更快”这么简单。它真正拉开差距的地方在于并发模型、资源占用、启动速度以及云原生部署体验。和 Java、Python 对比后,可以更清楚判断:什么时候该优先选 Go,什么时候仍该保留其他语言。
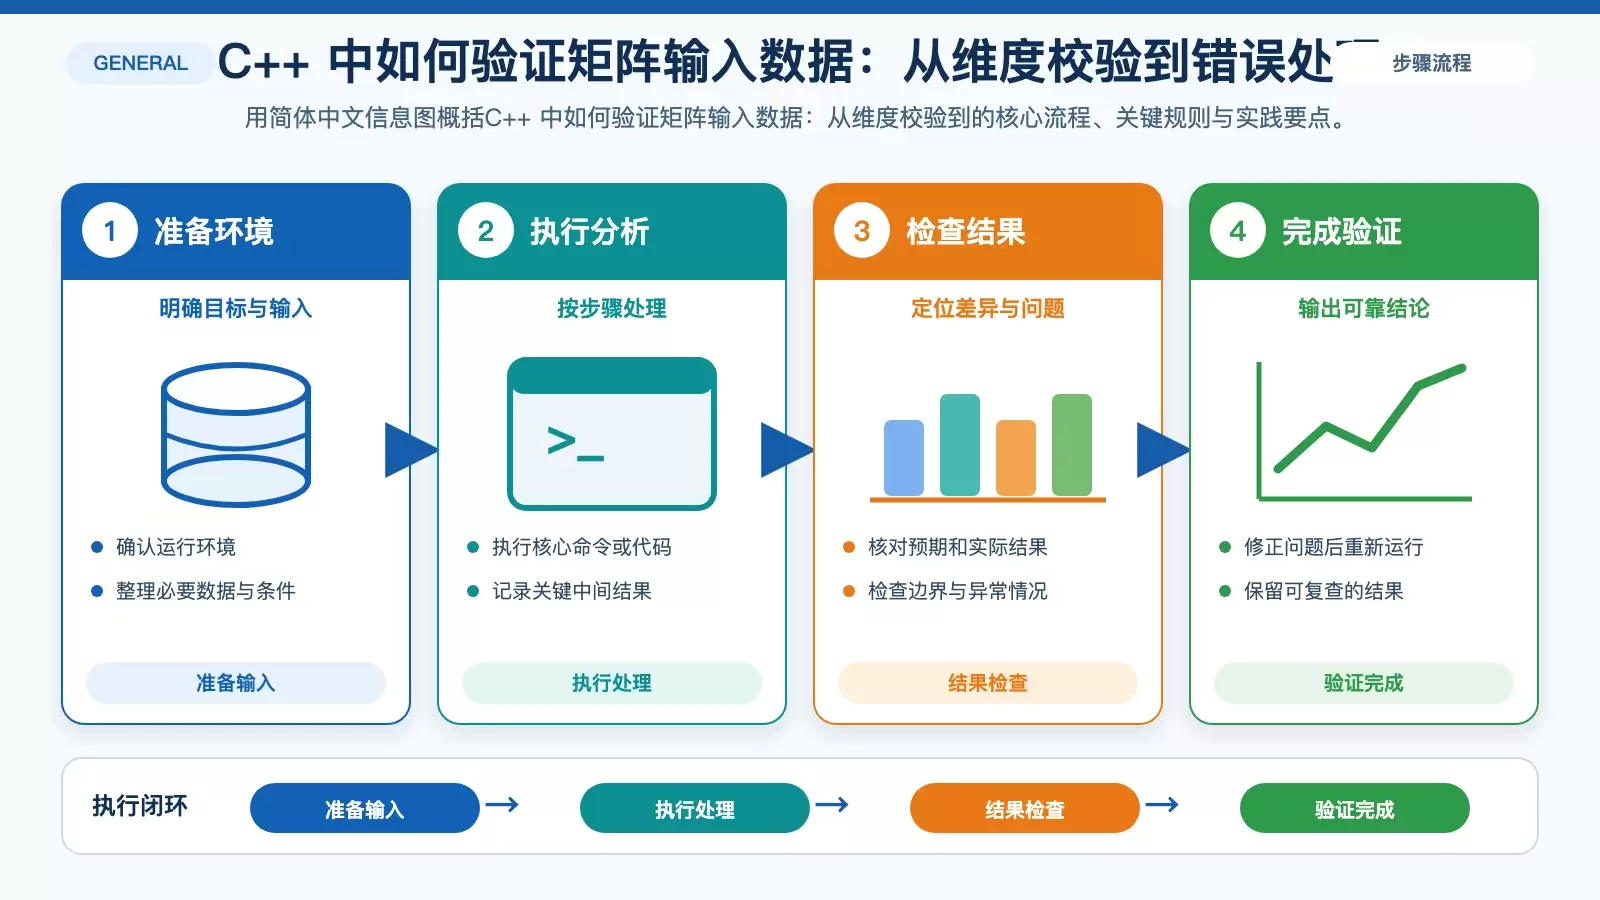
矩阵输入看起来只是把二维数据读进程序,真正影响结果可靠性的却是后面的验证与报错设计。本文用 C++ 示例梳理矩阵输入、维度和值范围校验,以及异常、错误码和日志三类错误处理方式,帮助你把“能读入”升级成“能稳定处理”。
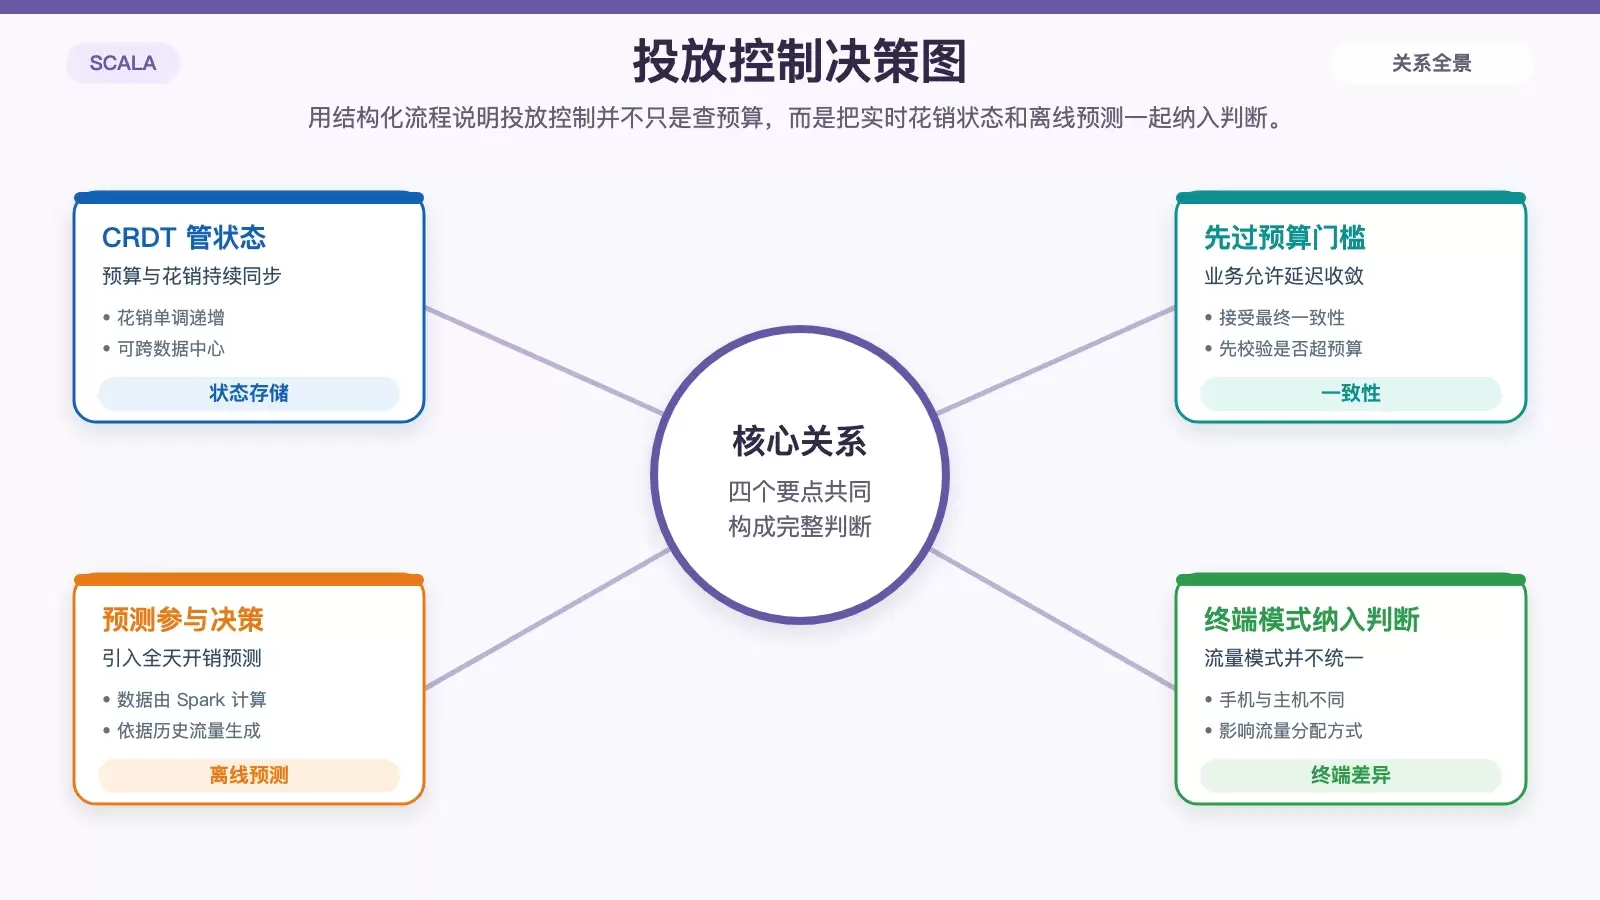
这篇文章聚焦广告请求流程中的后半段:投放控制、搜集出价、视频转码、竞价求解和结果渲染。核心看点不是单点技术,而是 Scala 与 akka-stream、Akka Distributed Data、gRPC 等组件如何协同,把高并发广告系统拆成可控、可隔离、可优化的处理链路。
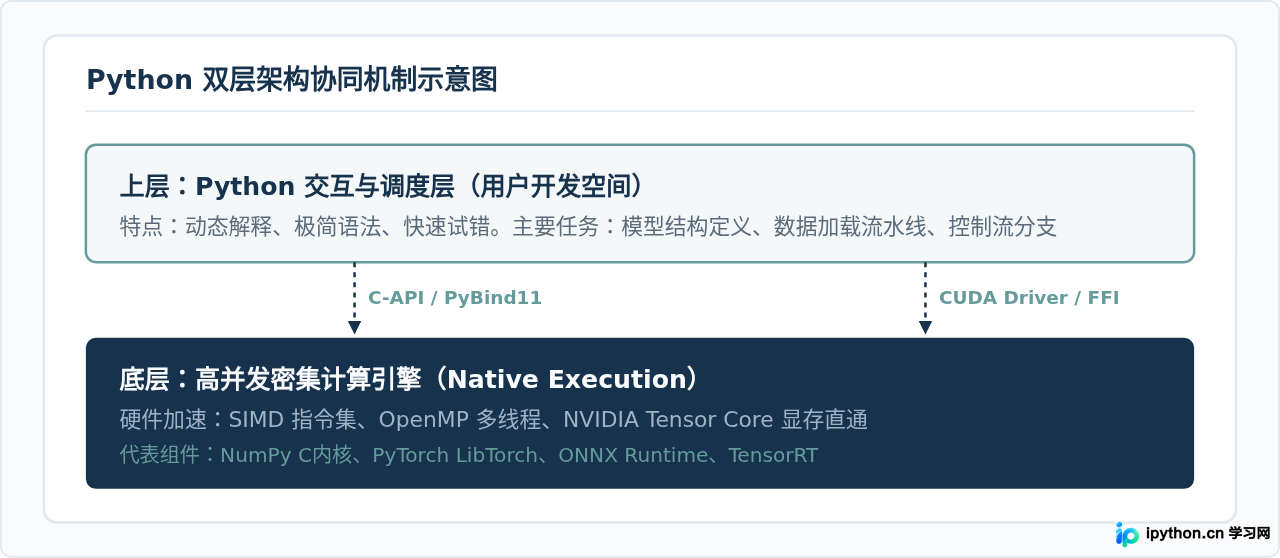
深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
本文详细解析Python中numpy.argmax()函数的用法。通过一维、二维及三维数组的示例,深入讲解axis参数(0和1)如何影响最大值索引的返回结果。该函数在机器学习分类结果获取及精确度计算中应用广泛,帮助开发者准确理解数组维度的变化与索引对应关系。
从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。